AI 口型同步视频生成器
选一张脸,加上声音,就能得到口型字字对上的视频。输入脚本、上传你自己的音频,或直接在浏览器里录制——VisionStory 会将口型、表情与头部动作同步到你听到的每一句。
开始口型同步选一张脸,加上声音,就能得到口型字字对上的视频。输入脚本、上传你自己的音频,或直接在浏览器里录制——VisionStory 会将口型、表情与头部动作同步到你听到的每一句。
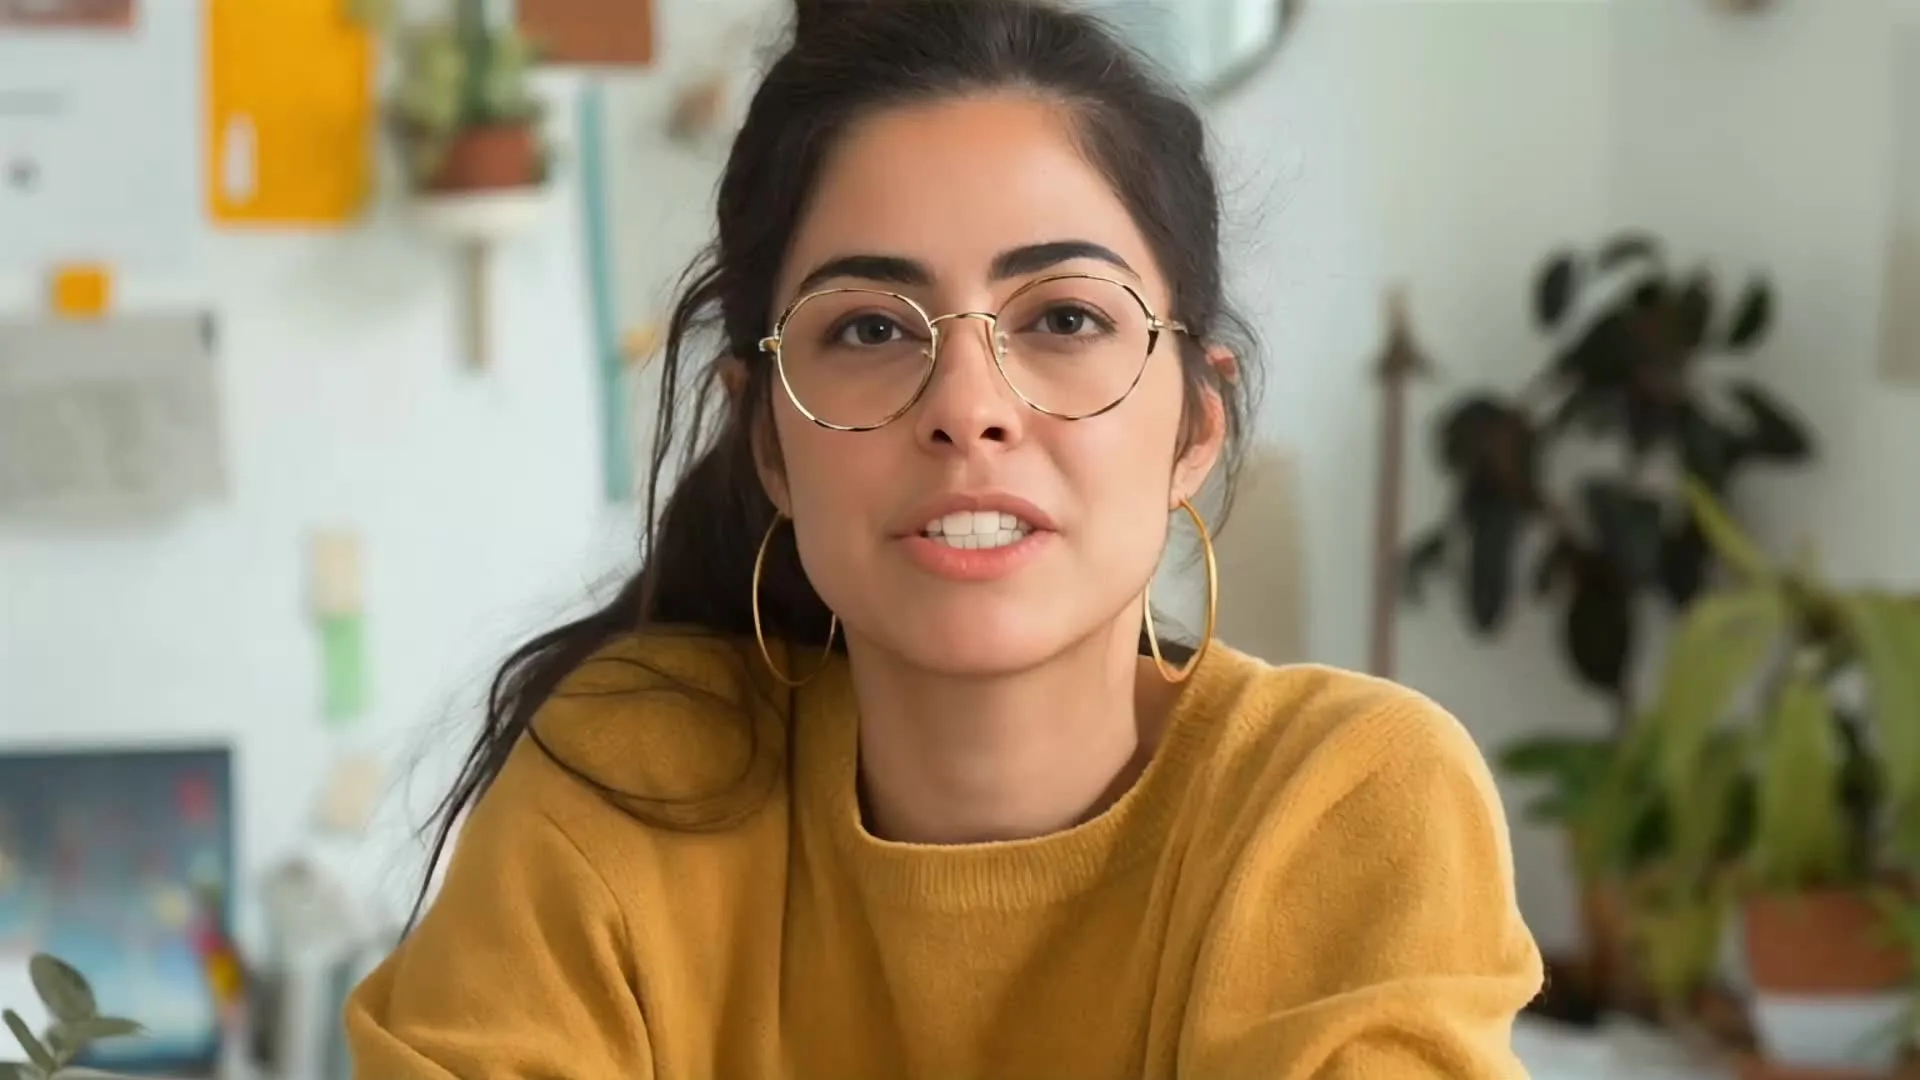
开始口型同步打开声音。上方的同一张人像将带来一段 15 秒的课程开场——口型、停顿与表情都会跟随声音变化。
音频输入
从你已有的音频开始——或者只用几行文字从零开始。
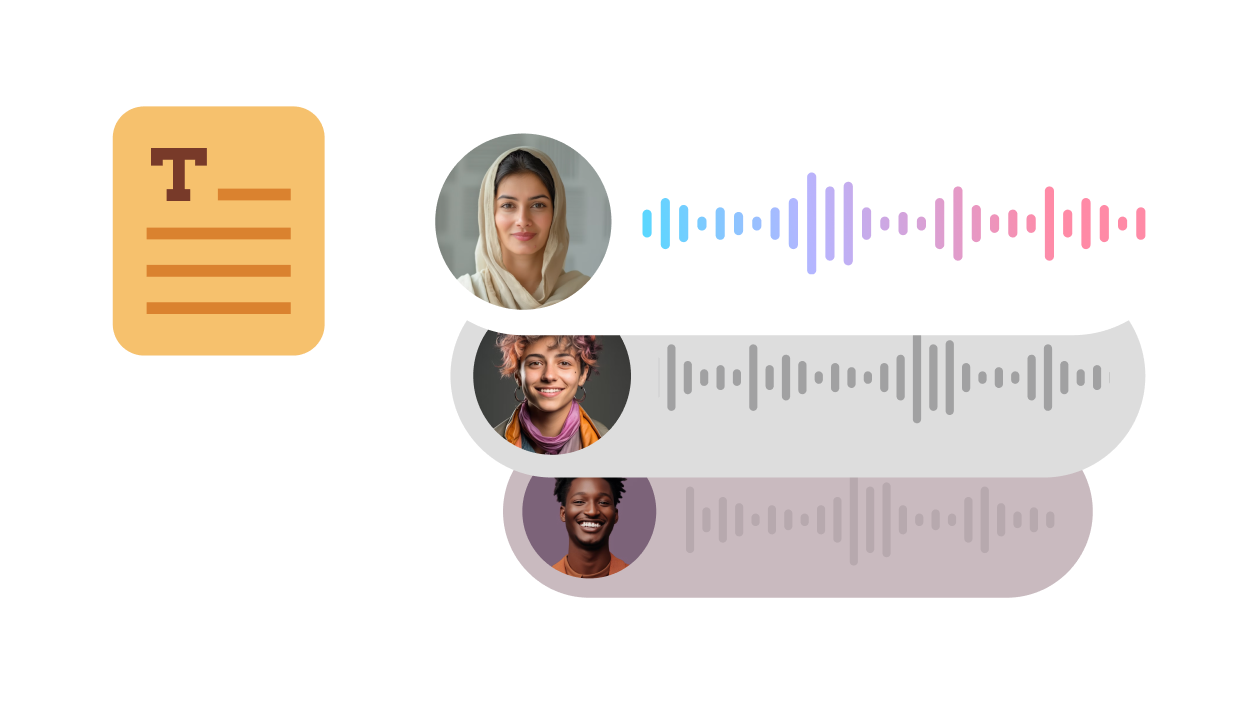
写下角色要说的话,从 88 种语言的 1,000+ AI 音色中挑选一个,口型就会跟随生成语音同步变化。
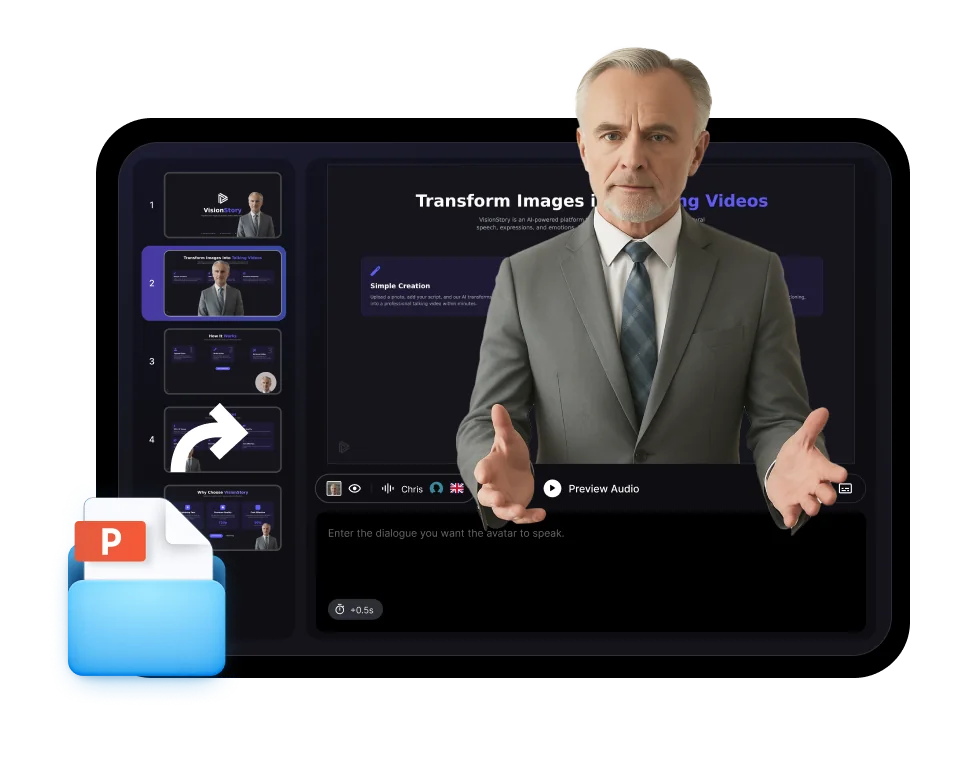
导入配音、播客片段、采访回答或歌曲,让人脸与这段原始录音精确同步。
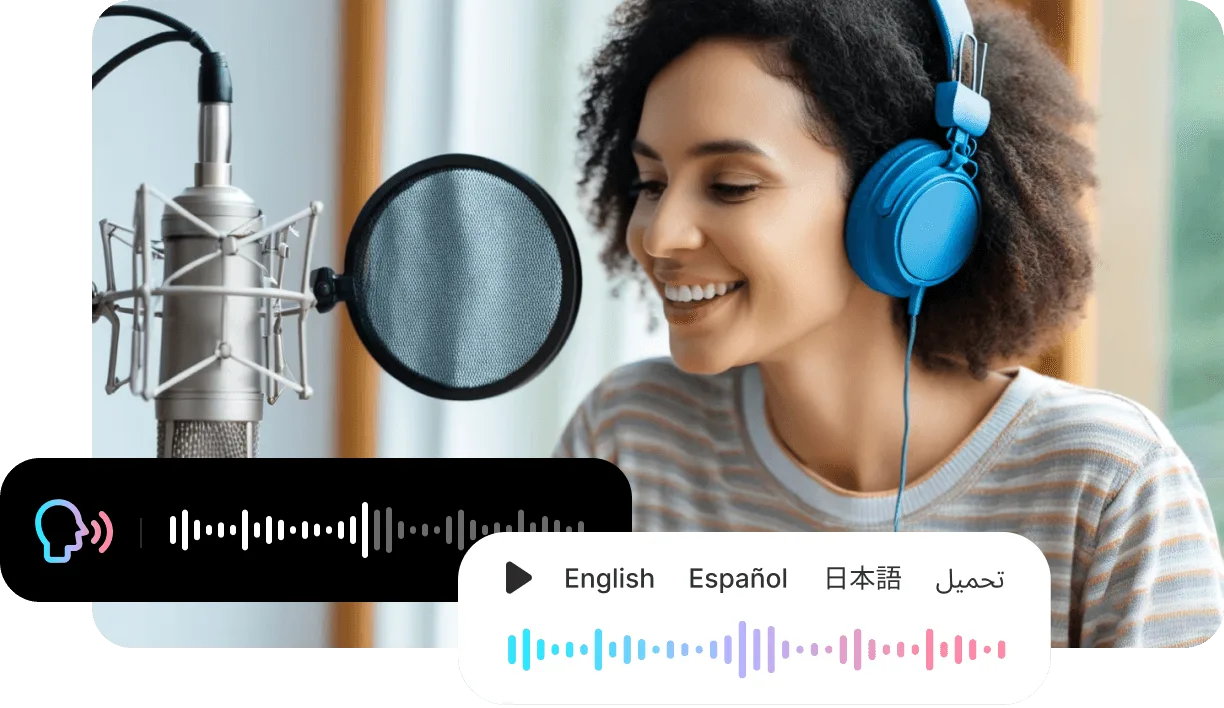
直接在浏览器里录下你的声音,无需离开页面就能生成口型同步视频。
同一张照片分别与 3 条不同音轨做口型同步。演绎方式一变,整支视频的感觉也随之改变——语速、表情与能量都会跟随角色的表达而变化。
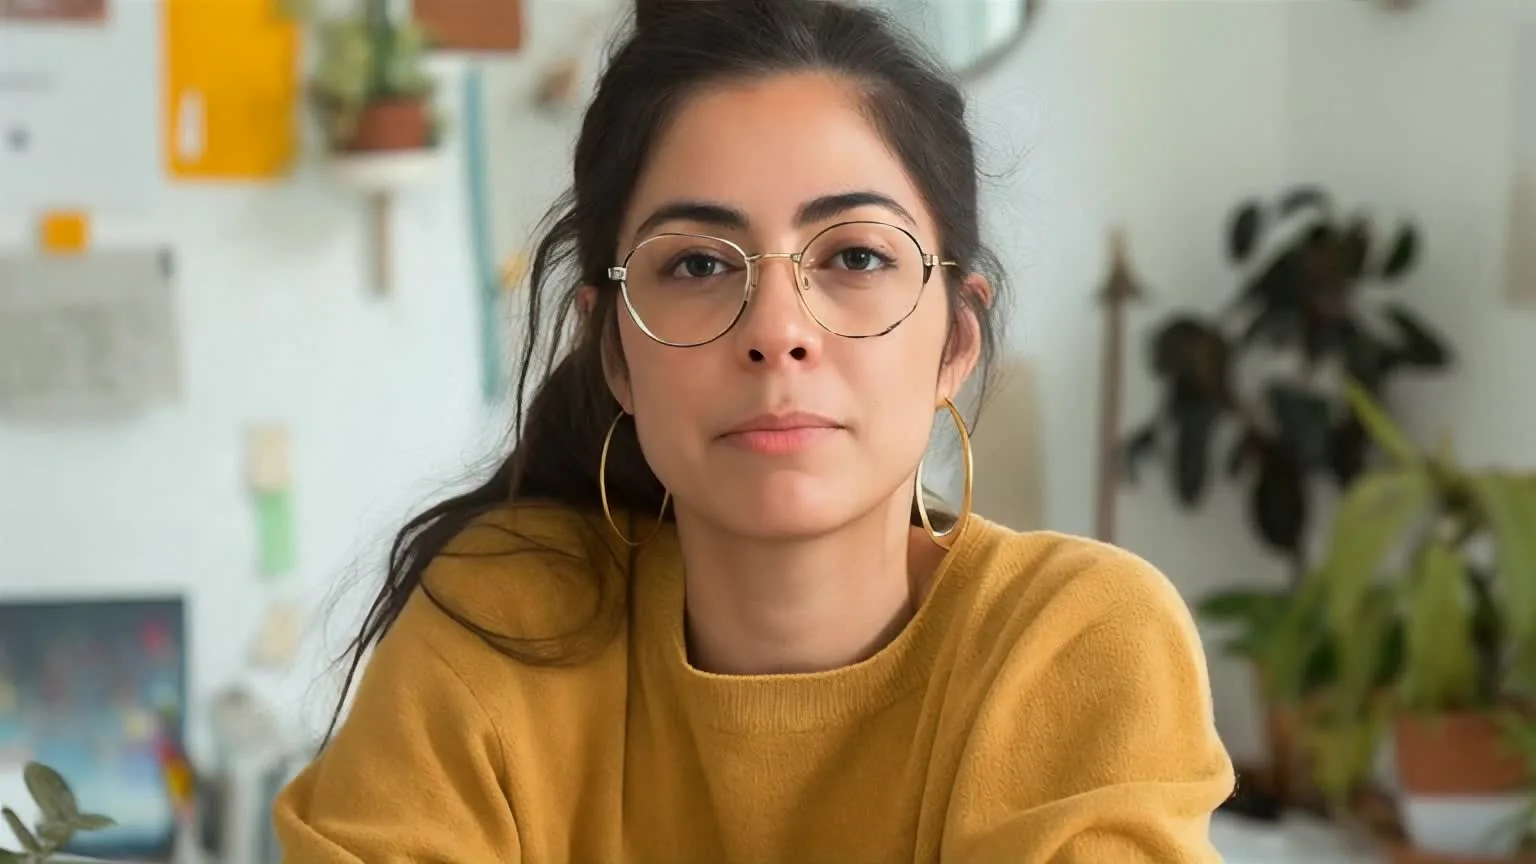
语速均匀、眼神稳定,适合讲解、更新通知与课程内容。
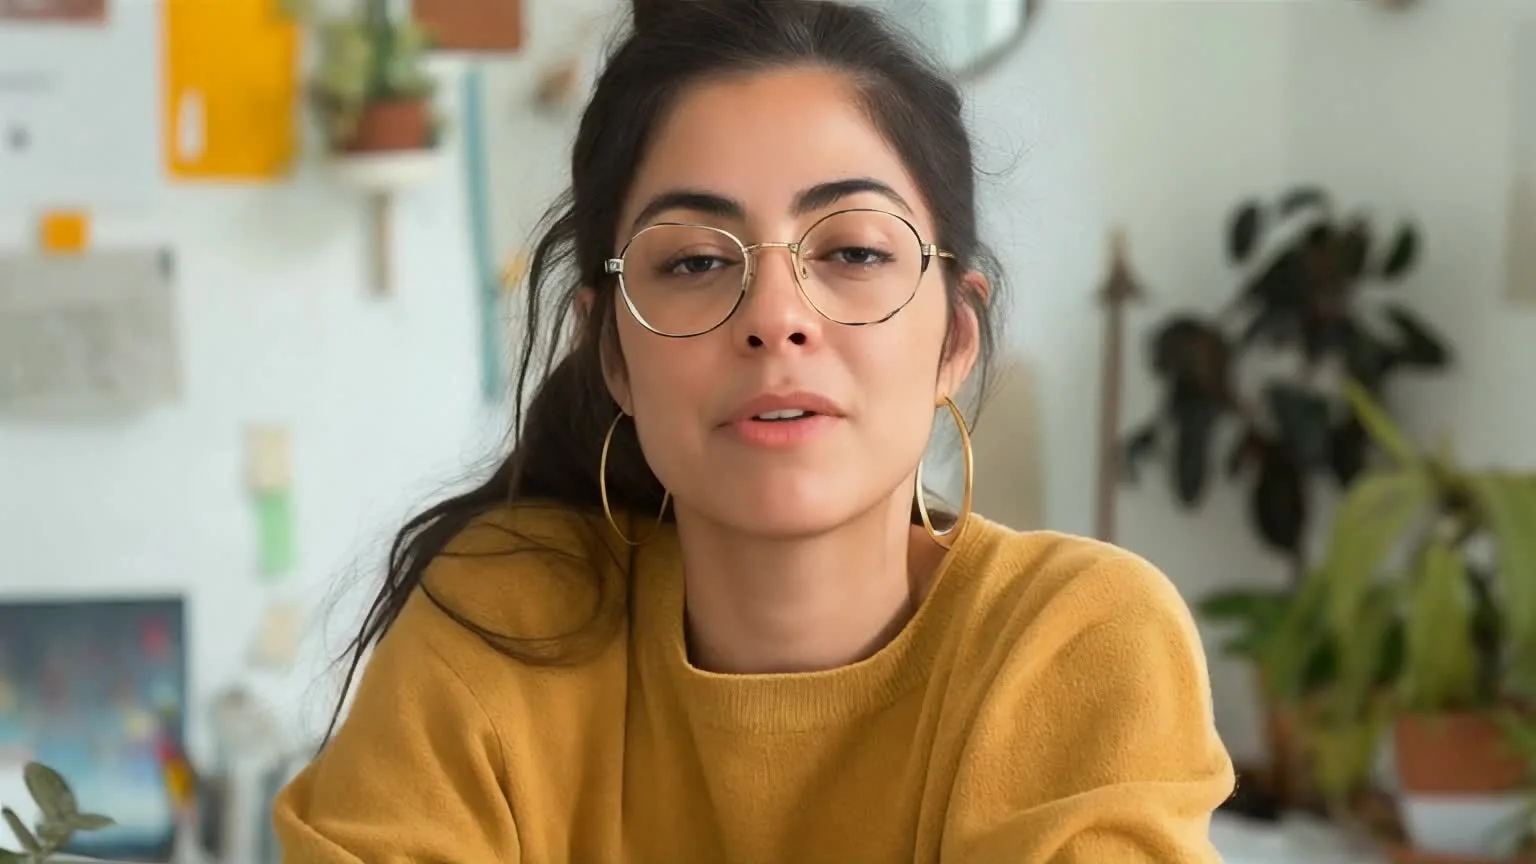
表情更明亮,适合问候、促销与社交平台的吸睛开场。
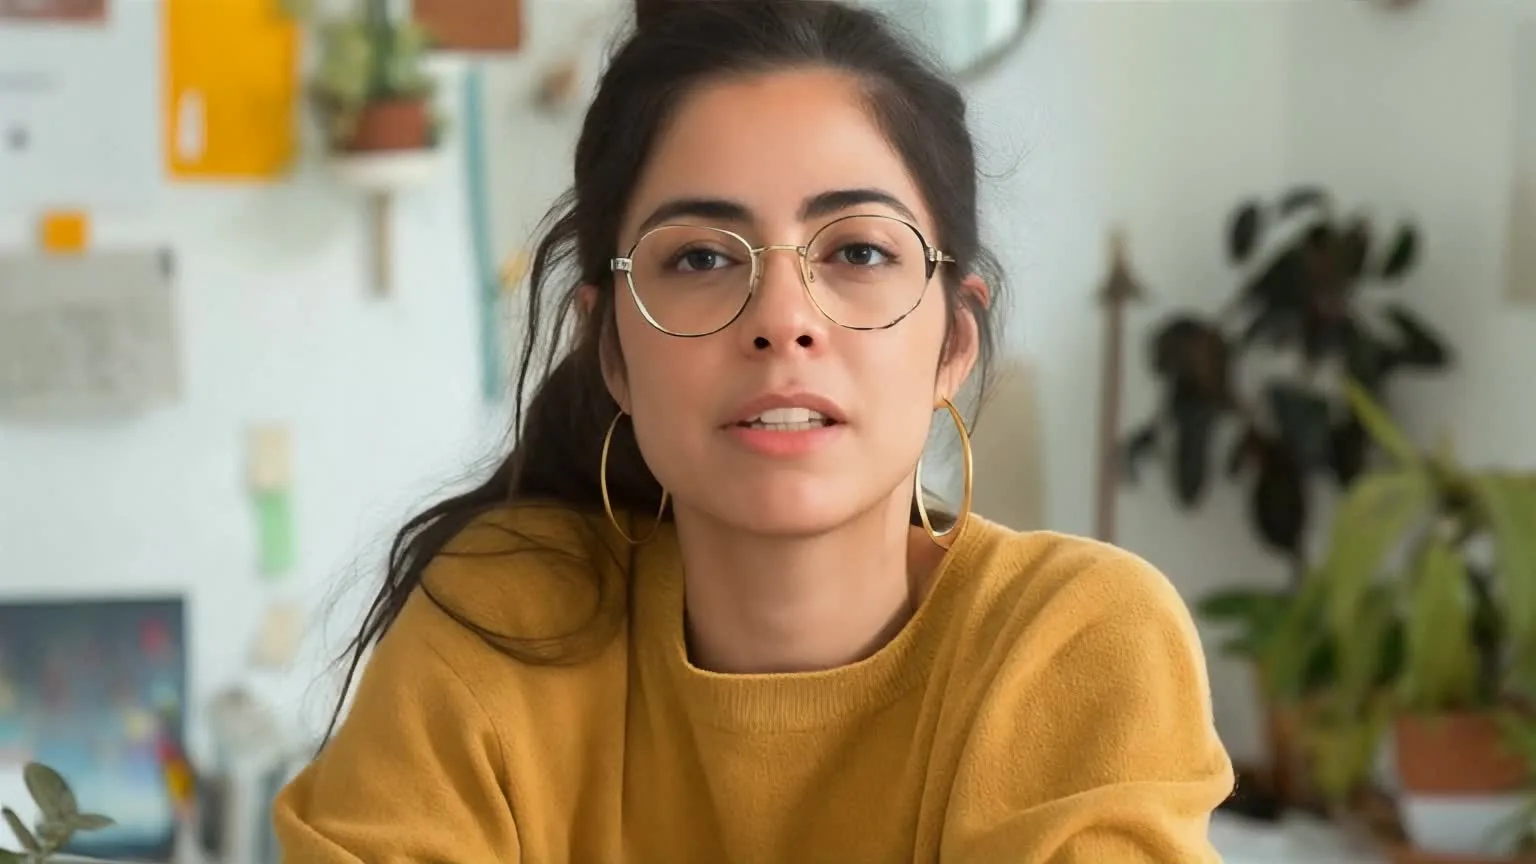
表情更锋利,适合短剧段子、反应类内容与角色场景。
如何使用
无需拍摄、无需关键帧、无需时间线剪辑——只要一张脸和一段声音。
上传清晰的正面照片、选择现成头像,或用文字提示词生成一个新角色。
输入脚本并选择音色、上传音频文件,或录制你自己的声音。
选择 720P、1080P 或 2K,生成视频并下载口型同步结果。
为什么选择 VisionStory
精准口型只是开始。表情、眨眼与头部动作加持,让成片更像真人开口说话,而不是“动画在动”。
口型会跟随音频的每个音节变化,让嘴唇真正“落”在字上,而不是只随音量张合。
人像照片、插画角色、品牌吉祥物、动物、AI 生成形象——只要脸部清晰,都能做口型同步。
当你导入或录制音频时,VisionStory 会保留你的声音,并按原始节奏同步人脸。想换一种音色?用“选择音色”功能,可在保留演绎效果的同时转换录音音色。
导入的录音若有环境底噪或嗡鸣,可开启“噪音消除”,让声音更清晰、口型也更干净利落。
还没录音?用 88 种语言中的任意一种输入脚本,并从 1,000+ AI 音色中选择即可。
同步时会加入眨眼、面部表情与自然的头部运动,让静态照片变成可信的“会说话的人”。
可渲染为 720P、1080P 或 2K,适用于社交帖子、演示、产品视频与广告。
将视频画幅设置为 9:16、1:1 或 16:9,轻松适配 Shorts、Reels、TikTok、信息流或 YouTube,无需二次裁剪。
AI 口型同步会将角色的嘴部动作与音频轨道匹配。在 VisionStory 中,你提供一张脸——照片、插画或现成头像——再提供来自脚本、上传或录制的音频。随后 VisionStory 会生成视频,让嘴型、表情和头部动作跟随声音自然变化。