角色驱动的系列作品,成败往往取决于“认得出来”。观众必须在不费脑的情况下相信:这一幕的脸就是上一幕的那张脸;这个声音属于同一个人;角色不会在两集之间悄悄变成另一个人。本页面将一步步说明叙事团队如何制作能贯穿整季的 AI 角色视频:只需一次把角色定义成一个拥有固定脸、音色与外观的角色设定;之后生成场景与对白镜头时,都以这个设定为基准,而不是每次都用一段全新的描述;并让角色画面足够清晰,经得起成片母版输出。VisionStory 负责生成角色素材与镜头;它不会替你写故事,不会替你剪辑单集,也不会决定哪些内容发布。若角色基于真实人物的脸或音色,必须先取得该人物的书面授权。
所以,把说话镜头当作“有长度的镜头”,而不是“音频多长就跑多长的片段”。AI 生成角色的单一连续长镜头,通常只能稳定撑住几秒台词;再往后,小误差会累积,脸就开始显得“合成感”更重。面对长段独白,更诚实的解法是剪切:切到听者、切到反应、切到手部,再切回来。视线方向要在生成前就决定好,而不是生成后再跟它较劲;每个 take 控制得足够短,画面才会干净;在台词点上剪,而不是把一个镜头硬拉到它承受不了的长度。某个时刻真的必须拉长时,解决办法是导演调度,而不是渲染更久。
以角色为核心的团队如何使用 VisionStory
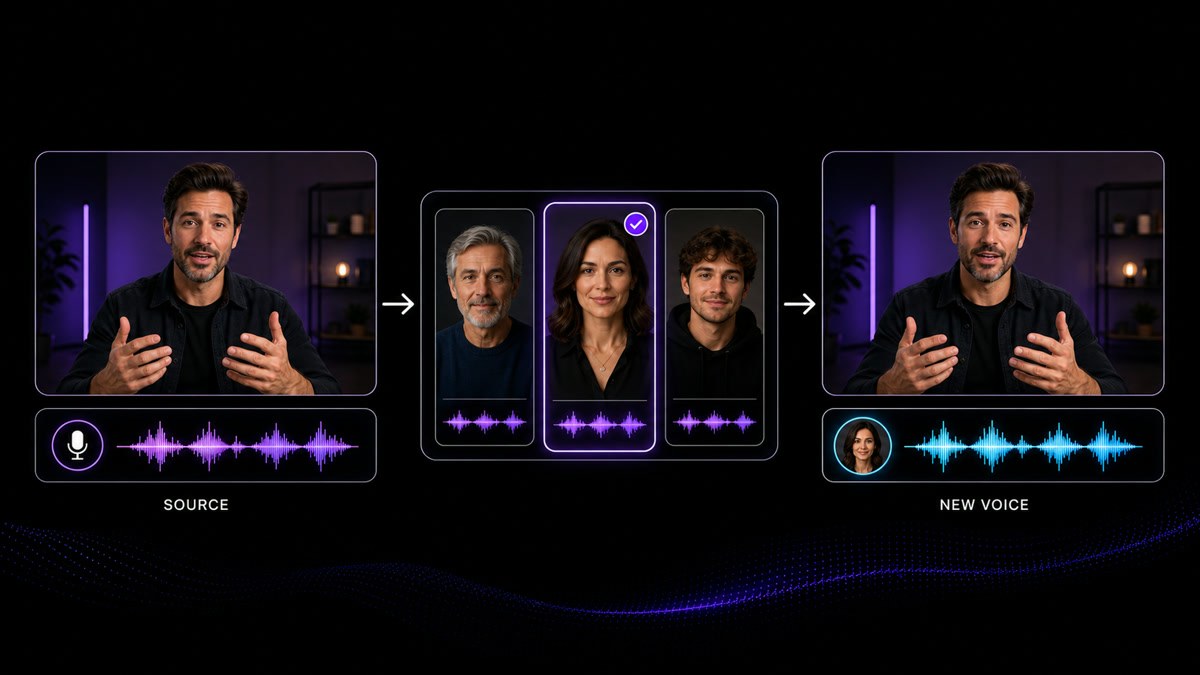
要做 AI 角色视频,最简洁的答案是:先把角色定下来,后面的一切都以它为基准生成。角色“档案”比角色“描述”更值钱,差别就在你往里放了什么:一张脸、一个音色、一种说话方式,以及一小套永远不允许变动的外观规则。把这四件事定住,后面大多就是执行。下面 6 个步骤也标出了仍需要人来做决定的地方,尤其是涉及真实的人脸或音色,以及最终要发布的内容。
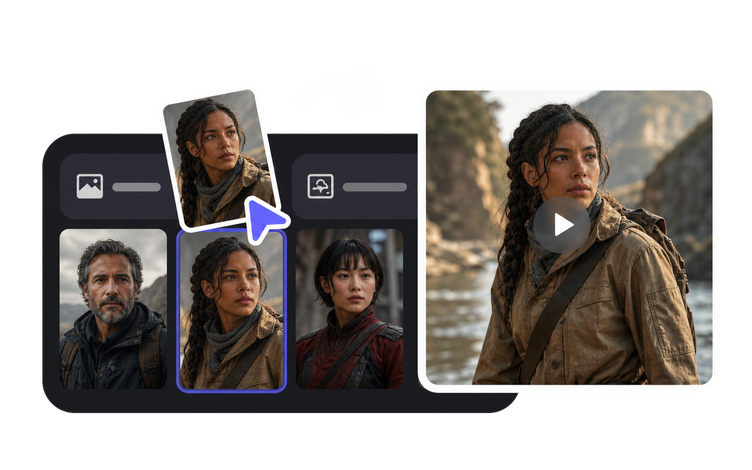
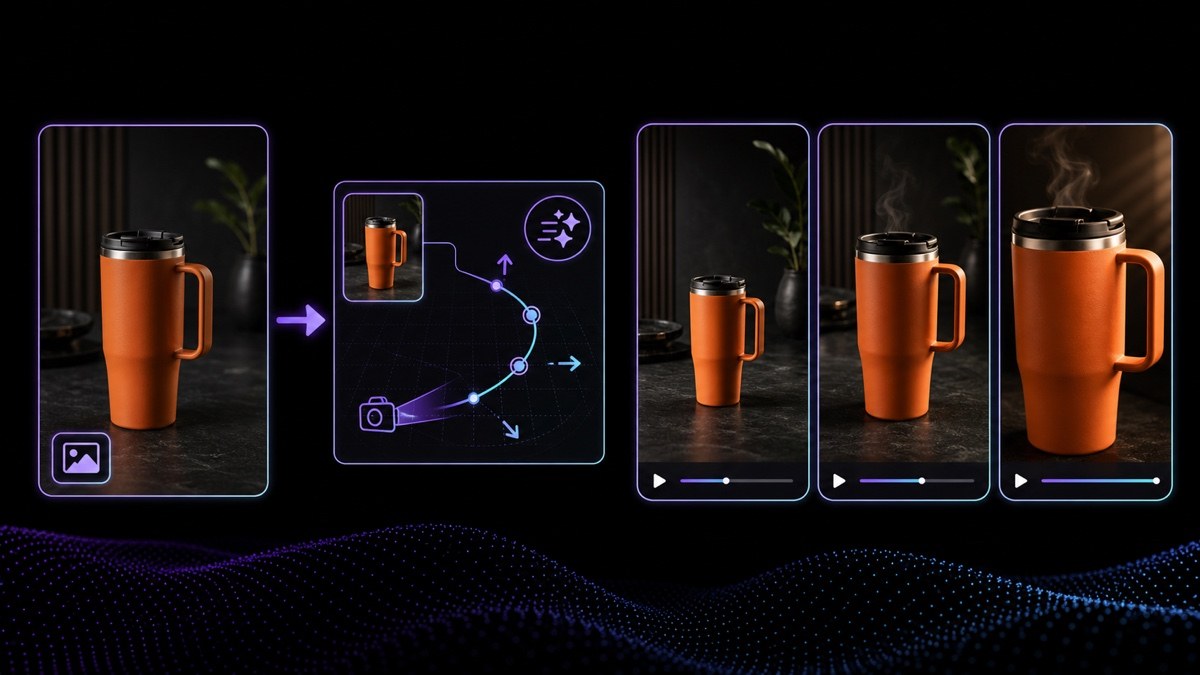
角色人设定下来后,下一步要验证的就是:它是否能动起来。用 Image to Video 把一张已获授权的角色图片做成一段动作可控的短片段,按镜头逐个生成,而不是一次生成整场戏。对话往来就是由可剪辑的镜头组成的,它也给你留出空间放进“慢半拍”才落下的反应镜头。动作只做当下这一刻需要的量就好,因为角色在画面里漂来漂去,更像特效而不是表演。越早看到角色动起来,也越能在还很便宜、很好改的时候确认侧脸轮廓是否对。把这些片段剪成一场戏的剪辑方式,由你决定。
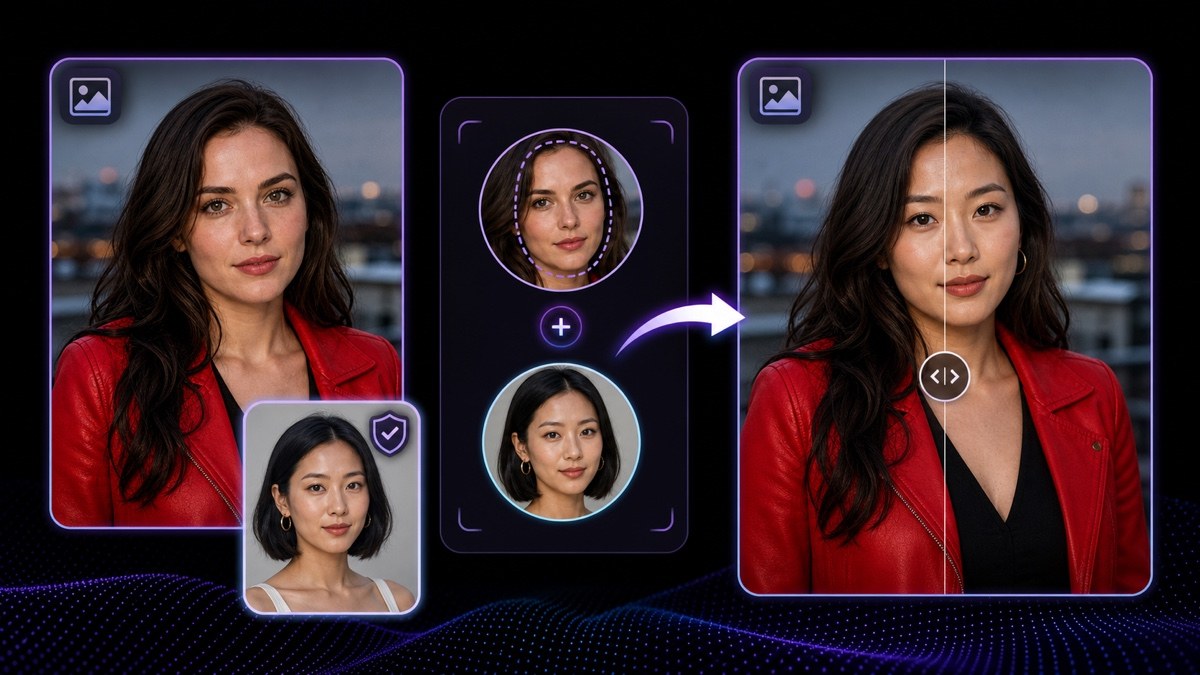
Face Swap 会把静态图片中的脸替换为已获授权的相貌,同时保留原本的光线与构图——这正是以真人为原型的角色,能在主视觉与场景剧照中保持一致的方式。它只适用于静态图,不适用于已完成的视频片段。在生成第一帧之前,就要取得当事人的书面许可,明确角色指向、内容用途以及投放/发布的平台与渠道,并且绝不要把结果当作对方的真实影像来呈现。若授权不清晰,就改为直接生成角色。
可以,但有一个必须坦白的限制。风格化生物、动物或品牌吉祥物,都可以像人类角色一样作为 persona 固定下来并赋予动作,外观规则也同样适用。限制在嘴部:说话口型的运动是以人脸为模型的,所以口鼻部、鸟喙、头盔或高度风格化的下颌,呈现出来往往是“近似”而非“精确”,而长嘴吻和长喙最难。做非人类角色的团队通常会把说话镜头做短,优先用 3/4 侧与侧面角度,并让音色与剪辑去承载台词,而不是指望嘴部细节。
一张清晰、光线充足、正对镜头的角色图片,画面大致从肩膀以上取景,并且整张脸都可见:不要墨镜、不要用手挡住下颌、不要头发遮住一只眼、不要严重运动模糊,也不要从合照里裁出一个很小的脸。当源图质量差时,出问题往往是可预期的,而不是随机的:眼神会飘,出现对白后嘴部很快失去形状,不同镜头之间脸会漂移——这正是 persona 存在要避免的“漂移”。换一张好的源图,比从差的源图反复重新生成更有效。
VisionStory AI Delivers Strong ROI with Fast, High-Quality Video Creation
I like VisionStory AI because it delivers strong ROI through intelligent automation. It helps me create high-quality video content much faster and at a lower cost than traditional production. The AI understands prompts well, produces natural results, and makes it easy to test creative ideas quickly.
AGAKI G.Small-Business · International Trade and Development
High-Quality Talking Videos at a Competitive Price
VisionStory is able to create high-quality talking videos at a very competitive cost. The video generation cost can be less than $1 per minute, while the final result is comparable to leading AI video models.
TLTony L.Small-Business · Animation
Easy-to-Use Tool, Ideal for Educational Content
I like that VisionStory AI is very easy to apply and extremely easy to use. You don't really need to know much about AI or these types of systems to get started. I also appreciate that it helps me a lot by simply saying what I want to generate, I make a brief speech or what the character is going to say and let VisionStory AI do everything. Moreover, the initial setup was very simple, as I did it through my Google account and it was extremely easy. Apart from a few details, it is an excellent application.
AMAaron Misael G.Small-Business · Animation
Podcast Feature That Auto-Splits Two Speakers—A Huge Time Saver
I love the podcast feature the best, although making other videos work great too. I can't believe that you can upload one audio file with 2 different people talking back and forth, and the program can automatically put the correct sections of the audio to the right character. That is such a time saver!
JHJill H.Small-Business · Entertainment
Fast, Efficient PPT-to-Video Creation for Training and Team Updates
What I like best about VisionStory AI is its PPT-to-video feature. As a technical team leader, I often need to create internal training materials, project updates, and presentation videos for my team. VisionStory AI lets me turn slides into video content much faster, without having to spend extra time recording, editing, or coordinating production resources. Overall, it makes knowledge sharing and internal communication far more efficient.
YDYanlong D.Mid-Market · Computer Software
VisionStory Turns PPTs into Ready-to-Use Presentation Videos in Minutes
In my daily work, I often need to present slides in video format, and VisionStory handles that perfectly. I just upload my PPT, add my own photo and voice, and it quickly creates a presentation video that’s ready to use. It saves me a lot of time and really improves my workflow.



用户喜爱 VisionStory
了解内容创作者和营销人员为何信赖 VisionStory 满足他们的 AI 视频需求。从强大功能到流畅体验,我们的用户社区对 VisionStory 的成果赞不绝口。