AI 口型同步视频生成器
选一张脸,加上声音,就能得到每个字都对得上的口型视频。输入脚本、上传你的音频,或直接在浏览器录制——VisionStory 会把嘴型、表情与头部动作同步到你听到的内容。
开始同步口型选一张脸,加上声音,就能得到每个字都对得上的口型视频。输入脚本、上传你的音频,或直接在浏览器录制——VisionStory 会把嘴型、表情与头部动作同步到你听到的内容。
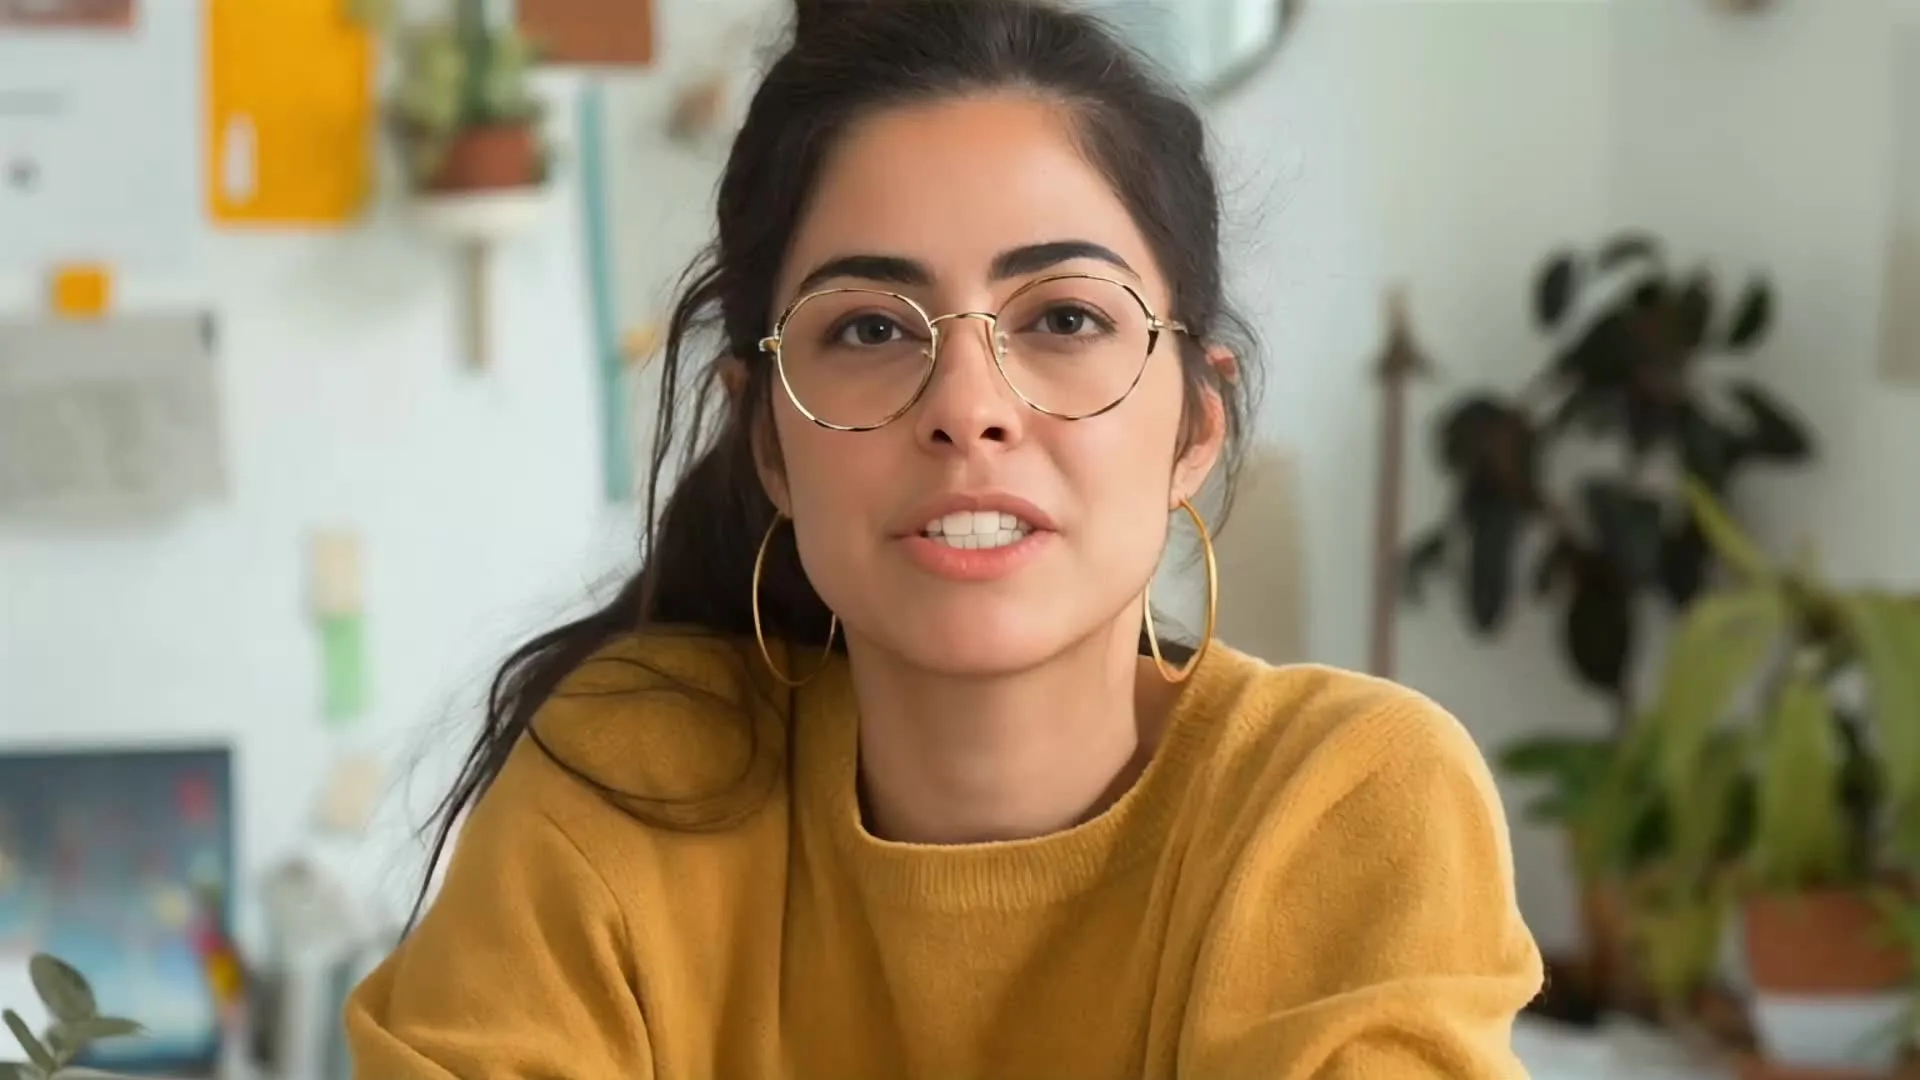
开始同步口型把声音打开。同一张肖像就能讲出一段 15 秒的课程开场——嘴型、停顿与表情都会跟着声音走。
音频输入
可以从你已有的音频开始——也可以只用几行文字从零开始。
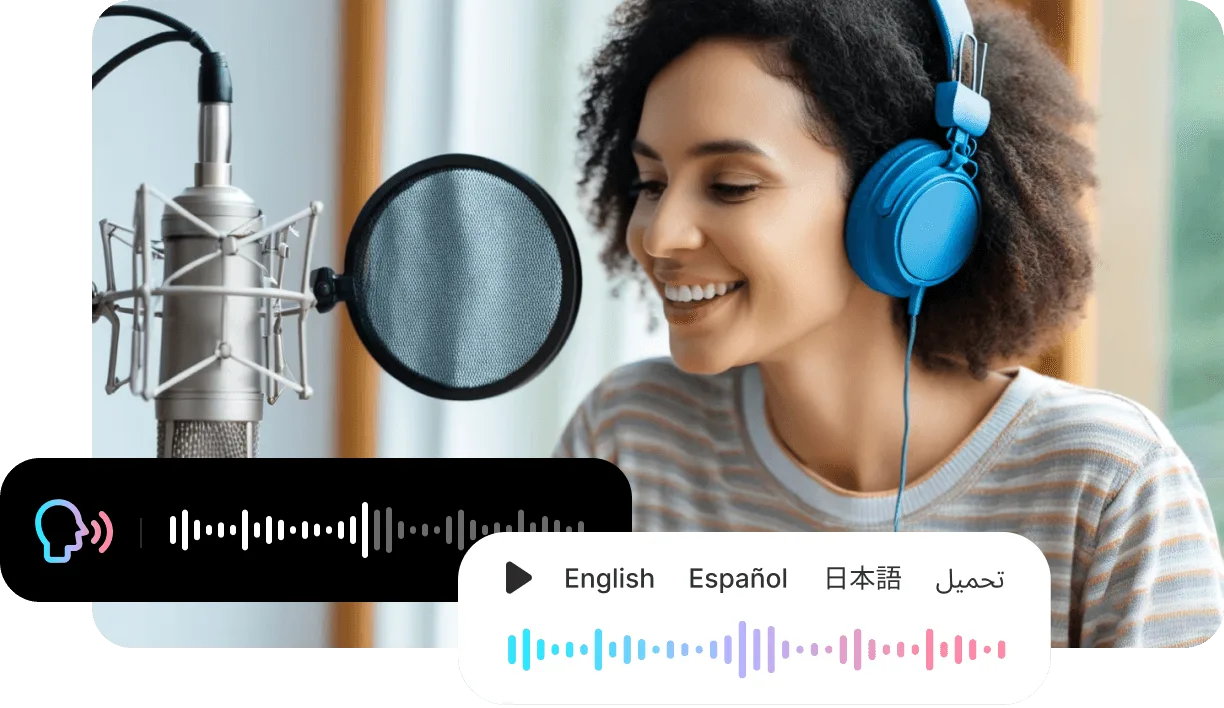
写下角色要说的话,从 88 种语言的 1,000+ AI 音色中挑选一个,嘴型就会跟随生成的语音同步。
导入配音、播客片段、采访回答或歌曲,让面部口型精准对齐这段录音。
直接在浏览器录音,无需离开页面,就能生成口型同步视频。
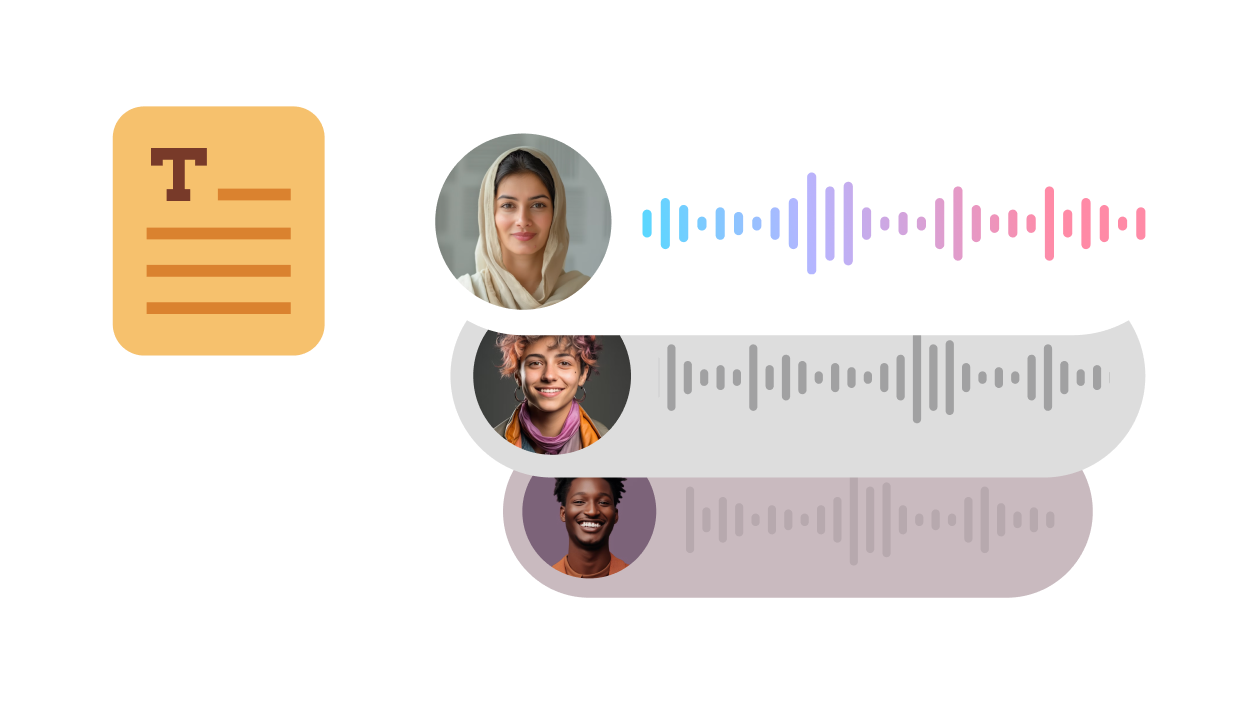
同一张照片,对齐 3 段不同的音轨。演绎方式会改变整支视频——节奏、表情与能量感都会跟着角色说的话走。
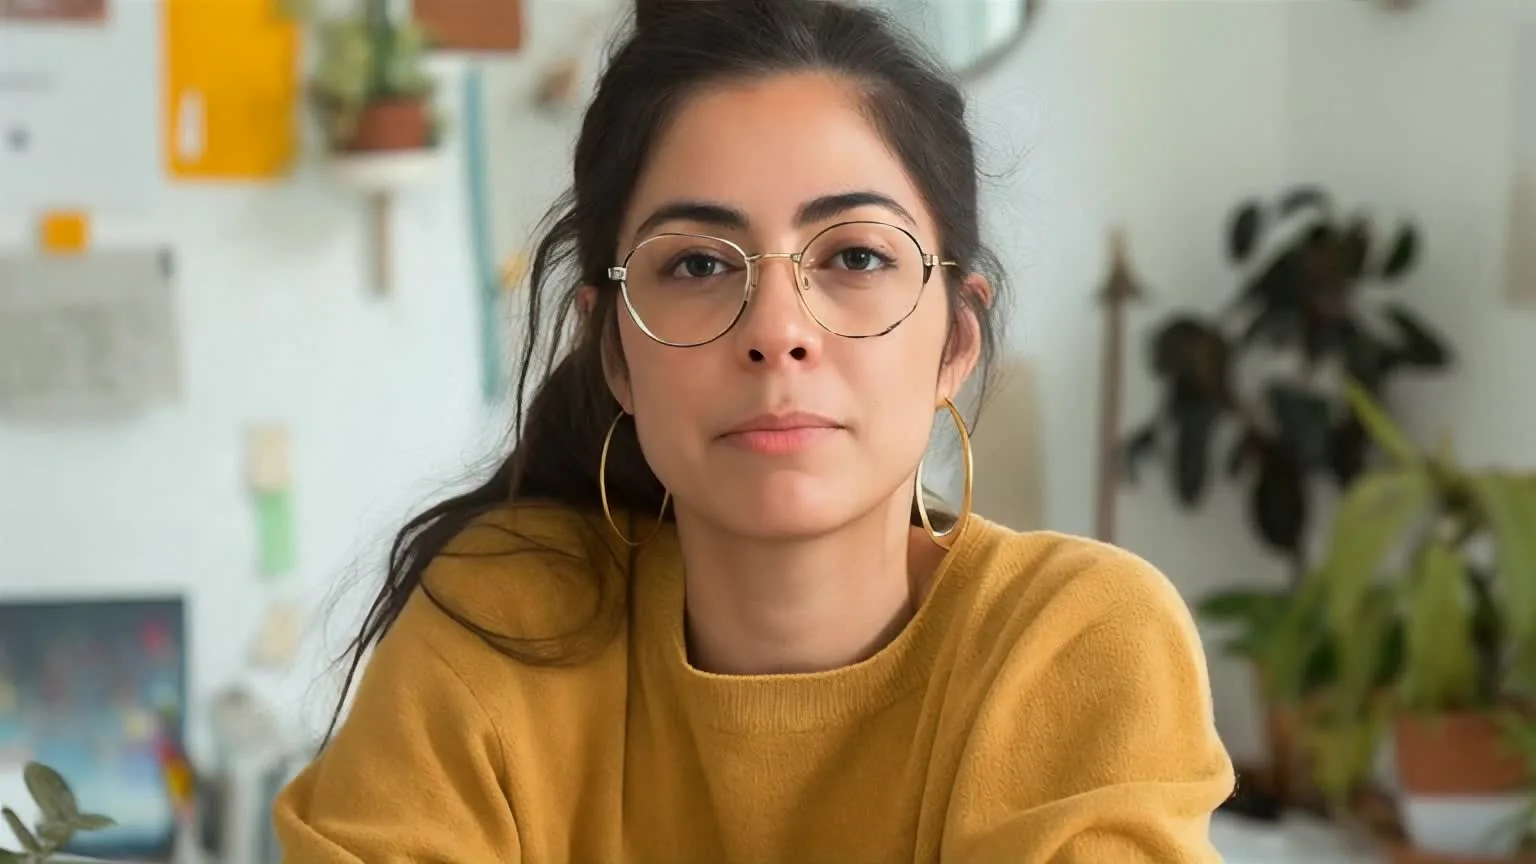
节奏均匀、眼神稳定,适合讲解、动态更新与课程内容。
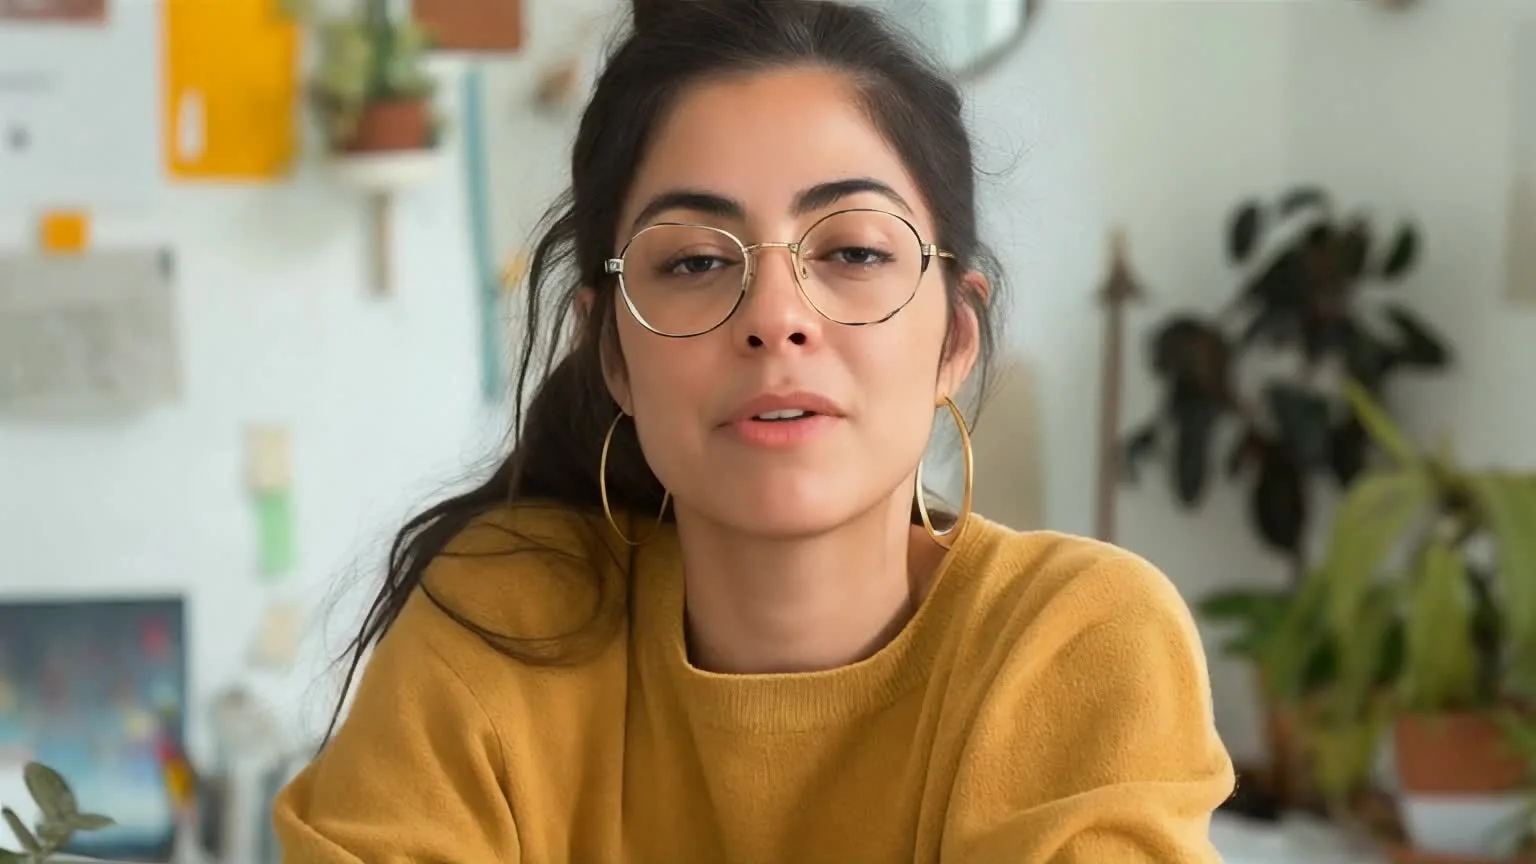
表情更明亮,适合问候、促销与社交平台引流开场。
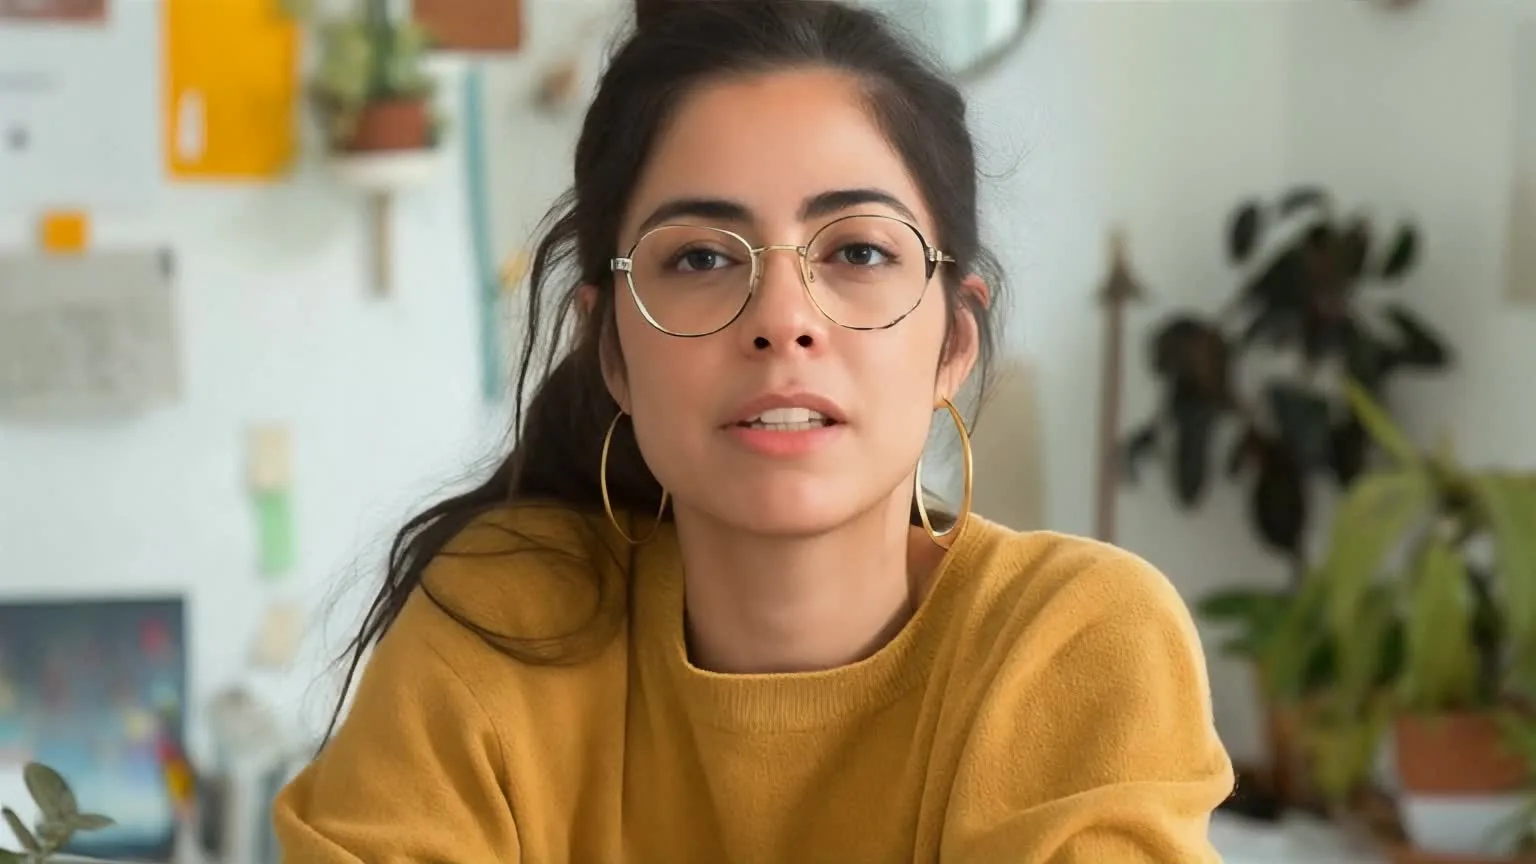
表情更犀利,适合短剧小品、反应类内容与角色场景。
如何运作
无需拍摄、关键帧或时间轴剪辑——只要一张脸和一段声音。
上传清晰的正面照片、选择现成虚拟人,或用文本提示词生成新角色。
输入脚本并选择音色、上传音频文件,或录制你自己的声音。
选择 720P、1080P 或 2K,生成视频并下载口型同步成片。
为什么选择 VisionStory
准确嘴型只是开始;表情、眨眼与头部动作,会让成片更像在“说话”,而不是在“动”。
嘴型会跟随音频的每个音节变化,让口型落在具体字词上,而不是只随音量大小张合。
支持肖像照、插画角色、品牌吉祥物、动物与 AI 生成形象的口型同步——只要面部清晰即可。
当你导入或录制音频时,VisionStory 会保留你的声音,并按原有节奏同步面部口型。想换一种音色?使用“选择音色”,可在保留演绎的同时转换录音。
导入的录音若有室内嗡嗡声或背景噪音,可开启“噪音消除”,让声音与口型都更清晰。
还没录音?用 88 种语言中的任意一种输入脚本,并从 1,000+ AI 音色中选择即可。
同步时会加入眨眼、面部表情与自然的头部动作,让静态照片变成可信的“开口说话者”。
支持以 720P、1080P 或 2K 渲染,用于社交内容、演示、产品视频与广告。
将视频画面设为 9:16、1:1 或 16:9,轻松适配 Shorts、Reels、TikTok、信息流或 YouTube,无需二次裁剪。
AI 口型同步会将角色的口部动作与音频轨道对齐。在 VisionStory,你提供一张脸——照片、插画或现成虚拟人——以及来自脚本、上传或录制的音频。随后 VisionStory 会生成一段视频,让嘴唇、表情与头部动作跟随声音自然变化。