
آمادهاید یک متن را به یک مجری هوش مصنوعی واقعینما تبدیل کنید؟ این راهنمای مرحلهبهمرحله به شما نشان میدهد چطور اولین ویدیوی آواتار سخنگوی هوش مصنوعی خود را در VisionStory بسازید—یک آواتار انتخاب کنید، کلماتتان را اضافه کنید، یک صدا بردارید و در چند دقیقه یک ویدیوی سخنگوی حرفهای تحویل بگیرید. ویدیوی راهنما را در بالا ببینید، سپس مراحل زیر را دنبال کنید.
مرحله 1: آواتار خود را انتخاب یا ایجاد کنید
AI Video را باز کنید و تصمیم بگیرید چه کسی ارائه بدهد. برای داشتن یک آواتار، سه راه دارید:
- انتخاب آواتار داخلی: یکی از کاراکترهای عمومیِ آماده VisionStory را انتخاب کنید—سریعترین راه برای شروع.
- آپلود عکس خودتان: یک تصویر واضح و تمامرخ اضافه کنید تا یک فرد واقعی به آواتار سخنگو تبدیل شود.
- تولید آواتار: از روی یک پرامپت متنی، یک کاراکتر کاملاً جدید بسازید.
هر زمان خواستید برای تنظیم آواتار انتخابشده، از Change Look استفاده کنید.

مرحله 2: متن خود را اضافه کنید
به آواتارتان بگویید چه چیزی را بیان کند. در پنل سمت راست، روش تامین صدا را انتخاب کنید:
- Script: کلماتی را که میخواهید آواتار بگوید تایپ کنید و بگذارید هوش مصنوعی گفتار را تولید کند.
- Import: یک فایل صوتی از پیش ضبطشده آپلود کنید تا ویدیو بر اساس آن ساخته شود — لیپسینک هوش مصنوعی آواتار، ضبط شما را دنبال میکند.
- Record: صدای خودتان را مستقیم داخل VisionStory ضبط کنید.
برای بار اول، متن را کوتاه نگه دارید تا بتوانید سریع نتیجه را بررسی کنید.
مرحله 3: یک صدا انتخاب کنید
هر آواتار یک صدای پیشفرض دارد، اما میتوانید آن را تغییر دهید:
- Voice Library: کتابخانه را باز کنید تا 1,000+ صدا در 88 زبان را ببینید و با جستجو سریعاً دقیقاً همان صدایی را که میخواهید پیدا کنید.
- شبیهسازی صدا: از یک نمونه کوتاه از صدای ضبطشده خودتان، یک صدای سفارشیِ هوش مصنوعی بسازید.
- پیشنمایش و بهبود: با Preview Audio قبل از نهاییکردن گوش کنید و با Voice Enhance صدا را تمیزتر کنید.

مرحله 4: مدل ویدیو، وضوح تصویر و گزینهها را انتخاب کنید
قبل از تولید، ظاهر ویدیو را تنظیم کنید:
- Video Model: VisionStory از جدیدترین مدل آواتار سخنگوی خود، V-Character 4.0، برای لیپسینک و حالات چهره طبیعی استفاده میکند.
- Resolution: بسته به محل انتشار، 720P، 1080P یا 2K را انتخاب کنید.
- Aspect ratio: برای هماهنگی با پلتفرمتان بین 9:16 (عمودی)، 16:9 (افقی) و 1:1 (مربع) جابهجا شوید.
- Green Screen Video: فقط وقتی روشنش کنید که به یک پسزمینه یکدست نیاز دارید تا بعداً در ادیت جایگزینش کنید.
- Motion: میزان حرکت آواتار را تنظیم کنید تا اجرا پویاتر شود.
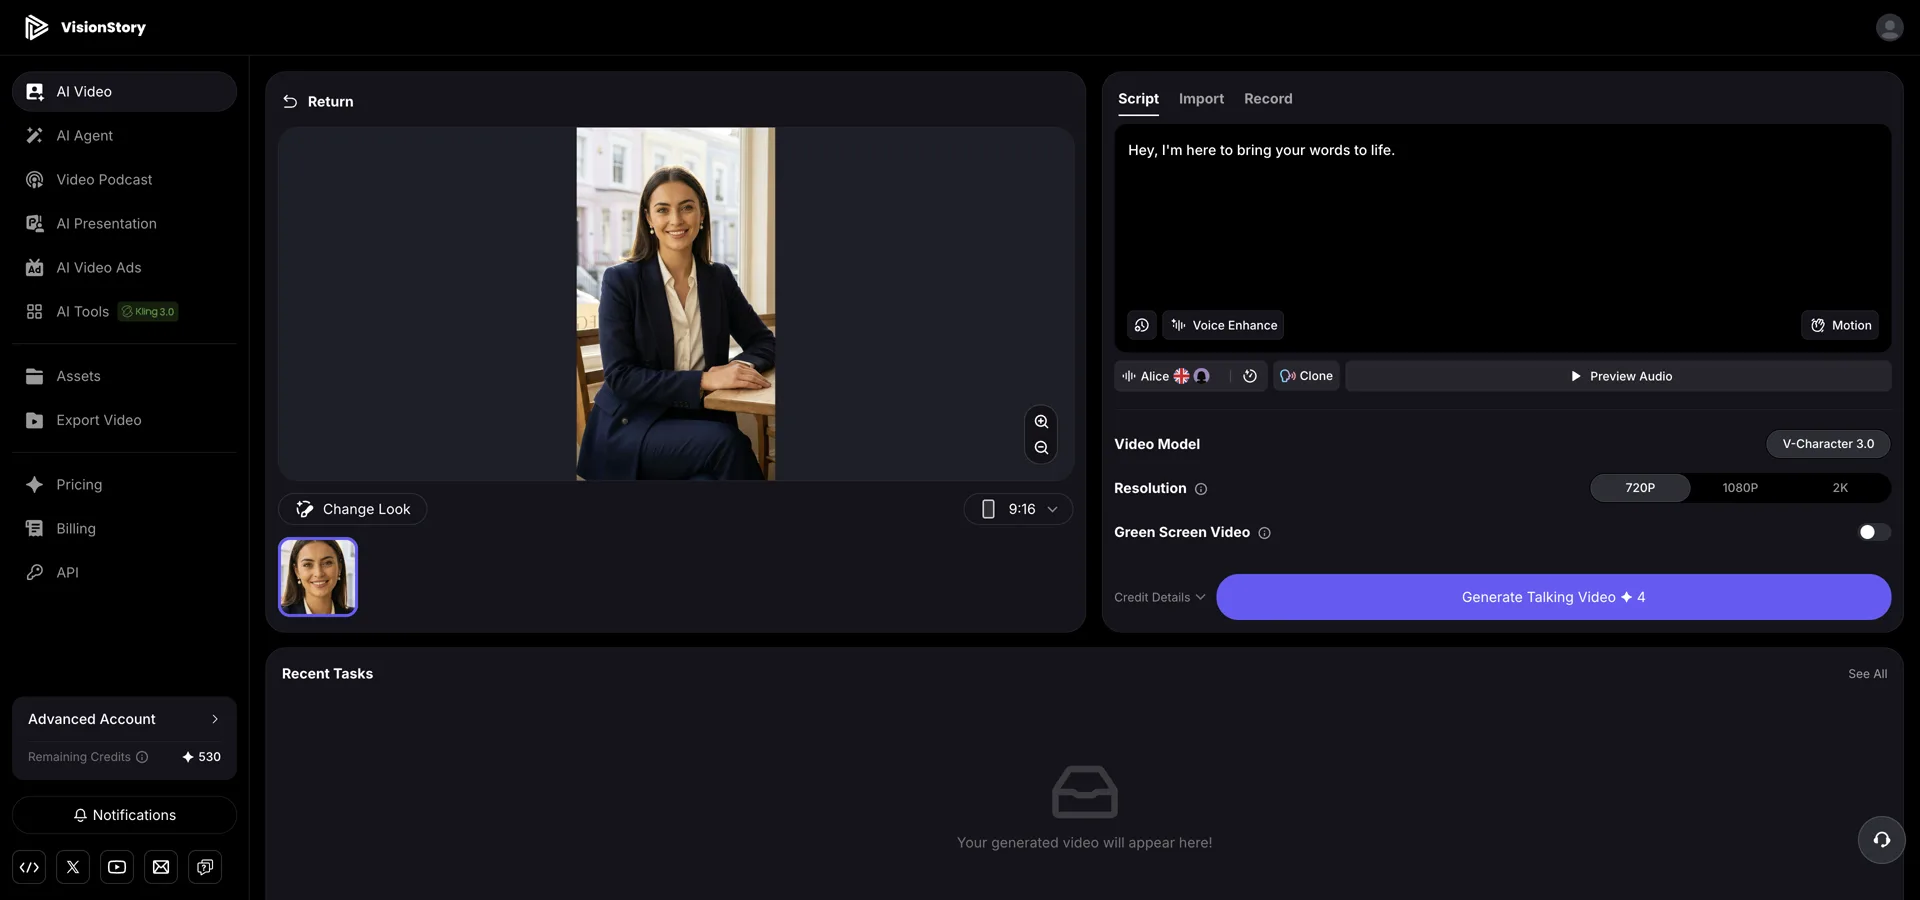
مرحله 5: اعتبارها را بررسی کنید و تولید بزنید
VisionStory قبل از تولید، هزینه را نشان میدهد:
- Credit Details: بخش Credit Details را باز کنید تا ببینید جمع کل چطور محاسبه شده—هزینه به وضوح تصویر و مدتزمانی که انتخاب کردهاید بستگی دارد (مثلاً یک ویدیوی 60 ثانیهای 720P، 15 اعتبار هزینه دارد).
- Generate Talking Video: وقتی همه چیز درست بود، روی Generate کلیک کنید. VisionStory آواتار شما را متحرک میکند و لبها و حالات چهره را با متن شما هماهنگ میکند.
مرحله 6: ویدیویتان را بازبینی، به اشتراکگذاری و مدیریت کنید
بعد از تمام شدن پردازش، ویدیوی شما در Assets نمایش داده میشود و میتوانید:
- نتیجه نهایی را Preview کنید و برای مرتبسازی راحتتر، آن را rename کنید.
- فایل MP4 را Download کنید یا برای انتشار در هرجایی، لینک اشتراکگذاری را کپی کنید.
- مستقیماً به شبکههای اجتماعی مثل X یا Facebook Share کنید.
- ویدیویی را که دیگر نیاز ندارید Delete کنید.
تمام شد—اولین ویدیوی آواتار سخنگوی هوش مصنوعیتان را ساختید. از اینجا به بعد میتوانید آواتارهای مختلف را امتحان کنید، صدای خودتان را شبیهسازی کنید یا با رشد پروژههایتان، با وضوح تصویر بالاتر خروجی بگیرید.
