
هر ویدیوی هوش مصنوعی با یک متن (اسکریپت) شروع میشود، اما این صدا است که تعیین میکند آن متن چگونه به مخاطب مینشیند. صدا لهجه، سن، بافت، انرژی و شخصیت مجری شما را مشخص میکند — و سرعت، مکثها و نشانههای اجرا تعیین میکنند که نتیجه شبیه صحبت یک انسان باشد یا شبیه ماشینی که از روی کاغذ میخواند.
خلاصهاش این است: صدای هوش مصنوعی را با تطبیق زبان و لهجهٔ منطقهای با مخاطبتان انتخاب کنید، با کمک برچسبهای پروفایل یک فهرست کوتاه بسازید، هر گزینه را با متن خودتان پیشنمایش بگیرید و پیش از تولید ویدیو، اجرا را با سرعت و مکث شکل دهید. ادامهٔ این راهنما همین روند را گامبهگام در VisionStory توضیح میدهد؛ کتابخانه صدای هوش مصنوعی آن بیش از 1,000 صدا به 88 زبان دارد.
این راهنما چه چیزی را پوشش میدهد: Voice Library عمومی و کنترلهای اجرای پیرامون آن. ساختن صدا از روی ضبط صدای خودتان یک فرایند جداگانه است — به چگونه صدای خود را با هوش مصنوعی شبیهسازی کنیم مراجعه کنید.
مرحله 1: Voice Library را باز کنید و ردیف صدا را بخوانید
ویدیوی هوش مصنوعی را باز کنید، آواتار موردنظرتان را انتخاب کنید و روی صدای فعلی در زیر کادر Script کلیک کنید. Voice Library روی ویرایشگر باز میشود.
هر ردیف چهار نشانه دارد که به شما امکان میدهد پیش از زدن دکمهٔ پخش، حدس بزنید صدای گوینده چگونه خواهد بود:
- برچسب زبان — زبانی که صدا به آن صحبت میکند.
- پرچم — نشاندهندهٔ لهجهٔ منطقهای است، نه زبان دوم. صداهای انگلیسی میتوانند پرچم آمریکا، بریتانیا، کانادا و کشورهای دیگر را داشته باشند.
- جنسیت و سن — هویتی که از گوینده برداشت میشود.
- ویژگیها و کاربرد — توصیفهایی مانند شفاف، گرم، محاورهای، روایت، آموزش یا شبکههای اجتماعی.
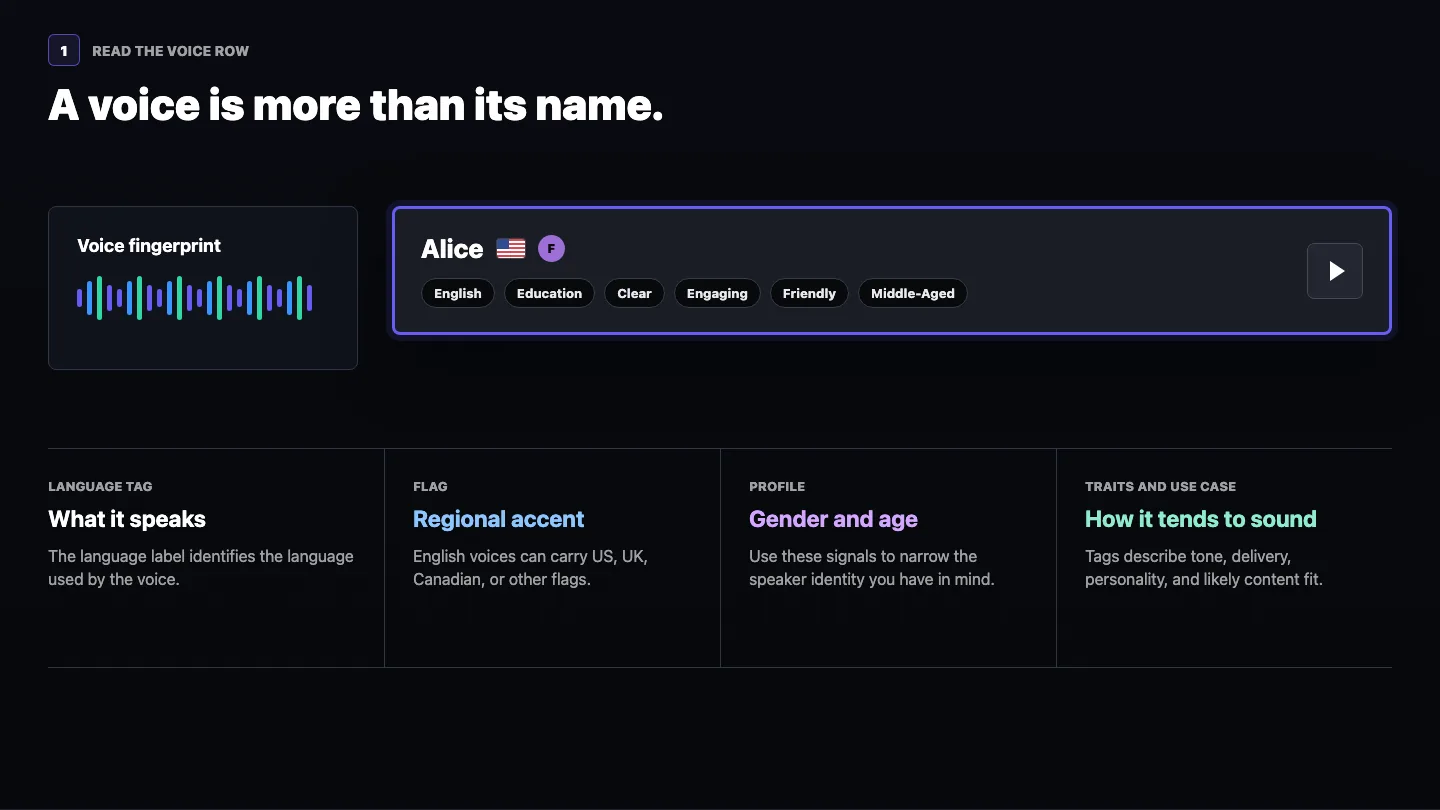
از برچسبها برای ساختن فهرست کوتاه استفاده کنید، نه برای تصمیم نهایی. دو صدا با برچسبهای تقریباً یکسان میتوانند از نظر ریتم، بافت و انرژی تفاوت زیادی داشته باشند.
مرحله 2: فیلتر کنید، جستوجو کنید و یک فهرست کوتاه را پیشنمایش بگیرید
بهاندازهٔ کافی گسترده شروع کنید تا تفاوتهای واقعی را بشنوید، سپس دایره را تنگتر کنید. تا وقتی هنوز در حال گشتن هستید، از فیلترهای Language (زبان)، Gender (جنسیت)، Age (سن)، Use Case (کاربرد) و Provider (ارائهدهنده) کمک بگیرید. اگر نام صدایی را از قبل میدانید، بهجای آن نام را در کادر جستوجو تایپ کنید.
Provider که آخرین فیلتر در این ردیف است، همان موتور گفتاریِ پشتِ هر صداست. VisionStory چند موتور را اجرا میکند و هر کدام در چیزی متفاوت قویتر هستند. در اولین دور بررسی، آن را روی All بگذارید — شما بهترین صدا را برای این متن میخواهید، فارغ از اینکه کدام موتور آن را ساخته است. سراغ این فیلتر فقط زمانی بروید که از قبل دقیقاً میدانید چه میخواهید؛ مثلاً یک اجرای کانتونی یا یک صدایی که باید چند زبان را پوشش دهد. در مرحله 3 توضیح میدهیم در چنین مواردی کدام موتور را انتخاب کنید.
- یک فهرست کوتاه بسازید. آنقدر فیلتر یا جستوجو کنید تا بهجای یک فهرست کامل، چند گزینهٔ محدود داشته باشید.
- همهٔ گزینههای فهرست کوتاه را گوش کنید. برای شنیدن نمونه، روی دکمهٔ پخش در سمت راست ردیف صدا کلیک کنید.
- مکث کنید و مقایسه کنید. پیش از پخش نمونهٔ بعدی، دوباره روی همان دکمه کلیک کنید تا پخش متوقف شود.
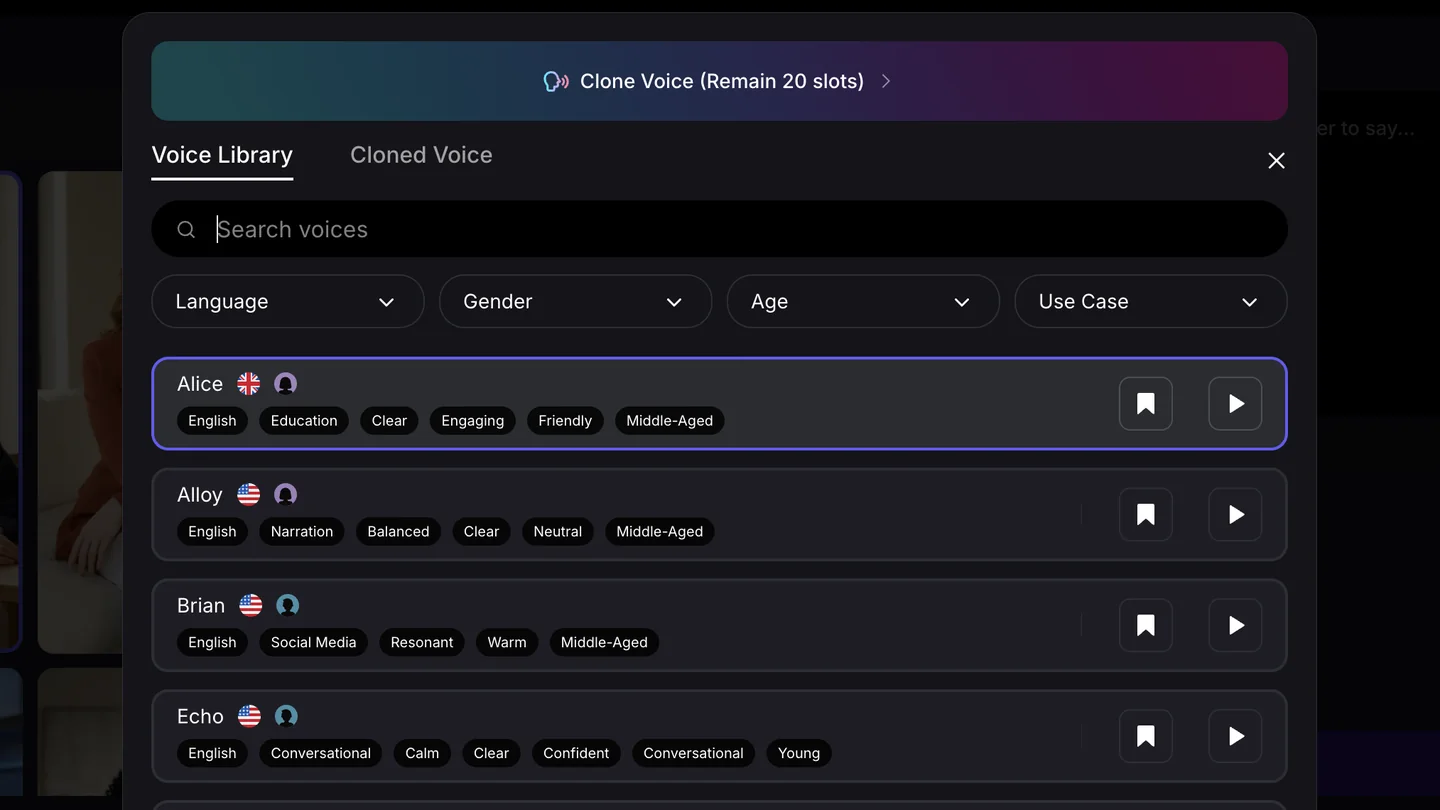
هنگام گوش دادن به چیزی توجه کنید که ویدیوی شما واقعاً به آن نیاز دارد: لهجهٔ منطقهای، شفافیت، انرژی، گرمی، اقتدار و سرعتی که صدا با آن یک جمله را پیش میبرد. صدایی که بهتنهایی عالی به نظر میرسد، باز هم ممکن است برای یک متن آموزشی، فروش، خبری یا شخصیتمحور مناسب نباشد.
مرحله 3: صدا را با محتوا و مخاطب خود متناسب کنید
بیشتر صداگذاریهای هوش مصنوعی که ناامیدکننده از آب درمیآیند، مشکل کیفیت ندارند؛ مشکل تناسب دارند. پیش از آنکه تصمیم نهایی را بگیرید، مشخص کنید این صدا قرار است برای همین ویدیوی خاص چه کاری انجام دهد.
| اگر در حال ساخت این هستید | دنبال این باشید | از این پرهیز کنید |
|---|---|---|
| آموزشها، ویدیوهای توضیحی، دورههای آموزشی | بیان شفاف، سرعت یکنواخت، لحن گرم و خنثی | اجرای پرانرژی تبلیغاتی که اصطلاحات فنی را با عجله میخواند |
| تبلیغات، معرفیهای تبلیغاتی، کلیپهای کوتاه شبکههای اجتماعی | انرژی، کوبندگی، صدایی بااعتمادبهنفس و جوانتر | روایت آهسته و سنجیدهای که قلاب توجه را از دست میدهد |
| اخبار، محتوای سازمانی، بهروزرسانیهای محصول | اقتدار، ریتم یکنواخت، بافت صوتی حداقلی | صداهای خودمانی یا بهشدت شخصیتمحور |
| داستانگویی، مصاحبهها، پادکستها | شخصیت و دامنه بیانی گسترده | اجرای یکنواخت و بیفرازوفرود در حد گوینده تشریفاتی |
| نسخههای بومیسازیشده از یک ویدیو | لهجه بومی و منطقهای متناسب با هر بازار | یک صدای انگلیسی که متن ترجمهشده را میخواند |
| یک ویدیو، چند نسخه زبانی، یک مجری ثابت | یک صدای چندزبانه، تا هر نسخه همان هویت صوتی را حفظ کند | یک صدای متفاوت برای هر زبان؛ که هر بار شبیه یک آدم دیگر به گوش میرسد |
لهجه همان تنظیمی است که بیشتر از همه اشتباه انتخاب میشود. اگر مخاطب شما در لندن باشد و گویندهتان پرچم آمریکا داشته باشد، شنوندگان متوجه میشوند — حتی وقتی تکتک کلمات درست باشند. پرچم را متناسب با مخاطب انتخاب کنید، نه فقط بر اساس زبان.
دو ردیف آخر، دو جهت مخالف را نشان میدهند و هر دو هم درستاند — شما بین «اعتبار محلی» و «مجریِ ثابت» انتخاب میکنید. وقتی میخواهید هر نسخه حس محلی داشته باشد، برای هر بازار لهجه بومی همان منطقه را انتخاب کنید؛ وقتی ویدیوها آشکارا یک نفر هستند که با مخاطبهای مختلف صحبت میکند، یک صدای چندزبانه بردارید تا مجری در همه نسخهها یکسان بماند.
در زبان چینی، لهجه از همه مهمتر است، چون «چینی» در واقع سه گروه مخاطب متفاوت دارد. Mandarin برای سرزمین اصلی. Taiwanese Mandarin برای تایوان — زبان نوشتاری مشترک است، اما آهنگ گفتار و انتخاب واژهها بلافاصله مشخص میکند متن با لحن سرزمین اصلی خوانده شده است. و Cantonese برای هنگکنگ و گوانگدونگ که یک زبان گفتاری جداگانه است، نه یک لهجه؛ بنابراین صدای Mandarin به کار نمیآید. فیلتر Language را روی زبانی بگذارید که مخاطب واقعاً صحبت میکند، سپس پیشنمایش بگیرید: یک بیننده تایپهای، صدای Mandarinِ سرزمین اصلی را همانطور میشنود که یک بیننده لندنی، صدای دارای پرچم آمریکا را میشنود.
انتخاب بر اساس موتور صدا
فیلتر Provider در مرحله 2، کتابخانه را بر اساس موتوری که هر صدا را تولید میکند گروهبندی میکند. اغلب به آن نیاز ندارید، اما اگر یکی از این سناریوها برای شماست، کلی اسکرول کردن را کم میکند.
- ElevenLabs — بزرگترین کتابخانه و گستردهترین دامنه احساسی. برای روایت انگلیسی، کاراکترمحور و هر متنی که باید «بازی کند» نه صرفاً «اعلام کند»، از اینجا شروع کنید.
- Gemini — صداهای چندزبانه. یک صدا هویت خودش را در چند زبان حفظ میکند؛ پس وقتی یک ویدیو را در چند زبان منتشر میکنید و میخواهید مجری در همه نسخهها همان باشد، اینجا را بررسی کنید. این صداها فرقی نمیکند Language را روی چه زبانی فیلتر کنید، باز هم نمایش داده میشوند.
- MiniMax — طبیعیترین اجرای کانتونی. برای مخاطبان هنگکنگ و گوانگدونگ سراغش بروید.
- Seed — چینی در حد بومی (از جمله Taiwanese Mandarin) بهعلاوه صداهای ژاپنی، کرهای، اسپانیایی، پرتغالی و اندونزیاییِ بومی. وقتی «روان اما خارجی» برای آن بازار کافی نیست، امتحانش کنید.
اگر هیچکدام از اینها وضعیت شما نیست، Provider را روی All بگذارید و اجازه دهید پیشنمایش تصمیم بگیرد. تناسب صدا خیلی مهمتر از این است که کدام موتور آن را تولید کرده است.
مرحله 4: سرعت گفتار را تنظیم کنید، سپس مکث اضافه کنید
روی ردیف یک صدا کلیک کنید تا روی تنظیمات فعلی اعمال شود. سپس منوی سرعت کنار صدای انتخابشده را باز کنید و Slow (آهسته)، Normal (عادی) یا Fast (سریع) را انتخاب کنید.
- Slow برای توضیحهای تأملبرانگیز و هر محتوایی مناسب است که در آن درک مطلب مهمتر از شتاب است.
- Normal گزینه پایه و مطمئن برای بیشتر آموزشها، ارائهها و ویدیوهای آواتار سخنگو است.
- Fast به تیزرهای کوتاه و کلیپهای شبکههای اجتماعی انرژی میدهد، اما دنبال کردن متنهای فشرده را دشوارتر میکند.
سرعت، ریتم کل اجرا را تعیین میکند. برای کنترل درون یک جمله، مکاننما را دقیقاً همانجا بگذارید که مکث باید در آن باشد و روی کنترل Pause کلیک کنید. هر کلیک 0.5 ثانیه اضافه میکند؛ برای مکث طولانیتر دوباره کلیک کنید.
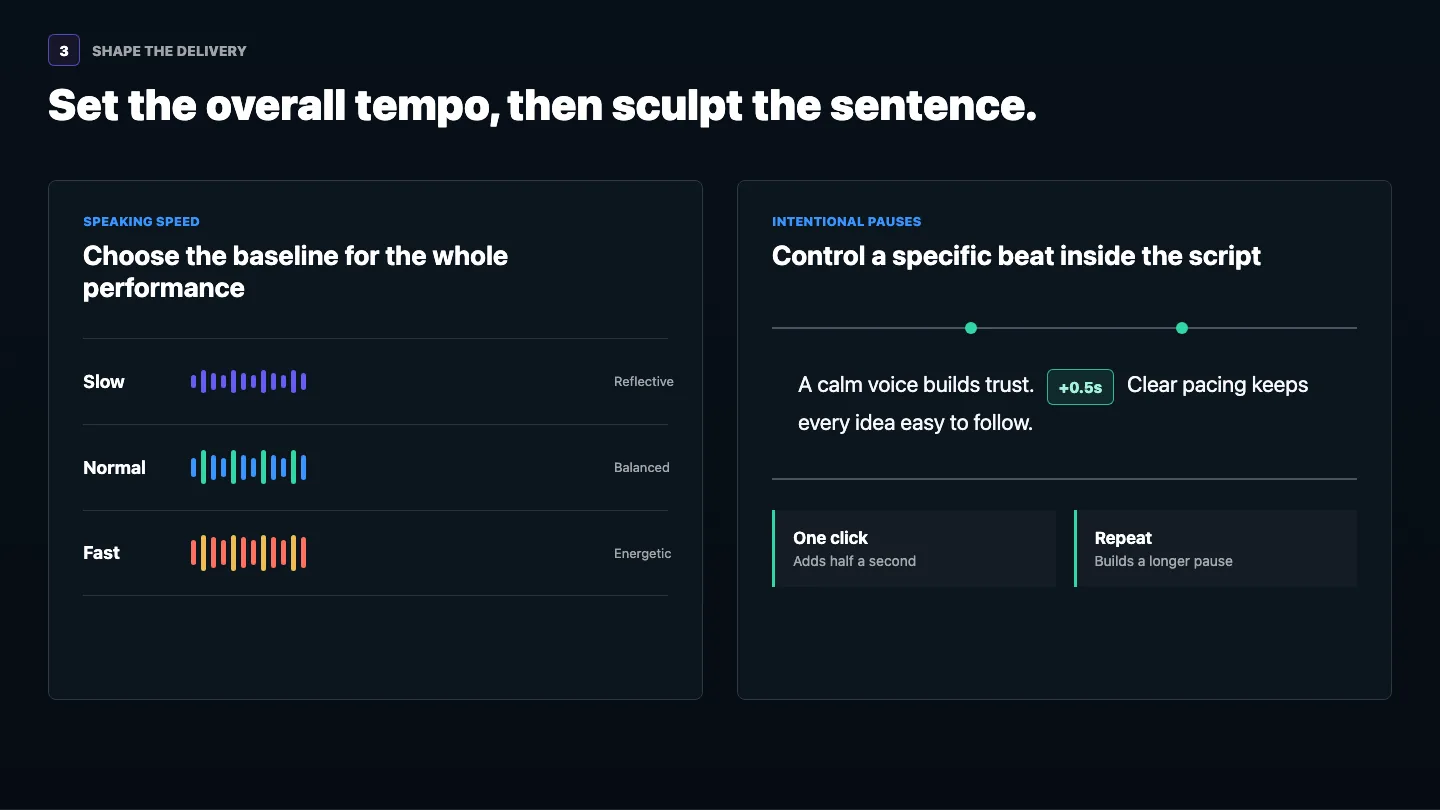
نکته کاربردی: مکثها را جایی اضافه کنید که یک گوینده واقعی نفس میکشد، موضوع را عوض میکند یا اجازه میدهد یک نکته جا بیفتد. مکث بیش از حد، اجرا را تکهتکه میکند؛ بنابراین پس از ویرایش، کل جمله را پیشنمایش بگیرید، نه فقط بخشی را که تغییر دادهاید.
مرحله 5: شیوه اجرا را با Voice Enhance هدایت کنید
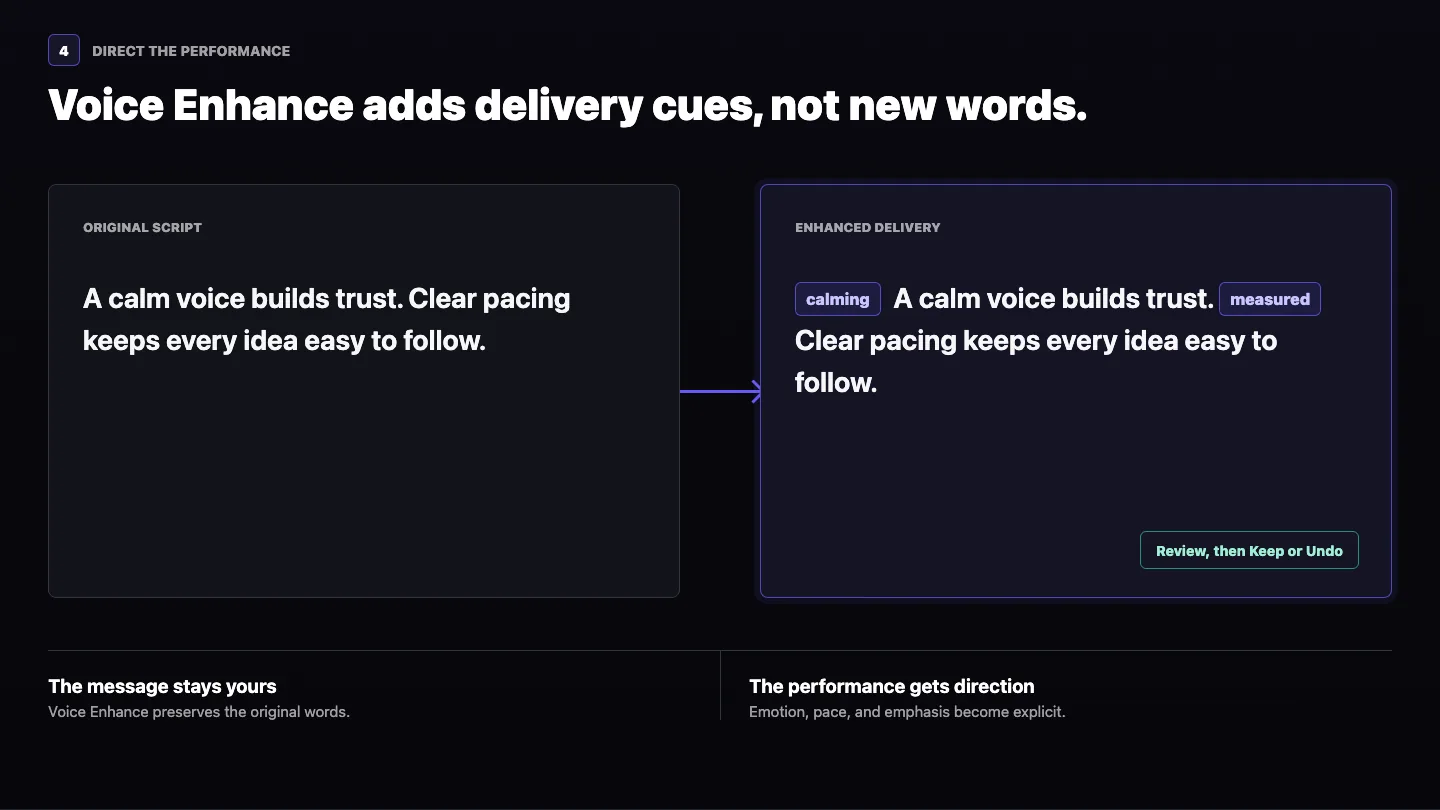
وقتی کلمات درست هستند اما اجرای موردنظرتان هنوز بهروشنی مشخص نیست، روی Voice Enhance کلیک کنید. VisionStory نشانههای اجرایی برای احساس، ریتم و تأکید اضافه میکند و در عین حال متن اصلی شما را حفظ میکند.
پیش از ادامه، متن بهبودیافته را بررسی کنید. اگر نشانهها با منظور شما همخوانی داشت Keep را انتخاب کنید، یا برای بازگشت به نسخه اصلی Undo را بزنید. این قابلیت وقتی واقعاً به کار میآید که متن به جهتدهی احساسی روشنی نیاز دارد اما نباید بازنویسی شود.
مرحله 6: پیش از تولید، متن واقعی خود را پیشنمایش بگیرید
وقتی صدا، سرعت، مکثها و نشانههای Voice Enhance تنظیم شد، روی Preview Audio کلیک کنید. بهجای قضاوت بر اساس چند کلمهٔ اول، کل نسخه را گوش کنید و تلفظ، لهجه، ریتم، پایان جملهها، مکثها و تناسب احساسی را بررسی کنید.
وقتی هنوز در حال مقایسهٔ گزینهها هستید، با یک جملهٔ کوتاه و نماینده شروع کنید. بهمحض اینکه فهرست کوتاه به دو یا سه صدا رسید، بخشی را پیشنمایش بگیرید که شامل نامها، اعداد، اصطلاحات تخصصی یا لحظههای احساسی مهم ویدیوی نهایی باشد — تفاوت صداها دقیقاً همانجا مشخص میشود.
سهمیهٔ پیشنمایش: پیشنمایش صدا شامل سهمیهٔ رایگانی از کاراکتر است که در چرخهای متحرک و 24 ساعته تازه میشود. پس از مصرف این سهمیه، تولید پیشنمایش 1 اعتبار بهازای هر 500 کاراکتر هزینه دارد. برای تصویر کامل، نحوهٔ کار اعتبار VisionStory را ببینید.
مرحله 7: یکبار ویدیو بسازید تا آواتار صدا را به خاطر بسپارد
انتخاب یک صدا، تنظیمات فعلی ویرایشگر را تغییر میدهد، اما انتخاب بهتنهایی آن صدا را روی آواتار ذخیره نمیکند. با صدایی که انتخاب کردهاید یک ویدیو بسازید. آنگاه VisionStory این جفتشدن را به خاطر میسپارد و دفعهٔ بعد که از همان آواتار استفاده کنید، آن را بازیابی میکند.
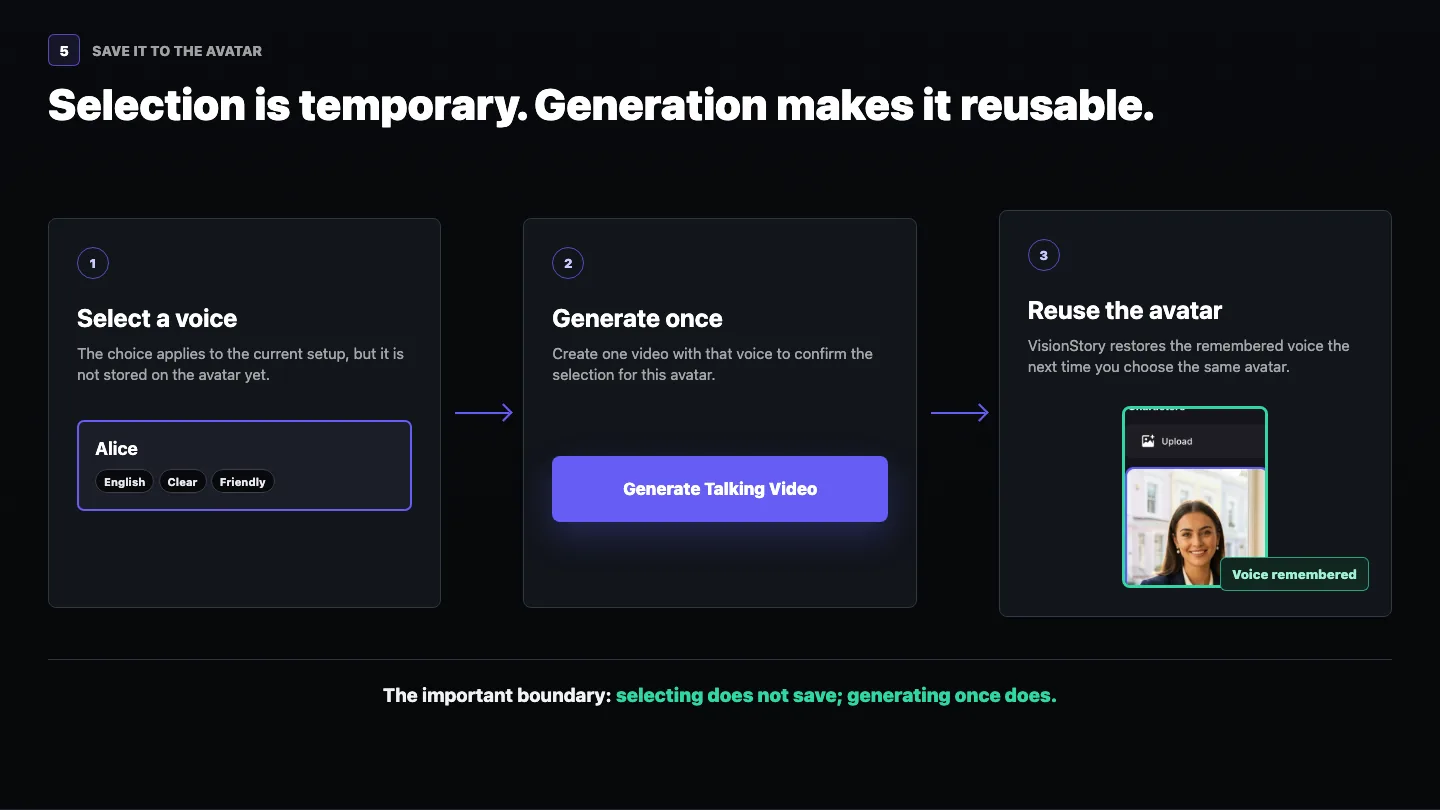
به همین دلیل است که ارزش دارد این انتخاب را با دقت انجام دهید. وقتی یک آواتار و یک صدا با هم جفت شدند، هر ویدیوی بعدی بهجای یک تصمیم تازه، از یک گویندهٔ ثابت آغاز میشود.
چرا صداهای هوش مصنوعی رباتیک به گوش میرسند — و چطور آن را برطرف کنیم
وقتی یک صداگذاری تولیدشده مصنوعی به نظر میرسد، معمولاً یکی از پنج علت قابلرفع مقصر است، نه خودِ مدل صدا.
- صدای نامناسب برای متن. صدایی که برای روایت ساخته شده، هنگام خواندن متن تبلیغاتی بیروح به نظر میرسد. پیش از آنکه کیفیت را مقصر بدانید، دوباره بر اساس کاربرد فهرست کوتاه بسازید.
- نبودِ مکث. گویندگان واقعی نفس میکشند. دیواری از متن بدون هیچ وقفهای مثل ماشین خوانده میشود؛ پس در مرز بین ایدهها مکثهای نیمثانیهای اضافه کنید.
- سرعتی که یکبار تنظیم و بعد فراموش شده است. سریع، جملههای فشرده را نامفهوم میکند و آهسته، یک تیزر کوتاه را کِش میدهد. تمپو را با نوع محتوا هماهنگ کنید.
- نشانهگذاری مبهم. جملههای بیپایان، ویرگولهای جاافتاده و اختصارهای بازنشده، همگی صدا را به سمت یکنواختی میبرند. اول متن را تمیز کنید.
- نبودِ جهتدهی احساسی. اگر نیت در خودِ متن نباشد، صدا نمیتواند آن را حدس بزند — و کاربرد Voice Enhance دقیقاً همین است.
این پنج مورد را اصلاح کنید تا بیشتر گلایهها دربارهٔ رباتیک بودن صداهای هوش مصنوعی، بدون تغییر دادن خودِ صدا از بین برود.
اگر ارائهدهنده، صدایی را که استفاده میکنید از دسترس خارج کند
VisionStory صداها را از چند ارائهدهنده تأمین میکند و ممکن است یک ارائهدهنده صدایی را از کاتالوگ خودش حذف کند. در این حالت، آن صدا دیگر قابل بازگرداندن به Voice Library عمومی نیست.
اگر صدایی که به آن تکیه کرده بودید دیگر در دسترس نیست، بخشی تمیز از یکی از ویدیوهای قبلی خود را پیدا کنید که فقط همان صدا در آن شنیده میشود و آن را بهعنوان صدای منبع در Voice Clone استفاده کنید. شبیهسازی میتواند جایگزینی نزدیک بسازد، هرچند نباید انتظار داشت کاملاً یکسان به گوش برسد.
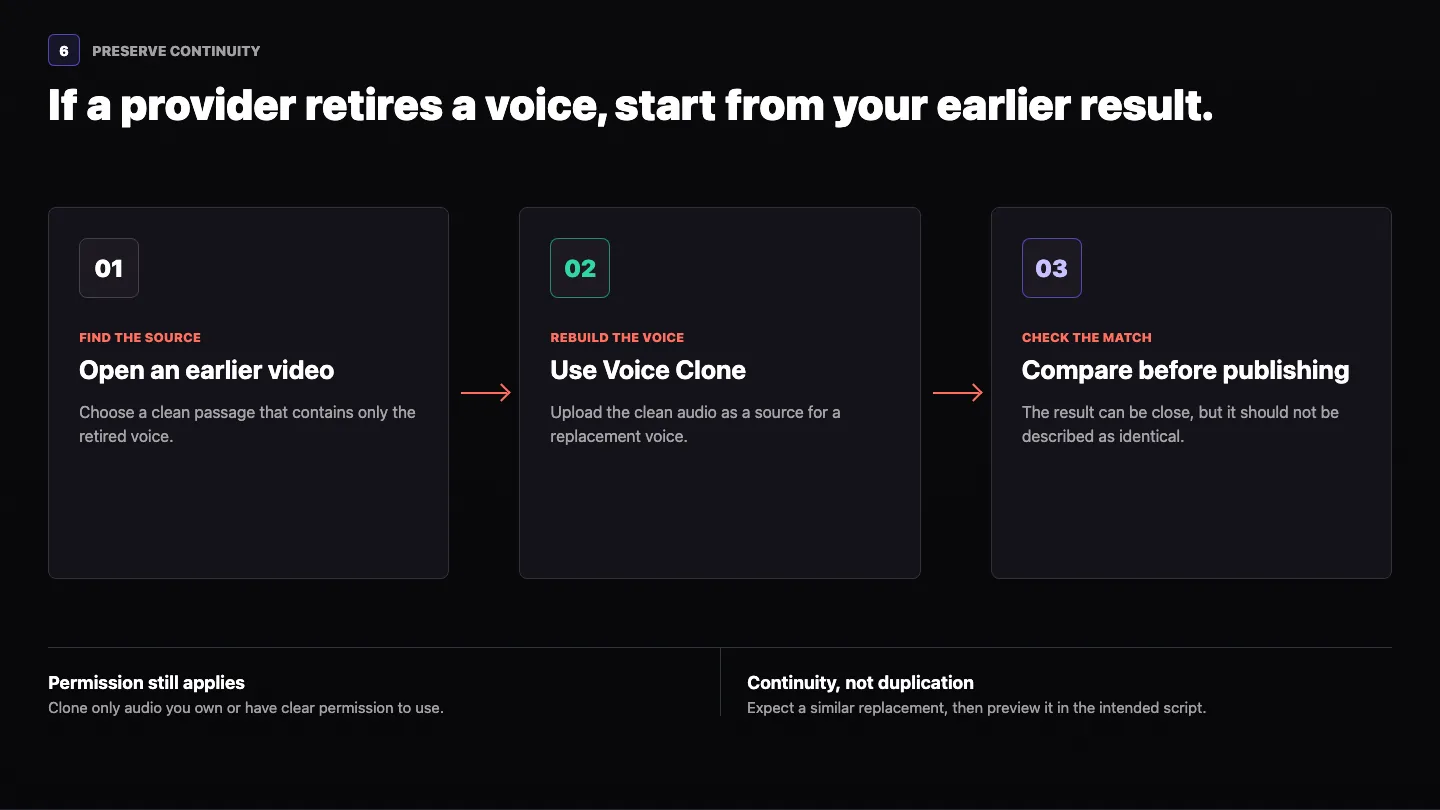
نیاز به مجوز: فقط صدایی را شبیهسازی کنید که مالک آن هستید یا مجوز روشنی برای استفاده از آن دارید، و پیش از انتشار، صدای جایگزین را با متن موردنظر خود پیشنمایش بگیرید.
چکلیست صدای هوش مصنوعی پیش از تولید
- لهجه منطقهای مناسب مخاطب را انتخاب کنید، نه فقط زبان را.
- با برچسبهای پروفایل یک فهرست کوتاه بسازید، سپس تصمیم نهایی را با گوش خود بگیرید.
- نامها، اعداد و اصطلاحهای دشوارِ متن واقعی خود را پیشنمایش بگیرید.
- سرعت کلی را پیش از افزودن مکثهای موضعی تنظیم کنید.
- از Voice Enhance فقط زمانی استفاده کنید که اجرا به راهنمایی روشنتری نیاز دارد.
- یک پیشنمایش کامل را گوش دهید، نه فقط جمله اول را.
- یک بار ویدیو تولید کنید تا آواتار صدا را به خاطر بسپارد.
- نام صدای انتخابشده را در یادداشتهای برند یا کمپین خود ثبت کنید.
وقتی صدا نهایی شد، بقیه کار سریع پیش میرود. همین تنظیمات را با نحوه ساخت آواتار سخنگوی هوش مصنوعی تا ویدیوی نهایی ادامه دهید، یا اگر فقط به بخش صوتی نیاز دارید، تبدیل متن به گفتار را باز کنید.
