Generatore di Video Lip Sync AI

Scegli un volto, aggiungi l’audio e ottieni un video in cui le labbra seguono ogni parola. Scrivi un copione, carica il tuo audio o registralo nel browser — VisionStory sincronizza bocca, espressione e movimento della testa con ciò che senti.

Inizia il lip sync
3modi per aggiungere l’audio
88lingue per i copioni
1.000+Voci AI
2Kexport massimo

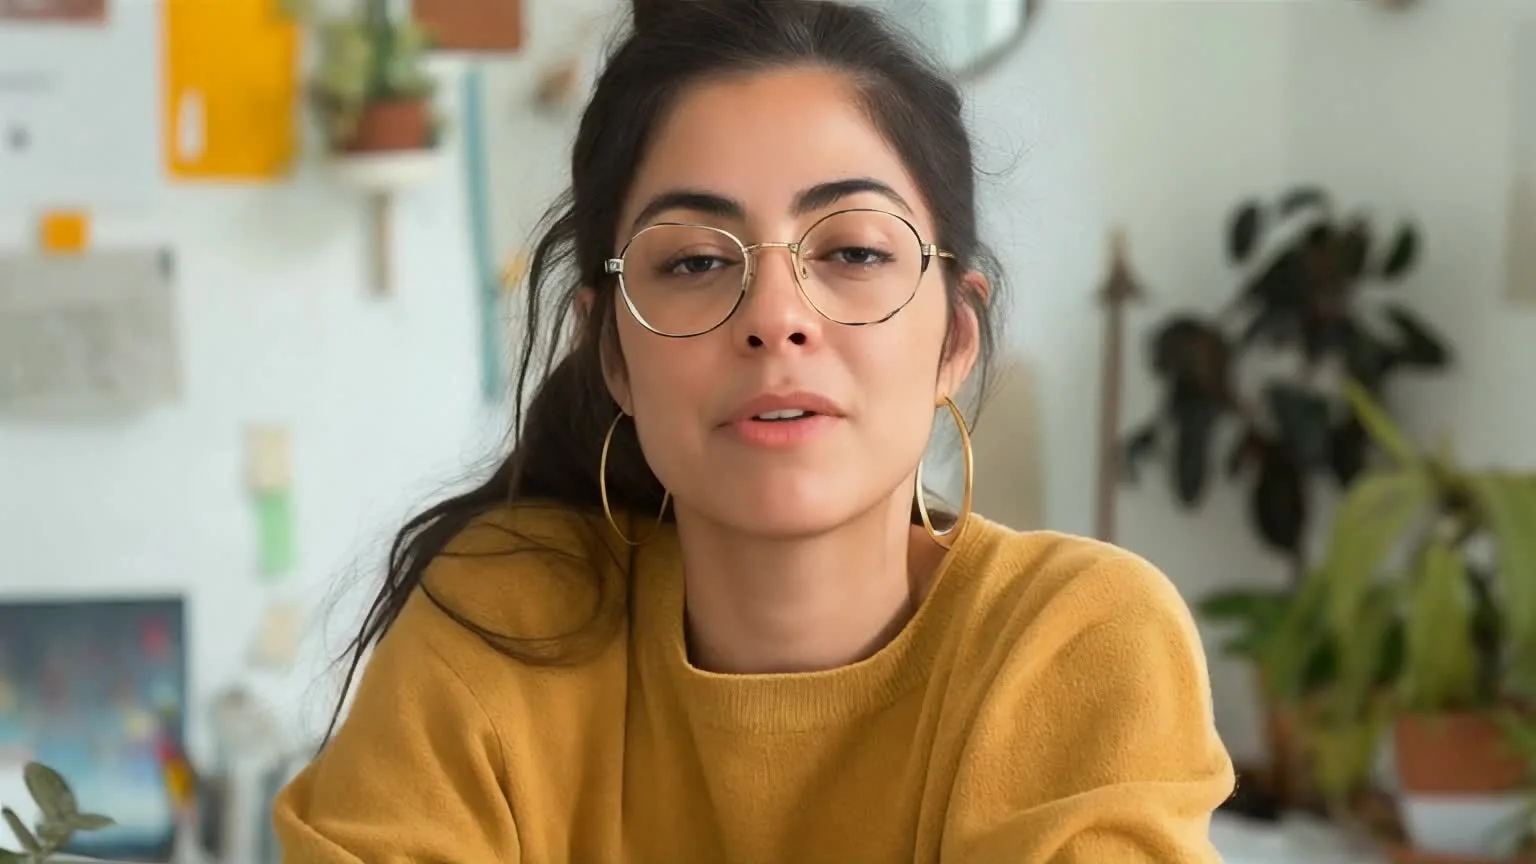
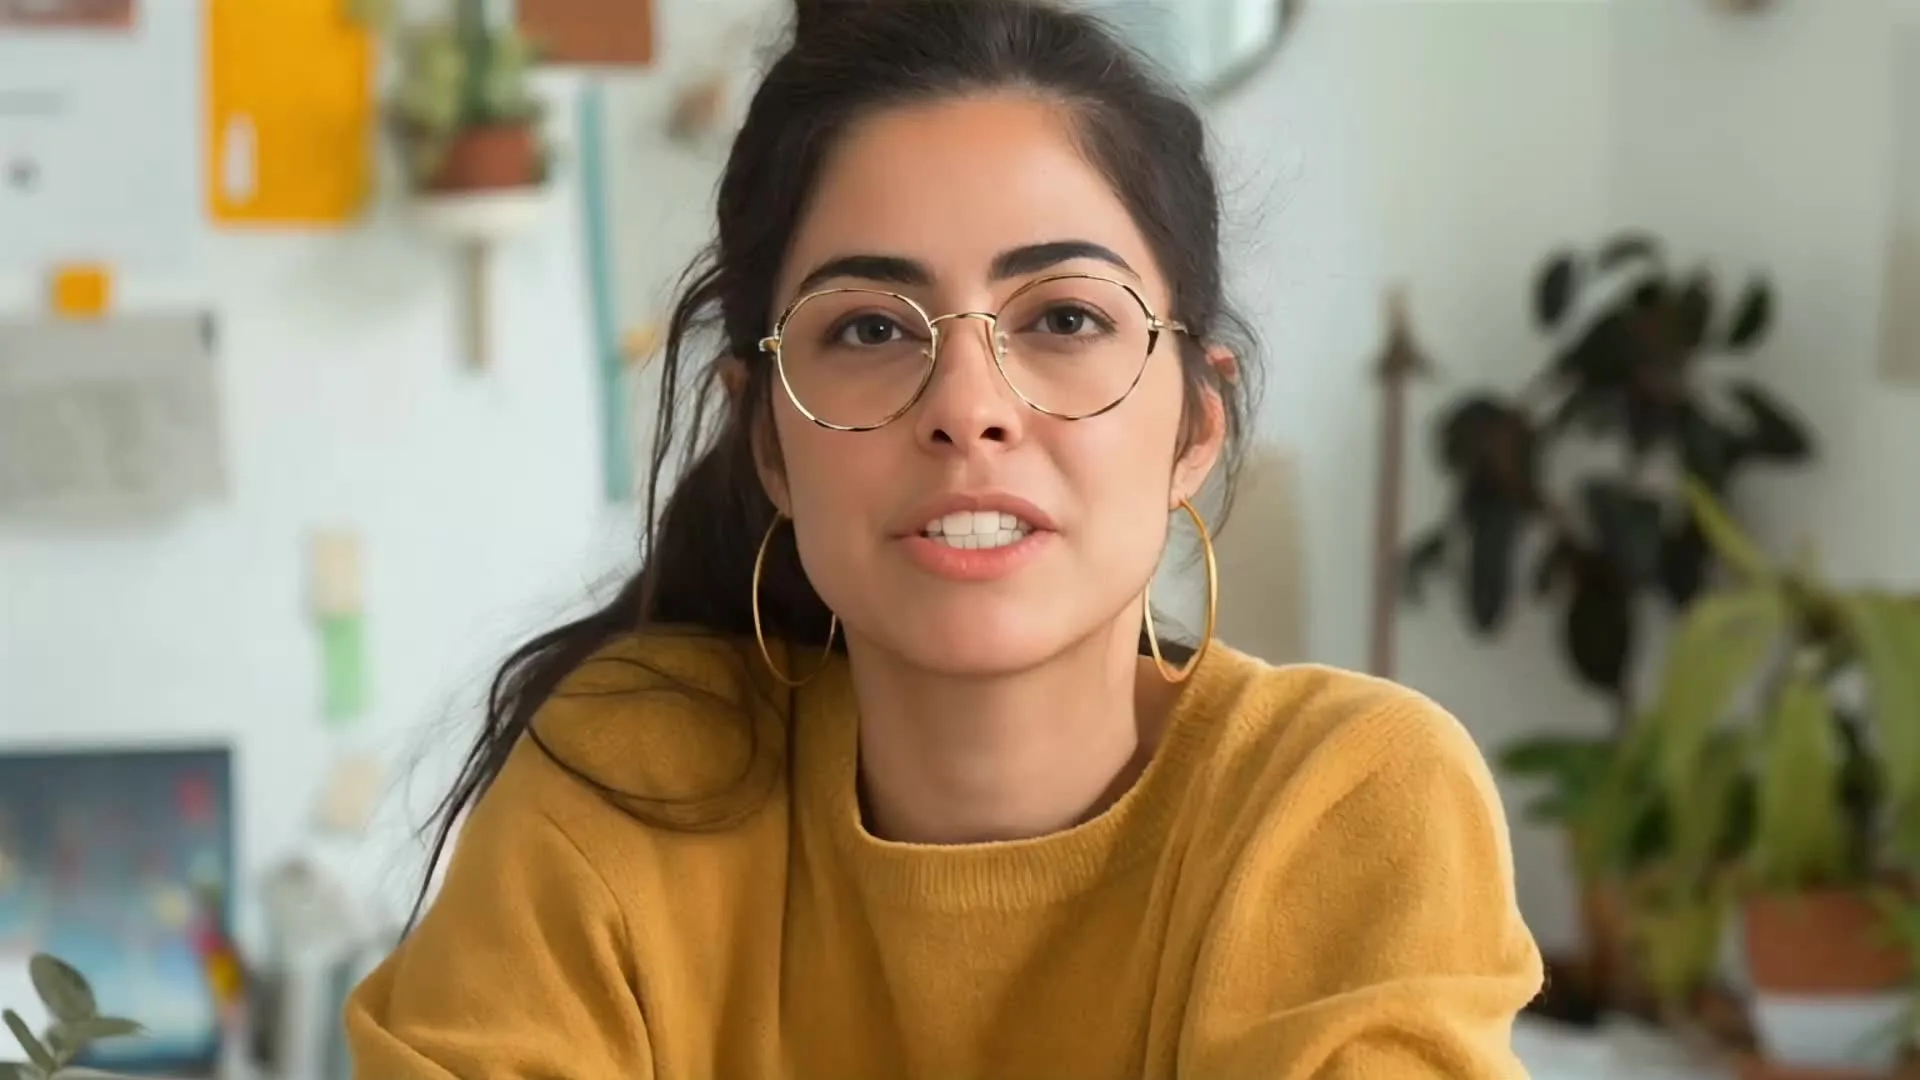
Ascolta: la stessa foto che parla

Attiva l’audio. Lo stesso ritratto qui sopra presenta un’introduzione al corso di 15 secondi — forme della bocca, pause ed espressione seguono la voce.

Input audio

Tre modi per guidare il lip sync

Parti dall’audio che hai già — oppure da poche righe di testo.

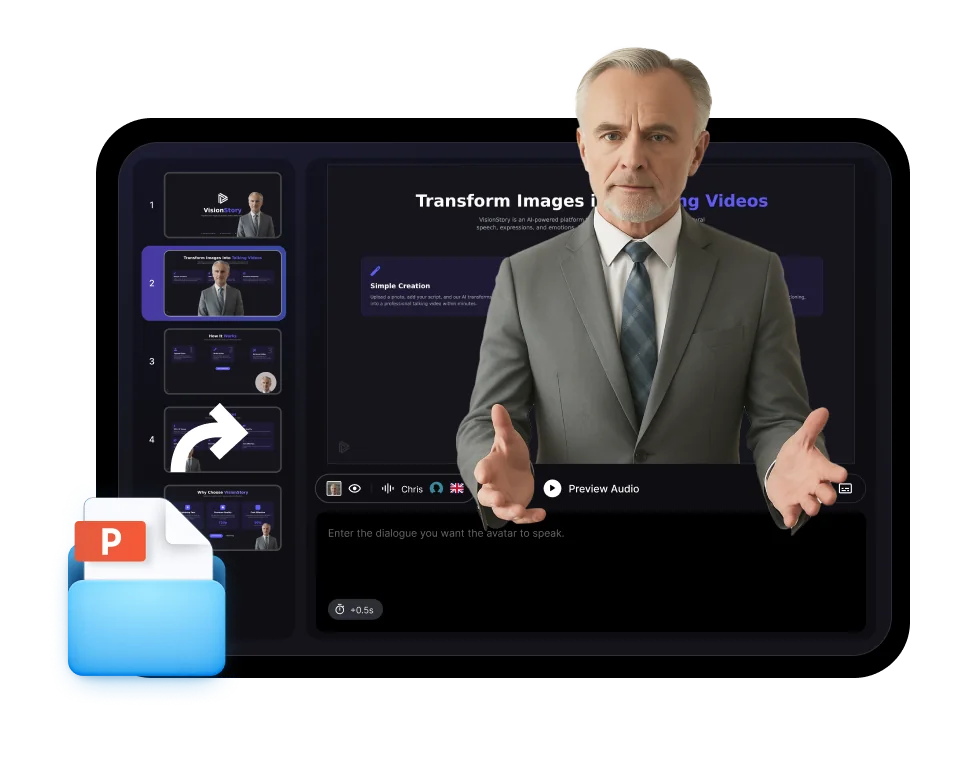
Script

Scrivi le battute

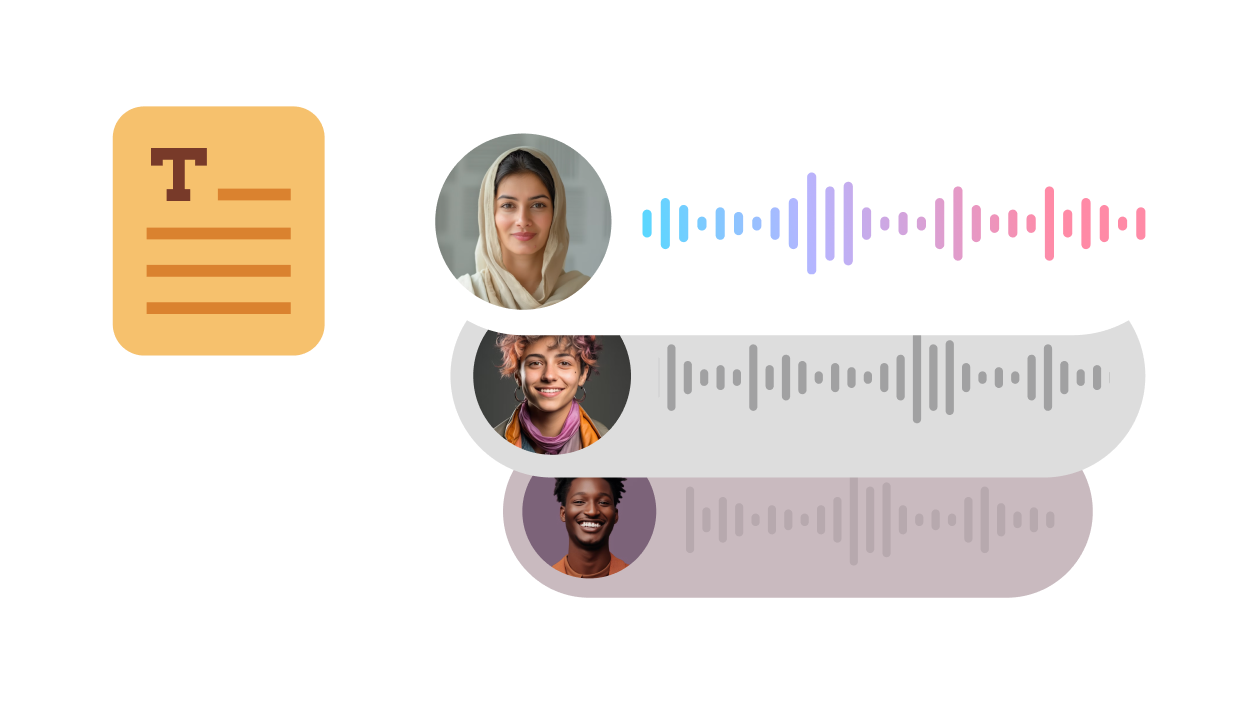
Scrivi ciò che il personaggio deve dire, scegli una delle oltre 1.000 voci AI in 88 lingue e la bocca segue la voce generata.

Importa

Carica il tuo audio

Carica una voce fuori campo, una clip di un podcast, una risposta di un’intervista o una canzone e sincronizza il volto con quella registrazione esatta.

Registra

Dillo tu

Registra la tua voce nel browser e trasformala in un video in lip sync senza lasciare la pagina.

Un volto, tre performance

La stessa foto in lip sync con tre tracce audio diverse. L’interpretazione cambia l’intera clip — ritmo, espressione ed energia seguono ciò che il personaggio sta dicendo.

Lip sync AI di una foto ritratto con narrazione calma

Narrazione calma

Ritmo regolare e sguardo stabile per video esplicativi, aggiornamenti e lezioni.

Lip sync AI dello stesso ritratto con interpretazione energica

Interpretazione energica

Un’espressione più vivace per saluti, promo e hook per i social.

Lip sync AI dello stesso ritratto con interpretazione intensa

Interpretazione intensa

Un’espressione più incisiva per sketch, reaction e scene con personaggi.

Come funziona

Crea il lip sync di un video in tre passaggi

Niente riprese, keyframe o montaggio sulla timeline — solo un volto e un audio.

01

Scegli il volto

Carica una foto nitida e frontale, scegli un avatar già pronto oppure genera un nuovo personaggio da un prompt di testo.

02

Aggiungi l’audio

Scrivi un copione e scegli una voce, carica un file audio oppure registra la tua voce.

03

Genera e scarica

Scegli 720P, 1080P o 2K, genera il video e scarica il risultato in lip sync.

Perché VisionStory

Un lip sync che sembra una vera performance

Forme della bocca accurate sono solo l’inizio. Espressioni, battiti di ciglia e movimento della testa fanno sembrare il risultato parlato, non animato.

01

Forme della bocca che seguono il suono

La bocca segue ogni sillaba dell’audio, così le labbra si posano sulle parole invece di aprirsi e chiudersi solo in base al volume.

02

Volti oltre le persone reali

Fai il lip sync a ritratti, personaggi illustrati, mascotte di brand, animali e figure generate dall’AI — qualsiasi cosa con un volto ben visibile.

03

La tua registrazione, così com’è

Quando importi o registri l’audio, VisionStory mantiene la tua voce e sincronizza il volto con i suoi tempi. Vuoi una voce diversa? La funzione Cambia Voce converte la registrazione mantenendo la performance.

04

Pulisci l’audio sorgente

Attiva Rimuovi Rumore per le registrazioni importate con ronzio ambientale o rumore di fondo, così sia la voce sia la bocca risultano nitide.

05

88 lingue, oltre 1.000 voci

Non hai ancora una registrazione? Scrivi il copione in una qualsiasi delle 88 lingue e scegli tra oltre 1.000 voci AI.

06

Espressione e movimento della testa

Battiti di ciglia, espressione facciale e movimento naturale della testa vengono sincronizzati, così una foto statica diventa un oratore credibile.

07

Esporta fino a 2K

Genera in 720P, 1080P o 2K per post social, presentazioni, video di prodotto e annunci.

08

Verticale, quadrato o widescreen

Inquadra il video in 9:16, 1:1 o 16:9, così si adatta a Shorts, Reels, TikTok, ai feed o a YouTube senza doverlo ritagliare di nuovo.

FAQ sul Lip Sync AI

  • Il lip sync AI sincronizza i movimenti della bocca di un personaggio con una traccia audio. In VisionStory fornisci un volto — una foto, un’illustrazione o un avatar già pronto — e l’audio da un copione, da un upload o da una registrazione. VisionStory genera quindi un video in cui labbra, espressioni e movimenti della testa seguono il suono.