مولد فيديو مزامنة الشفاه بالذكاء الاصطناعي
اختر وجهًا، وأضف الصوت، واحصل على فيديو تتطابق فيه الشفاه مع كل كلمة. اكتب نصًا، أو ارفع صوتك، أو سجّله داخل المتصفح — يقوم VisionStory بمزامنة الفم وتعابير الوجه وحركة الرأس مع ما تسمعه.
ابدأ مزامنة الشفاهاختر وجهًا، وأضف الصوت، واحصل على فيديو تتطابق فيه الشفاه مع كل كلمة. اكتب نصًا، أو ارفع صوتك، أو سجّله داخل المتصفح — يقوم VisionStory بمزامنة الفم وتعابير الوجه وحركة الرأس مع ما تسمعه.
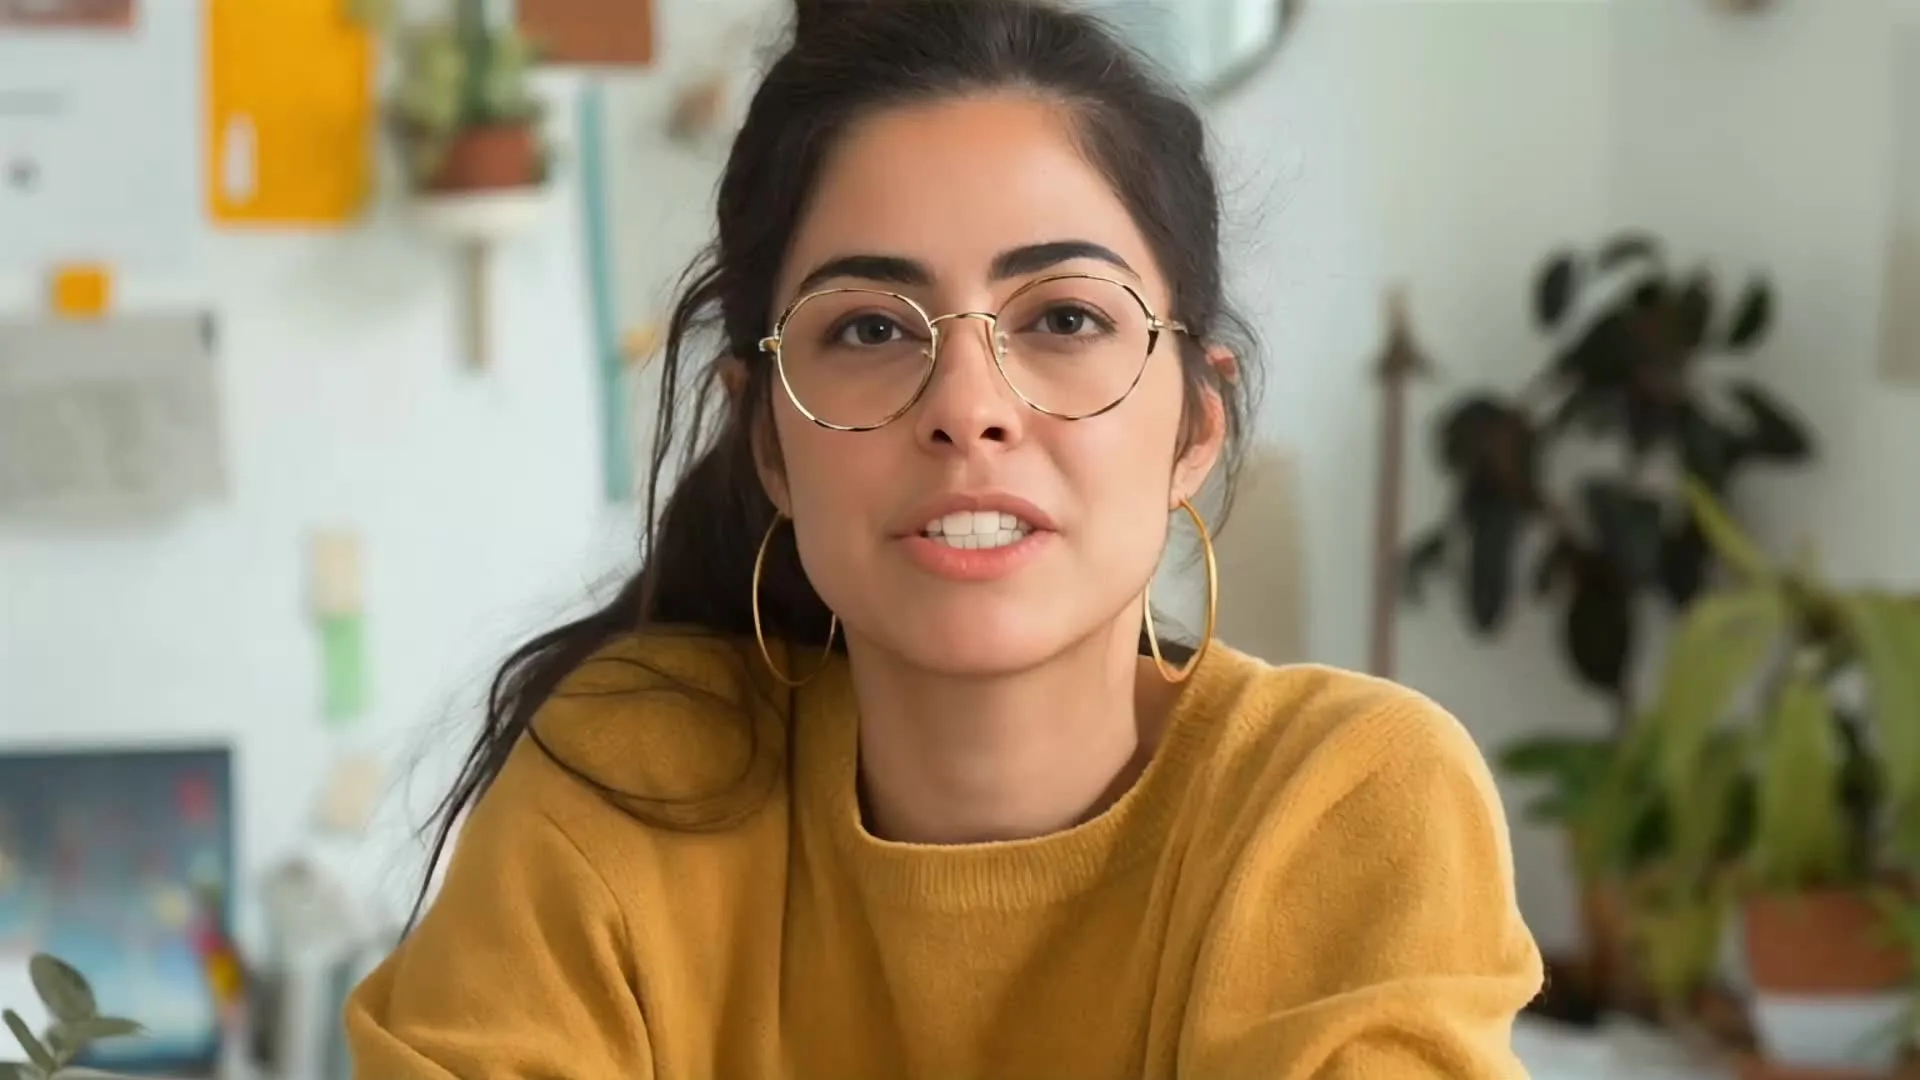
ابدأ مزامنة الشفاهشغّل الصوت. الصورة نفسها بالأعلى تقدّم مقدمة دورة مدتها 15 ثانية — أشكال الفم والتوقفات وتعابير الوجه تتبع الصوت.
إدخال الصوت
ابدأ من الصوت الذي لديك بالفعل — أو من بضعة أسطر نصية فقط.
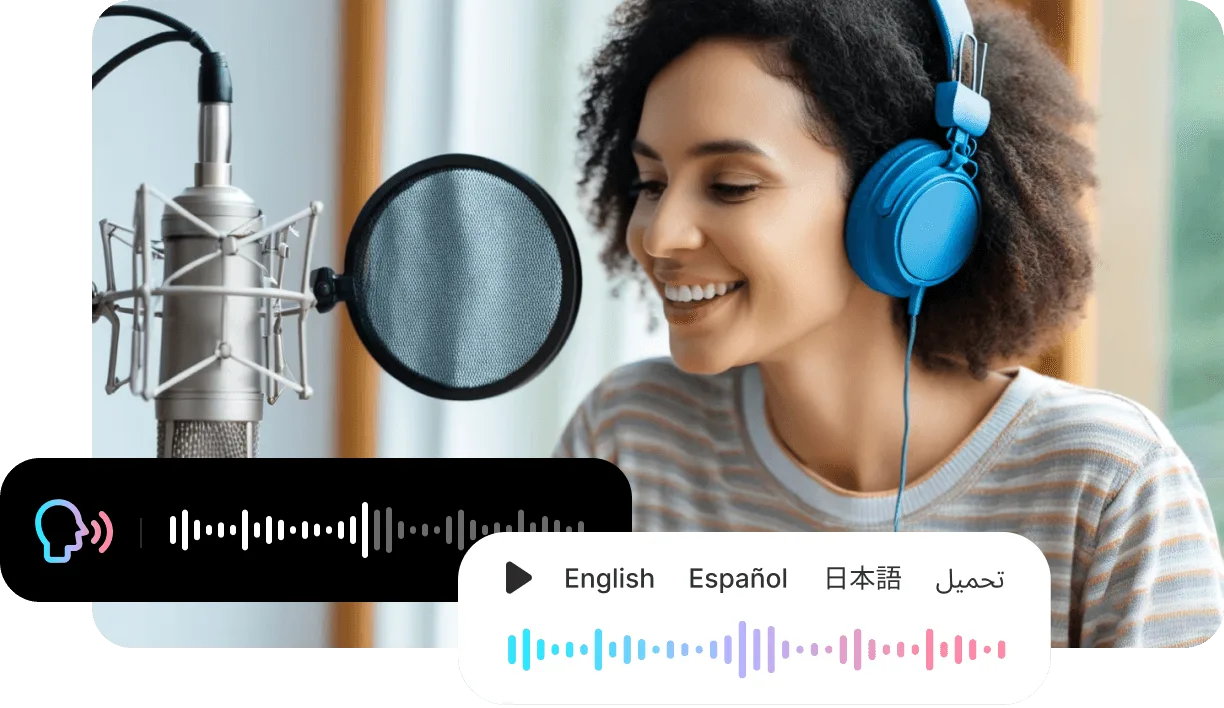
اكتب ما يجب أن تقوله الشخصية، واختر واحدًا من أكثر من 1,000 صوت بالذكاء الاصطناعي عبر 88 لغة، وسيتبع الفم الكلام المُولّد.
أضف تعليقًا صوتيًا، أو مقطع بودكاست، أو إجابة مقابلة، أو أغنية، ثم زامن الوجه مع هذا التسجيل نفسه.
سجّل صوتك داخل المتصفح وحوّله إلى فيديو بمزامنة شفاه دون مغادرة الصفحة.
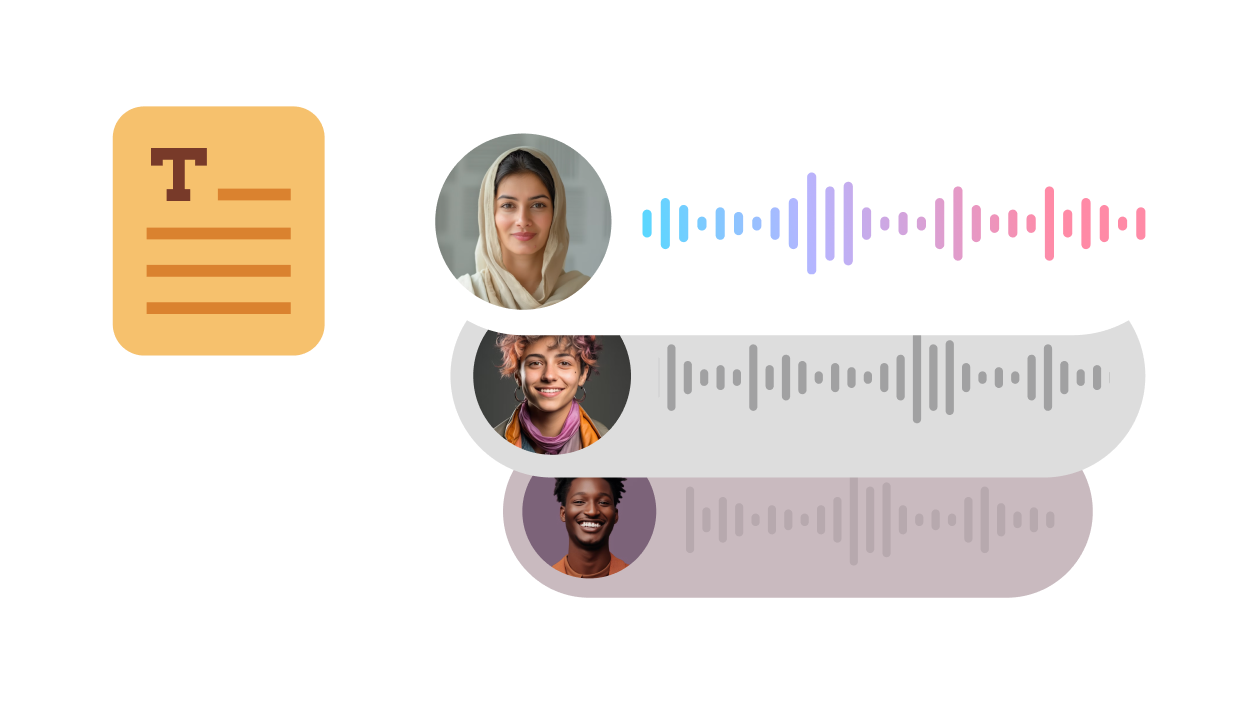
الصورة نفسها مع مزامنة شفاه لثلاثة مسارات صوتية مختلفة. طريقة الإلقاء تغيّر المقطع بالكامل — الإيقاع وتعابير الوجه والطاقة تتبع ما تقوله الشخصية.
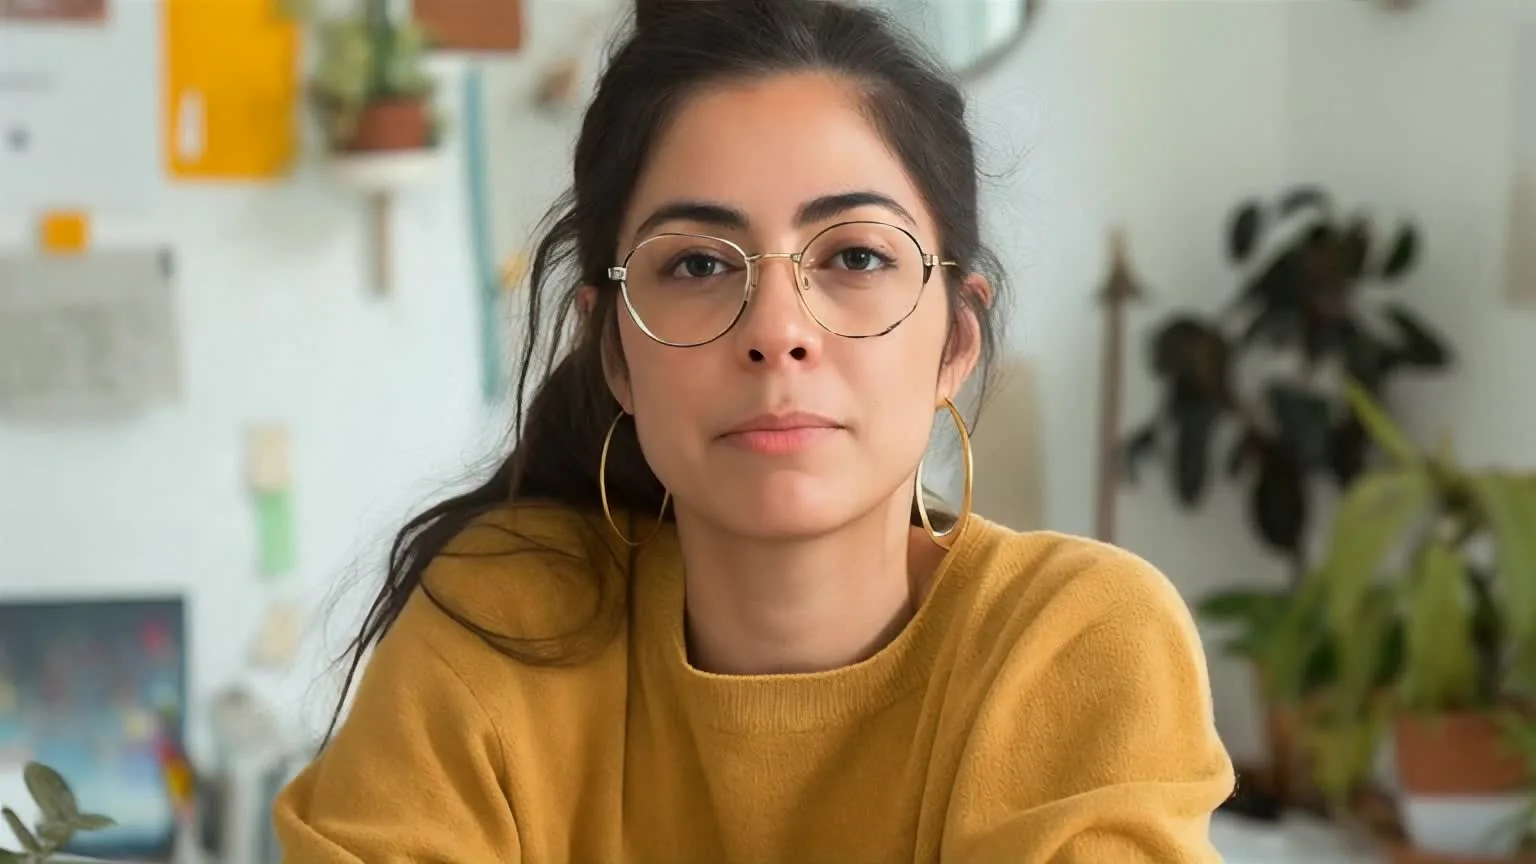
إيقاع متوازن وتواصل بصري ثابت لشرح الأفكار والتحديثات والدروس.
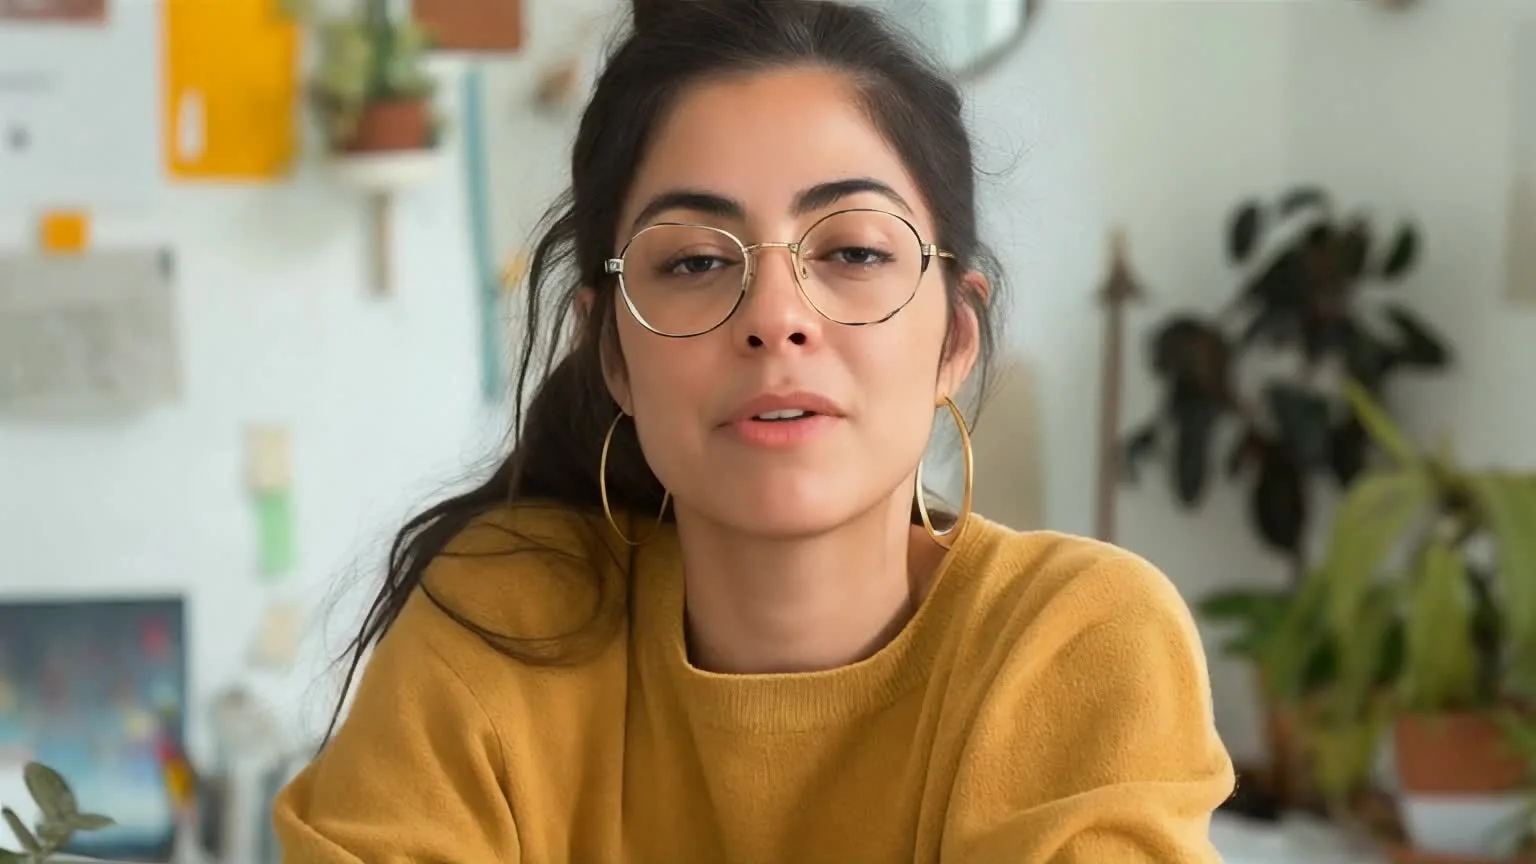
تعابير أكثر إشراقًا للتحيات والعروض الترويجية والجمل الجاذبة على السوشيال.
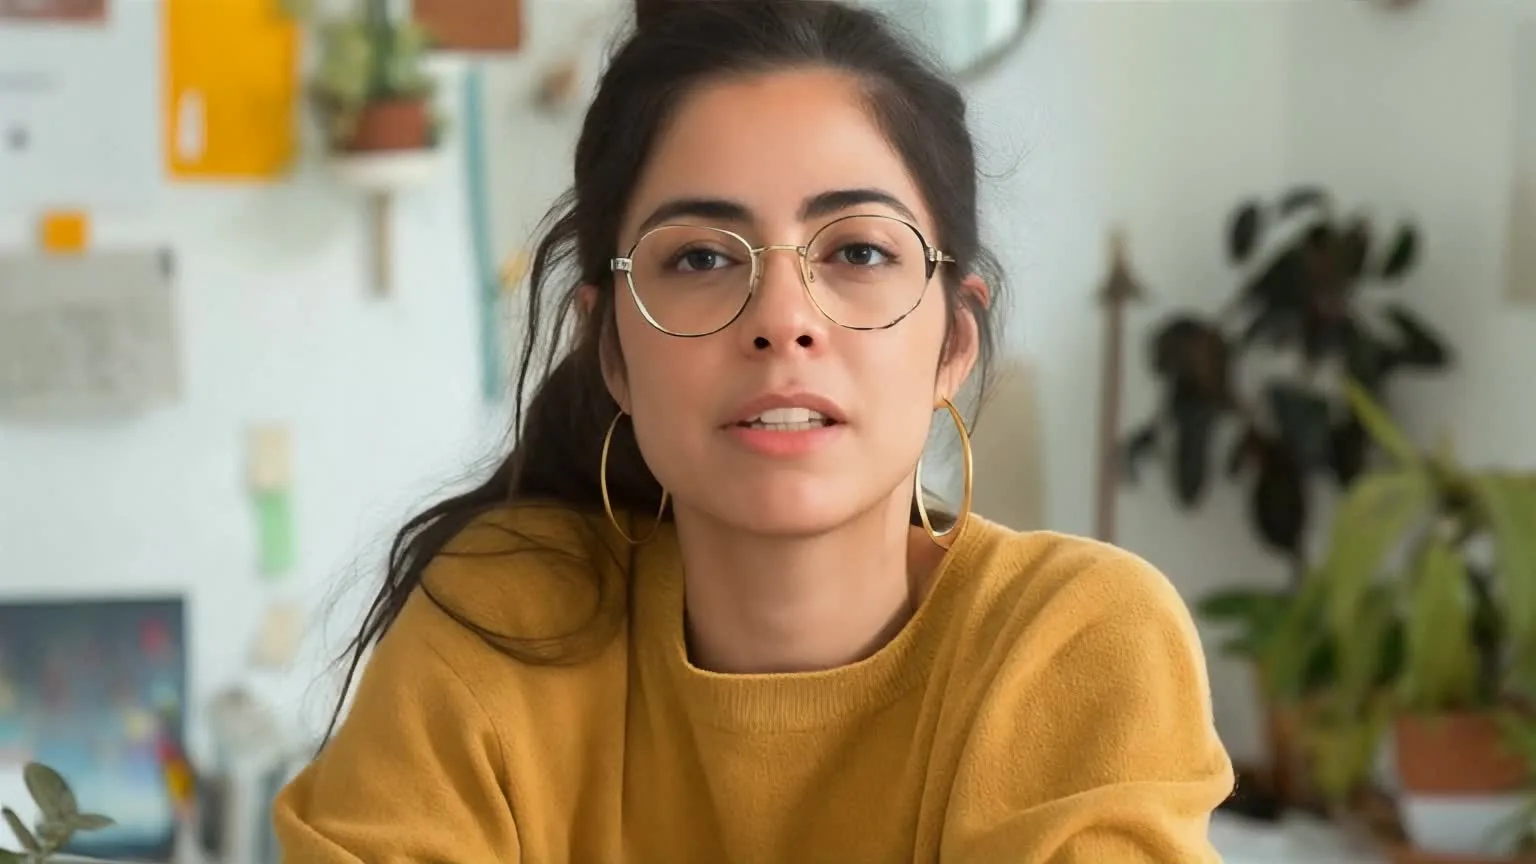
تعابير أكثر حدّة للمشاهد الكوميدية وردود الفعل ومشاهد الشخصيات.
كيف يعمل
لا تصوير ولا إطارات مفتاحية ولا تحرير على الخط الزمني — فقط وجه وصوت.
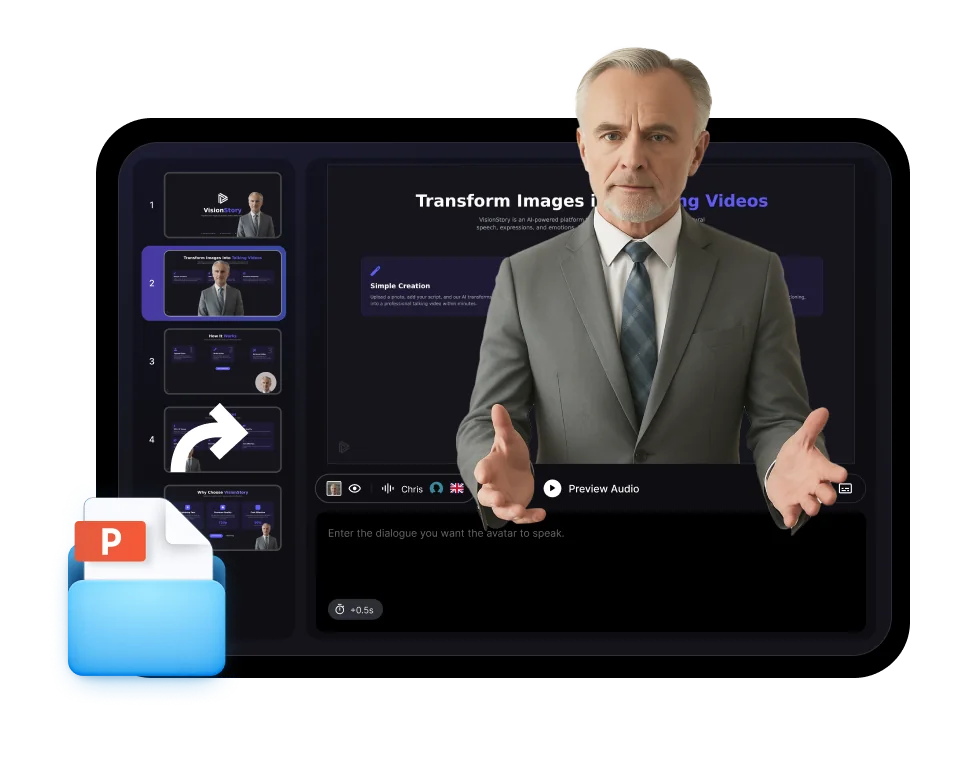
ارفع صورة واضحة من الأمام، أو اختر أفاتارًا جاهزًا، أو أنشئ شخصية جديدة من خلال مطالبة نصية.
اكتب نصًا واختر صوتًا، أو ارفع ملفًا صوتيًا، أو سجّل صوتك.
اختر 720P أو 1080P أو 2K، ثم أنشئ الفيديو وحمّل النتيجة بمزامنة الشفاه.
لماذا VisionStory
أشكال فم دقيقة هي البداية. التعابير والرمشات وحركة الرأس تجعل النتيجة تبدو كلامًا حقيقيًا لا مجرد تحريك.
يتبع الفم كل مقطع صوتي، فتستقر الشفاه على الكلمات بدلًا من مجرد الفتح والإغلاق حسب مستوى الصوت.
زامن الشفاه لصور بورتريه، وشخصيات مرسومة، وتمائم العلامات التجارية، وحيوانات، وشخصيات مولّدة بالذكاء الاصطناعي — أي شيء بوجه واضح.
عند استيراد الصوت أو تسجيله، يحتفظ VisionStory بصوتك ويزامن الوجه مع توقيته. تريد صوتًا مختلفًا؟ تقوم ميزة «تغيير الصوت» بتحويل التسجيل مع الحفاظ على الأداء.
فعّل إزالة الضوضاء للتسجيلات المستوردة التي تحتوي على أزيز الغرفة أو ضجيج الخلفية، ليظهر كلّ من الصوت وحركة الفم بوضوح.
لا يوجد تسجيل بعد؟ اكتب النص بأي من 88 لغة واختر من أكثر من 1,000 صوت بالذكاء الاصطناعي.
تأتي الرمشات وتعابير الوجه وحركة الرأس الطبيعية مع المزامنة، فتتحول الصورة الثابتة إلى متحدث واقعي.
أخرِج الفيديو بدقة 720P أو 1080P أو 2K لمنشورات السوشيال والعروض التقديمية وفيديوهات المنتجات والإعلانات.
اضبط إطار الفيديو بنسبة 9:16 أو 1:1 أو 16:9 ليتناسب مع Shorts وReels وTikTok والموجزات أو YouTube دون الحاجة لإعادة القصّ.
مزامنة الشفاه بالذكاء الاصطناعي تطابق حركة فم الشخصية مع المسار الصوتي. في VisionStory، توفّر وجهًا — صورة أو رسماً توضيحيًا أو أفاتارًا جاهزًا — وصوتًا من نص أو ملف مرفوع أو تسجيل. ثم ينشئ VisionStory فيديو تتبع فيه الشفاه وتعبيرات الوجه وحركة الرأس الصوت.