
Jedes KI-Video beginnt mit einem Skript, aber die Stimme entscheidet darüber, wie dieses Skript tatsächlich ankommt. Sie bestimmt Akzent, Alter, Klangfarbe, Energie und Persönlichkeit Ihres Sprechers — und Geschwindigkeit, Pausen sowie Vortragshinweise entscheiden, ob das Ergebnis nach einem Menschen klingt oder nach einer Maschine, die eine Seite vorliest.
Kurz gesagt: Wählen Sie eine KI-Stimme, indem Sie Sprache und regionalen Akzent auf Ihr Publikum abstimmen, mithilfe der Profil-Tags eine engere Auswahl erstellen, jeden Kandidaten mit Ihrem eigenen Skript in der Vorschau anhören und den Vortrag anschließend über Geschwindigkeit und Pausen formen, bevor Sie generieren. Der Rest dieser Anleitung führt Sie Schritt für Schritt durch genau diesen Ablauf in VisionStory, dessen KI-Stimmenbibliothek mehr als 1.000 Stimmen in 88 Sprachen umfasst.
Worum es in dieser Anleitung geht: um die öffentliche Stimmenbibliothek und die dazugehörigen Steuerungen für den Vortrag. Eine Stimme aus Ihrer eigenen Aufnahme zu erstellen, ist ein separater Workflow — siehe So klonen Sie Ihre Stimme mit KI.
Schritt 1: Die Stimmenbibliothek öffnen und eine Stimmzeile lesen
Öffnen Sie KI-Video, wählen Sie den gewünschten Avatar aus und klicken Sie unter dem Skriptfeld auf die aktuelle Stimme. Die Stimmenbibliothek öffnet sich über dem Editor.
Jede Zeile enthält vier Signale, mit denen Sie vorhersagen können, wie ein Sprecher klingen wird, bevor Sie auf Play drücken:
- Sprach-Tag — die Sprache, welche die Stimme spricht.
- Flagge — der regionale Akzent, nicht eine zweite Sprache. Englische Stimmen können US-, UK-, kanadische und weitere Flaggen tragen.
- Geschlecht und Alter — die wahrgenommene Identität des Sprechers.
- Eigenschaften und Anwendungsfall — Beschreibungen wie klar, warm, umgangssprachlich, Erzählung, Bildung oder soziale Medien.
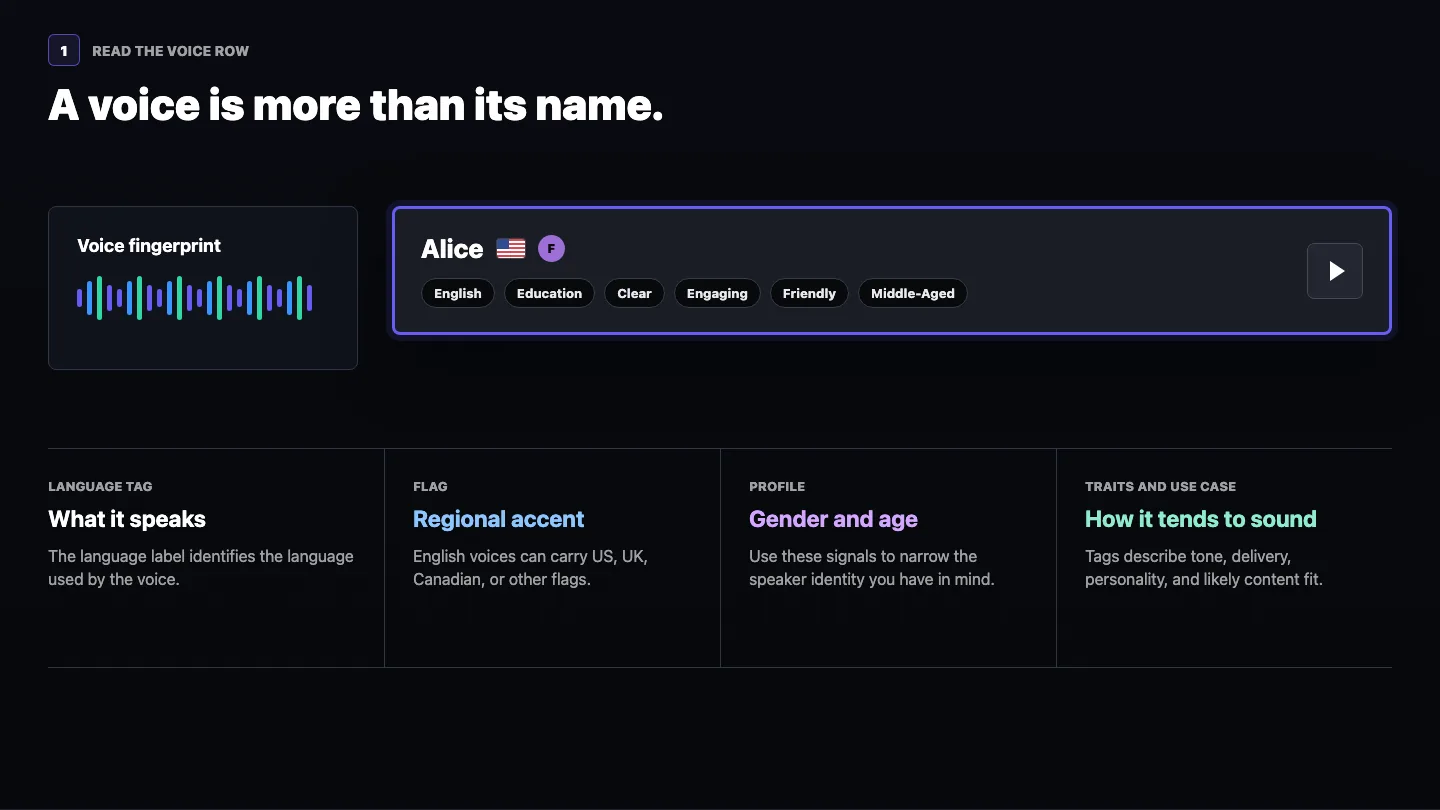
Nutzen Sie die Labels, um eine engere Auswahl zu erstellen, nicht um die endgültige Entscheidung zu treffen. Zwei Stimmen mit nahezu identischen Tags können sich in Tempo, Klangfarbe und Energie trotzdem deutlich unterscheiden.
Schritt 2: Filtern, suchen und eine engere Auswahl in der Vorschau anhören
Beginnen Sie breit genug, um echte Unterschiede zu hören, und grenzen Sie dann ein. Nutzen Sie die Filter Sprache, Geschlecht, Alter, Anwendungsfall und Anbieter, solange Sie noch ausprobieren. Wenn Sie eine Stimme bereits mit Namen kennen, geben Sie ihn stattdessen in das Suchfeld ein.
Anbieter ist der letzte Filter in der Reihe und steht für die Speech-Engine hinter einer Stimme. VisionStory nutzt mehrere davon, und jede ist in etwas anderem besonders stark. Lassen Sie ihn beim ersten Durchlauf auf All — Sie wollen die beste Stimme für dieses Skript, egal welche Engine sie erzeugt hat. Greifen Sie nur dann zum Filter, wenn Sie schon wissen, was Sie brauchen, etwa eine kantonesische Stimme oder eine Stimme, die mehrere Sprachen abdecken muss. In Schritt 3 geht es darum, welche Engine Sie in diesen Fällen wählen sollten.
- Engere Auswahl erstellen. Filtern oder suchen Sie so lange, bis Sie eine Handvoll Kandidaten statt eines ganzen Katalogs vor sich haben.
- Die Auswahl durchhören. Klicken Sie rechts in einer Stimmzeile auf die Play-Schaltfläche, um die Hörprobe abzuspielen.
- Pausieren und vergleichen. Klicken Sie erneut auf dieselbe Schaltfläche, um zu stoppen, bevor Sie die nächste starten.
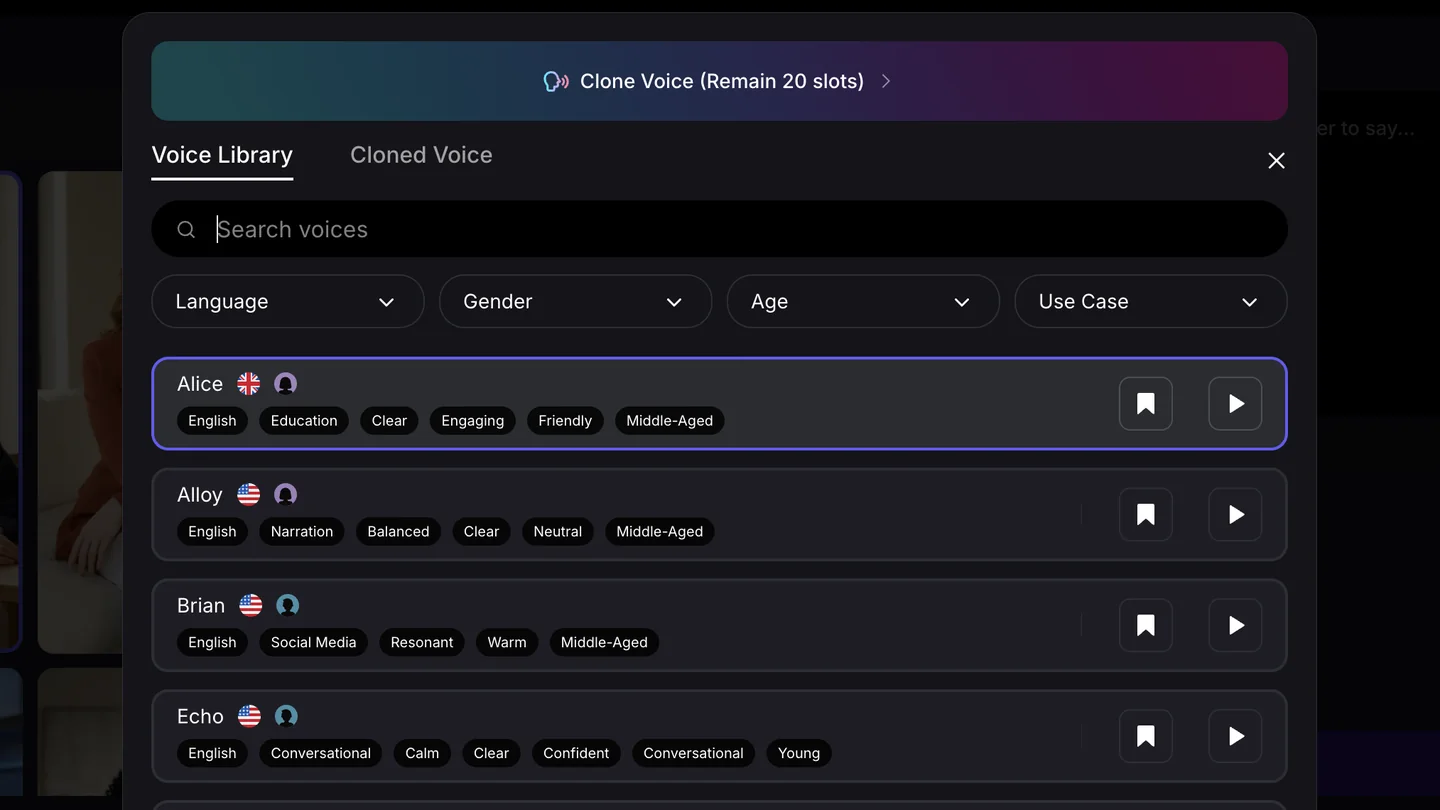
Achten Sie beim Hören darauf, was Ihr Video tatsächlich braucht: regionalen Akzent, Verständlichkeit, Energie, Wärme, Autorität und wie schnell sich die Stimme durch einen Satz bewegt. Eine Stimme, die für sich allein großartig klingt, kann für ein Skript aus den Bereichen Anleitung, Vertrieb, Nachrichten oder Charaktererzählung trotzdem falsch sein.
Schritt 3: Stimme auf Inhalt und Publikum abstimmen
Die meisten enttäuschenden KI-Voiceovers sind kein Qualitätsproblem, sondern ein Problem der Passung. Legen Sie fest, was die Stimme für genau dieses Video leisten soll, bevor Sie sich festlegen.
| Wenn Sie Folgendes erstellen | Achten Sie auf | Vermeiden Sie |
|---|---|---|
| Tutorials, Erklärvideos, Kurse | Klare Artikulation, gleichmäßiges Tempo, neutrale Wärme | Energiegeladene Werbeansagen, die über Fachbegriffe hinweghetzen |
| Anzeigen, Promos, kurze Social-Clips | Energie, Punch, ein selbstbewusstes und jüngeres Profil | Langsame, bedächtige Erzählstimmen, die den Hook verpuffen lassen |
| Nachrichten, Corporate, Produkt-Updates | Autorität, gleichmäßiges Tempo, wenig Stimmfärbung | Lockere oder stark charakterisierte Stimmen |
| Storytelling, Interviews, Podcasts | Persönlichkeit und Ausdrucksbreite | Flache Ansagerstimmen ohne jede Dynamik |
| Lokalisierte Versionen ein und desselben Videos | Einen muttersprachlichen regionalen Akzent für jeden Markt | Eine englische Stimme, die übersetzte Texte vorliest |
| Ein Video, mehrere Sprachversionen, derselbe Presenter | Eine mehrsprachige Stimme, damit jede Version dieselbe Stimmidentität behält | Eine andere Stimme pro Sprache, die jedes Mal wie eine andere Person klingt |
Der Akzent ist die Einstellung, bei der die meisten danebenliegen. Wenn Ihr Publikum in London sitzt und Ihr Moderator eine US-Flagge trägt, fällt das den Zuhörern auf — selbst wenn jedes Wort korrekt ist. Wählen Sie die Flagge passend zum Publikum, nicht nur zur Sprache.
Die letzten beiden Zeilen ziehen in entgegengesetzte Richtungen, und beide haben recht — Sie entscheiden zwischen lokaler Glaubwürdigkeit und einem konsistenten Presenter. Wählen Sie pro Markt einen muttersprachlichen Akzent, wenn sich jede Version lokal anfühlen soll; wählen Sie eine mehrsprachige Stimme, wenn die Videos erkennbar dieselbe Person sind, die zu unterschiedlichen Zielgruppen spricht.
Bei Chinesisch ist der Akzent am wichtigsten, weil „Chinesisch“ drei unterschiedliche Zielgruppen meint. Mandarin fürs Festland. Taiwanese Mandarin für Taiwan — die Schriftsprache ist dieselbe, aber Intonation und Wortwahl verraten eine Festland-Vertonung sofort. Und Cantonese für Hongkong und Guangdong; das ist eine eigene gesprochene Sprache und kein Akzent, daher reicht eine Mandarin-Stimme nicht aus. Stellen Sie den Sprachfilter auf das ein, was Ihre Zuschauer tatsächlich sprechen, und hören Sie dann in die Vorschau rein: Ein Zuschauer in Taipeh nimmt eine Festland-Mandarin-Stimme genauso wahr wie ein Zuhörer in London eine US-Stimme.
Auswahl nach Voice-Engine
Der Filter Anbieter aus Schritt 2 gruppiert die Bibliothek nach der Engine, die die jeweilige Stimme erzeugt. Sie werden ihn selten brauchen, aber wenn eine dieser Situationen auf Sie zutrifft, spart er viel Scrollen.
- ElevenLabs — die größte Bibliothek und die größte emotionale Bandbreite. Starten Sie hier für englische Narration, Charakter-Stimmen und jedes Skript, das spielen soll statt nur anzusagen.
- Gemini — die mehrsprachigen Stimmen. Eine Stimme behält ihre Identität über mehrere Sprachen hinweg; hier sollten Sie suchen, wenn dasselbe Video in mehreren Sprachen erscheint und Sie in allen Versionen denselben Presenter wollen. Diese Stimmen tauchen unabhängig davon auf, welche Sprache Sie filtern.
- MiniMax — das natürlichste Cantonese. Nutzen Sie es für Zielgruppen in Hongkong und Guangdong.
- Seed — Chinesisch auf Muttersprachniveau, inklusive Taiwanese Mandarin, plus muttersprachliche Stimmen für Japanisch, Koreanisch, Spanisch, Portugiesisch und Indonesisch. Probieren Sie es aus, wenn „flüssig, aber fremd“ für den Markt nicht reicht.
Wenn nichts davon zu Ihrem Video passt, lassen Sie Anbieter auf All und entscheiden Sie per Vorschau. Die Passung ist viel wichtiger als die Engine, die die Stimme erzeugt hat.
Schritt 4: Sprechgeschwindigkeit einstellen, dann Pausen setzen
Klicken Sie auf eine Stimmzeile, um sie auf das aktuelle Setup anzuwenden. Öffnen Sie dann das Geschwindigkeitsmenü neben der ausgewählten Stimme und wählen Sie Langsam, Normal oder Schnell.
- Langsam passt zu ruhigen Erklärungen und allen Inhalten, bei denen Verständlichkeit wichtiger ist als Tempo.
- Normal ist die sichere Grundeinstellung für die meisten Tutorials, Präsentationen und Sprechavatar-Videos.
- Schnell bringt Energie in kurze Promos und Social-Clips, macht dichte Skripte aber schwerer verständlich.
Die Geschwindigkeit bestimmt das Tempo des gesamten Vortrags. Für die Feinsteuerung innerhalb eines Satzes setzen Sie den Cursor an die passende Stelle und klicken auf die Schaltfläche Pause. Jeder Klick fügt 0,5 Sekunden hinzu; klicken Sie erneut für eine längere Pause.
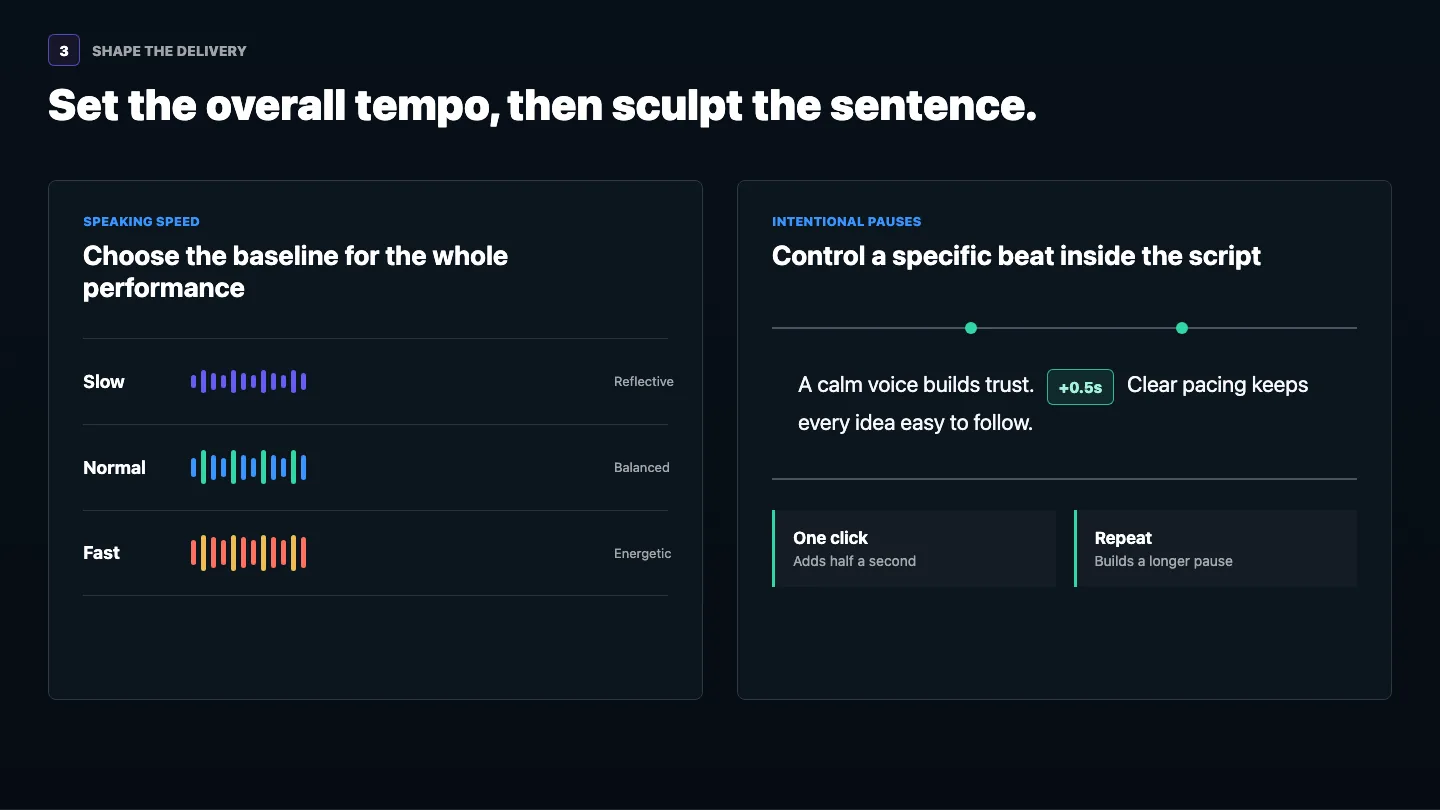
Know-how: Setzen Sie Pausen dort, wo ein echter Moderator atmen, den Gedanken wechseln oder eine Aussage wirken lassen würde. Zu viele Pausen zerstückeln den Vortrag — hören Sie sich nach dem Bearbeiten deshalb den ganzen Satz in der Vorschau an, nicht nur die geänderte Stelle.
Schritt 5: Den Vortrag mit „Stimme optimieren“ steuern
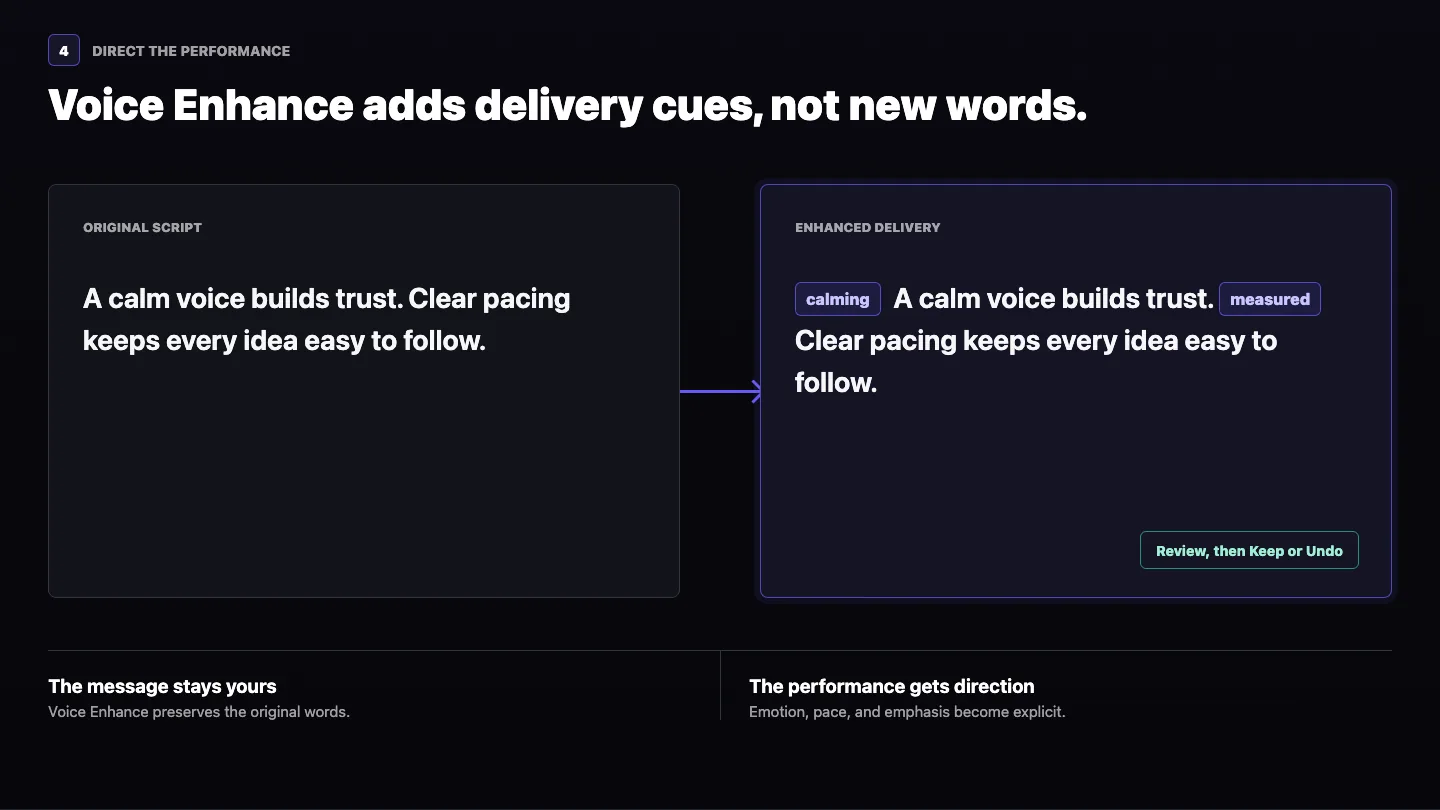
Klicken Sie auf Stimme optimieren, wenn der Text stimmt, der gewünschte Vortrag aber noch nicht klar vorgegeben ist. VisionStory ergänzt Hinweise zu Emotion, Tempo und Betonung, ohne Ihren Wortlaut zu verändern.
Prüfen Sie das optimierte Skript, bevor Sie fortfahren. Wählen Sie Behalten, wenn die Hinweise Ihrer Absicht entsprechen, oder Rückgängig, um zum Original zurückzukehren. Die Funktion lohnt sich, wenn ein Skript klare emotionale Führung braucht, aber nicht umformuliert werden soll.
Schritt 6: Das echte Skript vor dem Generieren vorhören
Klicken Sie auf Audio-Vorschau, sobald Stimme, Geschwindigkeit, Pausen und eventuelle Optimierungshinweise stehen. Hören Sie sich die komplette Aufnahme an, statt schon nach den ersten Wörtern zu urteilen, und prüfen Sie Aussprache, Akzent, Rhythmus, Satzenden, Pausen und die emotionale Passung.
Solange Sie noch mehrere Kandidaten vergleichen, starten Sie mit einem kurzen, repräsentativen Satz. Sobald die engere Auswahl auf zwei oder drei Stimmen geschrumpft ist, hören Sie sich eine Passage an, die die Namen, Zahlen, Fachbegriffe oder emotionalen Höhepunkte enthält, auf die es im fertigen Video am meisten ankommt — genau dort zeigen sich die Unterschiede zwischen den Stimmen.
Vorschau-Kontingent: Die Audio-Vorschau enthält ein kostenloses Zeichenkontingent, das sich in einem rollierenden 24-Stunden-Zyklus erneuert. Ist dieses Kontingent aufgebraucht, kostet die Vorschau-Generierung 1 Credit pro 500 Zeichen. Alle Details finden Sie unter So funktionieren VisionStory Credits.
Schritt 7: Einmal generieren, damit der Avatar sich die Stimme merkt
Die Auswahl einer Stimme ändert die aktuelle Einrichtung im Editor, aber die Auswahl allein speichert diese Stimme nicht am Avatar. Generieren Sie ein Video mit der gewählten Stimme. VisionStory merkt sich dann diese Kombination und stellt sie wieder her, wenn Sie denselben Avatar das nächste Mal verwenden.
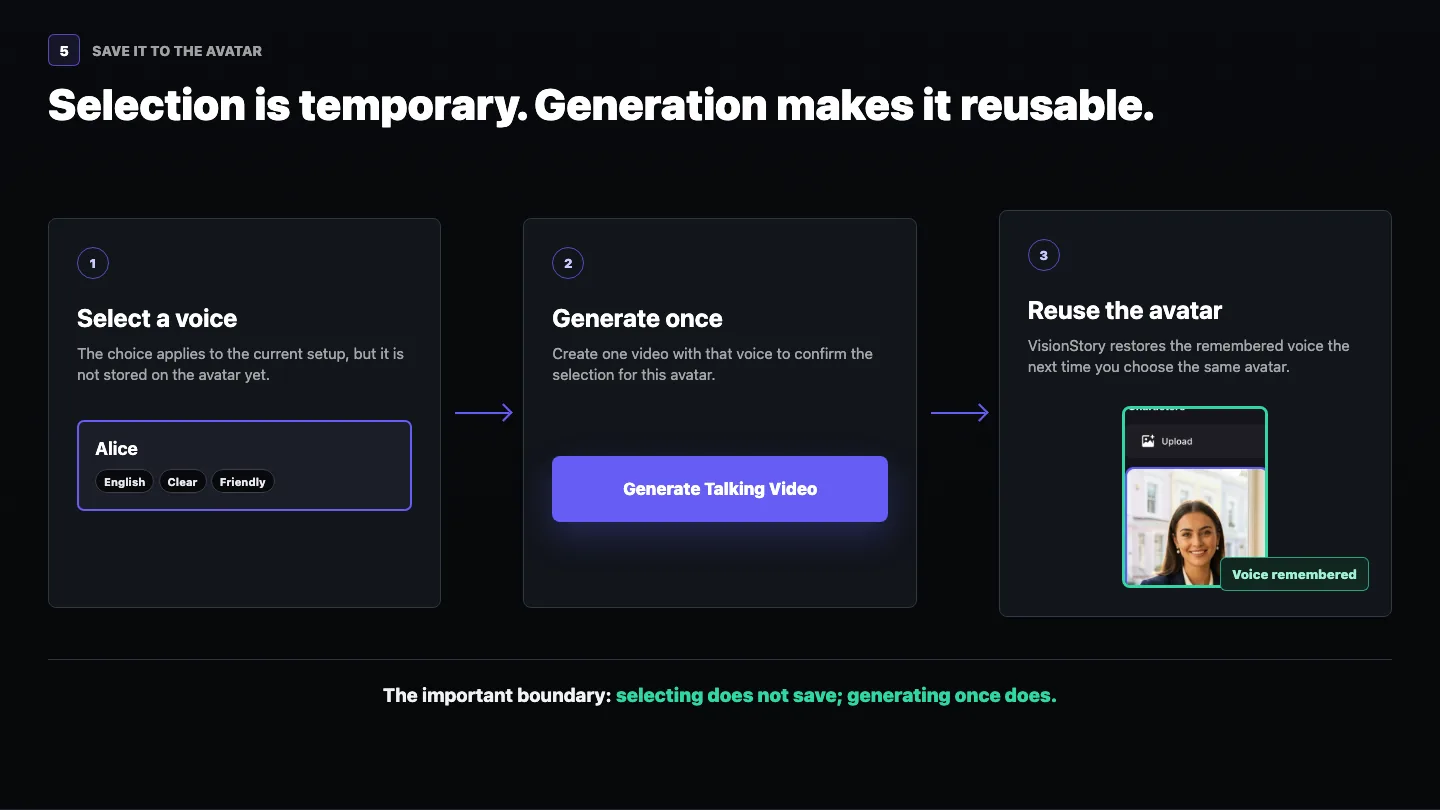
Deshalb lohnt es sich, die Wahl sorgfältig zu treffen. Sobald Avatar und Stimme verknüpft sind, beginnt jedes weitere Video mit einem einheitlichen Sprecher statt mit einer neuen Entscheidung.
Warum KI-Stimmen roboterhaft klingen — und wie Sie das beheben
Wenn ein generiertes Voiceover synthetisch wirkt, liegt das meist an einer von fünf behebbaren Ursachen und nicht am Stimmmodell selbst.
- Falsche Stimme für das Skript. Eine Erzählerstimme, die Werbetext liest, klingt flach. Grenzen Sie die Auswahl erneut nach Anwendungsfall ein, bevor Sie die Qualität verantwortlich machen.
- Keine Pausen. Echte Sprecher atmen. Eine Textwand ohne Taktung wirkt maschinell, fügen Sie also an den Sinngrenzen Pausen von einer halben Sekunde ein.
- Geschwindigkeit einmal eingestellt und vergessen. Schnell lässt dichte Sätze verwaschen klingen, Langsam zieht einen kurzen Werbeclip in die Länge. Passen Sie das Tempo an die Art des Inhalts an.
- Unklare Zeichensetzung. Endlose Schachtelsätze, fehlende Kommas und nicht ausgeschriebene Abkürzungen treiben jede Stimme in Richtung Monotonie. Bereinigen Sie zuerst das Skript.
- Keine emotionale Regieanweisung. Wenn die Absicht nicht im Text steht, kann die Stimme sie nicht erraten — genau dafür gibt es die Funktion „Stimme optimieren“.
Beheben Sie diese fünf Punkte, und die meisten Klagen über roboterhafte KI-Stimmen verschwinden, ohne dass Sie die Stimme überhaupt wechseln müssen.
Wenn ein Anbieter eine von Ihnen genutzte Stimme einstellt
VisionStory bezieht Stimmen von mehreren Anbietern, und ein Anbieter kann eine Stimme aus seinem eigenen Katalog entfernen. Passiert das, lässt sich die Stimme nicht in die öffentliche Stimmenbibliothek zurückholen.
Wenn eine Stimme, auf die Sie sich verlassen haben, nicht mehr verfügbar ist, suchen Sie in einem älteren Video eine saubere Passage, in der nur diese Stimme zu hören ist, und verwenden Sie sie als Quellaudio in Stimme klonen. Der Klon kann einen sehr ähnlichen Ersatz liefern, auch wenn er nicht identisch klingen wird.
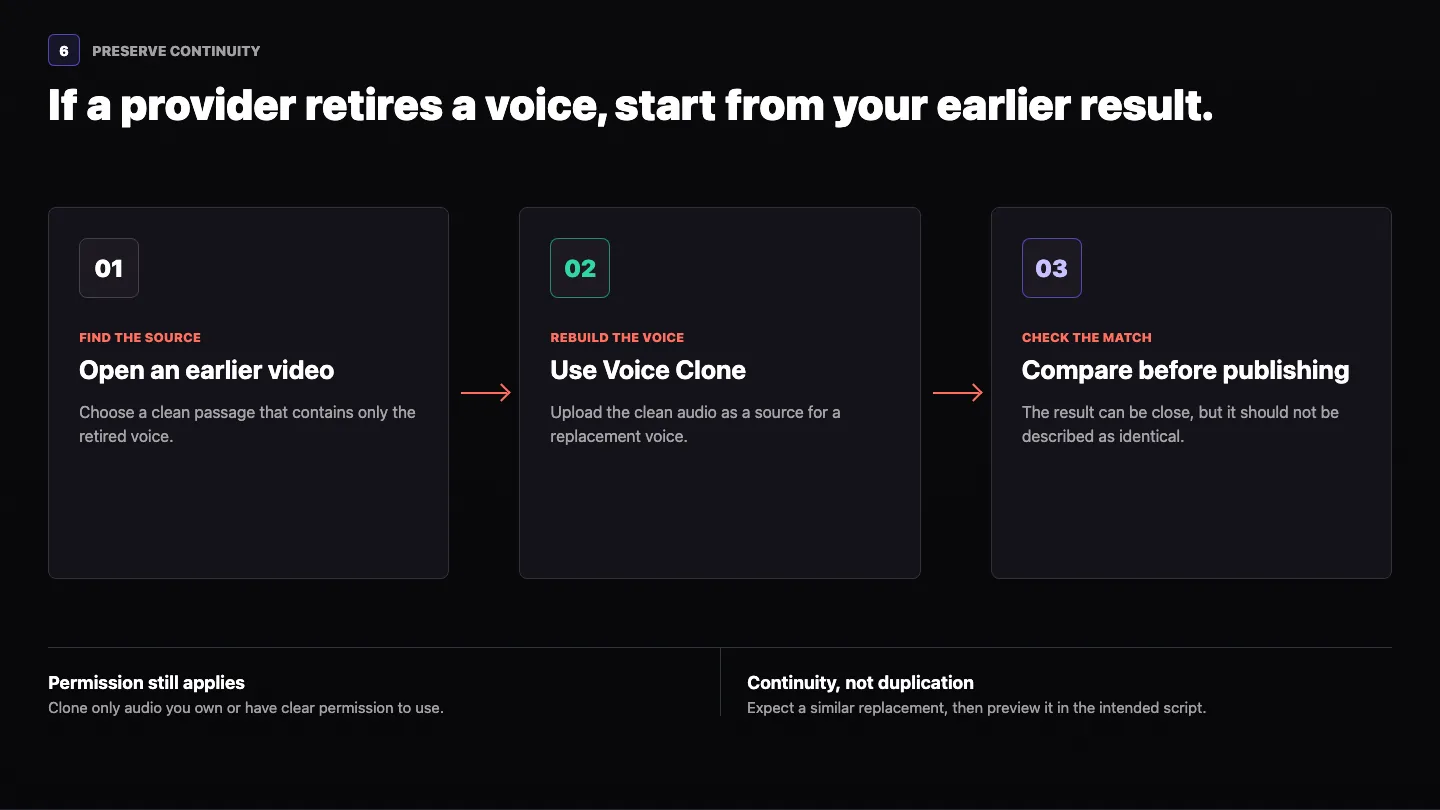
Berechtigung erforderlich: Klonen Sie nur Audio, das Ihnen gehört oder für das Sie eine eindeutige Erlaubnis haben, und hören Sie sich den Ersatz mit Ihrem geplanten Skript an, bevor Sie veröffentlichen.
Ihre Checkliste für die KI-Stimme vor dem Generieren
- Wählen Sie den regionalen Akzent passend zum Publikum, nicht nur die Sprache.
- Nutzen Sie die Profil-Tags für die Vorauswahl und entscheiden Sie dann nach Gehör.
- Hören Sie die Namen, Zahlen und schwierigen Begriffe aus Ihrem echten Skript vorab an.
- Legen Sie die Gesamtgeschwindigkeit fest, bevor Sie einzelne Pausen einfügen.
- Setzen Sie „Stimme optimieren“ nur ein, wenn der Vortrag klarere Vorgaben braucht.
- Hören Sie sich eine vollständige Vorschau an, nicht nur den ersten Satz.
- Generieren Sie einmal, wenn der Avatar sich die Stimme merken soll.
- Notieren Sie den Namen der gewählten Stimme in Ihren Marken- oder Kampagnenunterlagen.
Sobald die Stimme feststeht, geht der Rest schnell. Führen Sie dasselbe Setup mit So erstellen Sie einen KI-Sprechavatar bis zum fertigen Video, oder öffnen Sie Text zu Sprache, wenn Sie nur die Audiospur brauchen.
