Tiếng Việt

Trình Tạo Video Đồng Bộ Khẩu Hình AI

Chọn một gương mặt, thêm âm thanh và nhận video mà môi khớp từng lời. Nhập kịch bản, tải lên âm thanh của bạn hoặc thu trực tiếp trên trình duyệt — VisionStory sẽ đồng bộ miệng, biểu cảm và chuyển động đầu theo những gì bạn nghe.

Bắt đầu đồng bộ khẩu hình
3cách thêm âm thanh
88ngôn ngữ kịch bản
1,000+Giọng nói AI
2Kxuất tối đa

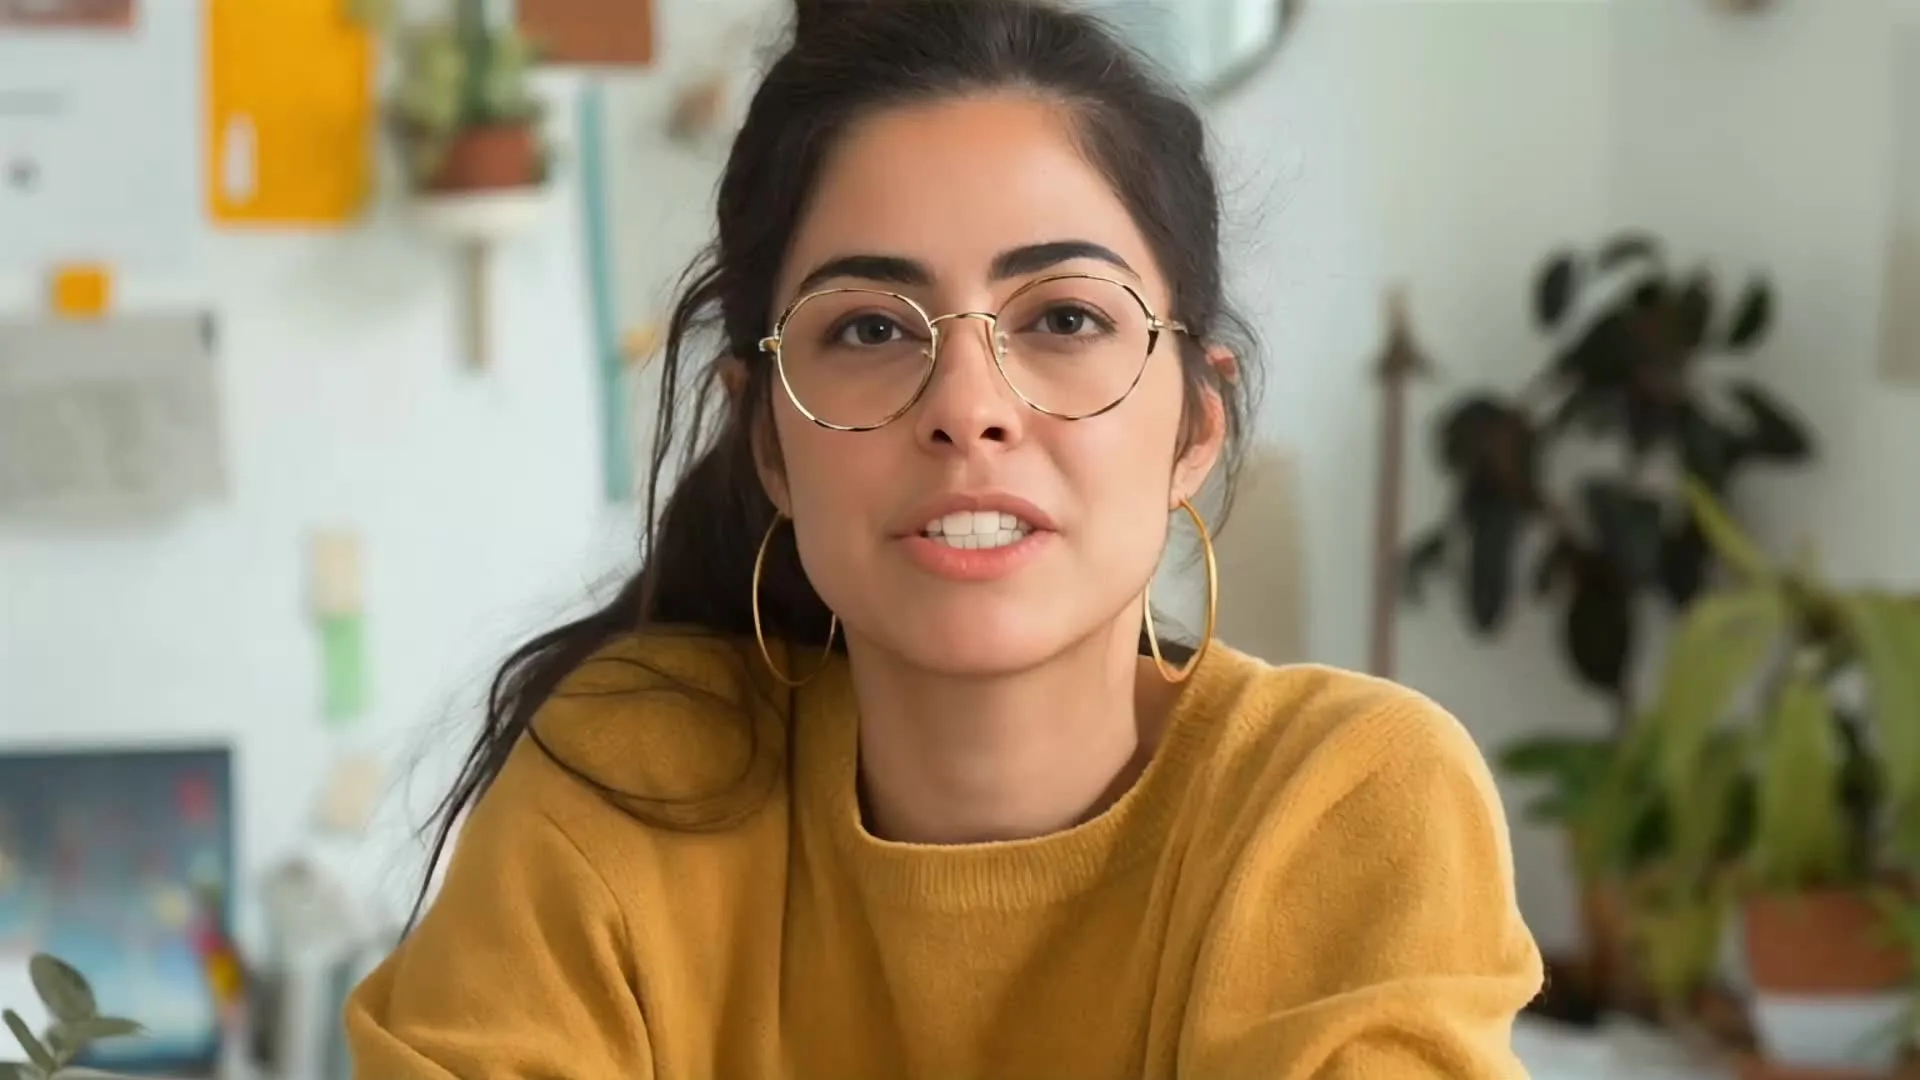
Nghe thử: cùng một tấm ảnh, đang nói

Bật âm thanh lên. Cùng bức chân dung ở trên sẽ nói phần mở đầu khóa học dài 15 giây — khẩu hình, khoảng ngắt và biểu cảm đều bám theo giọng nói.

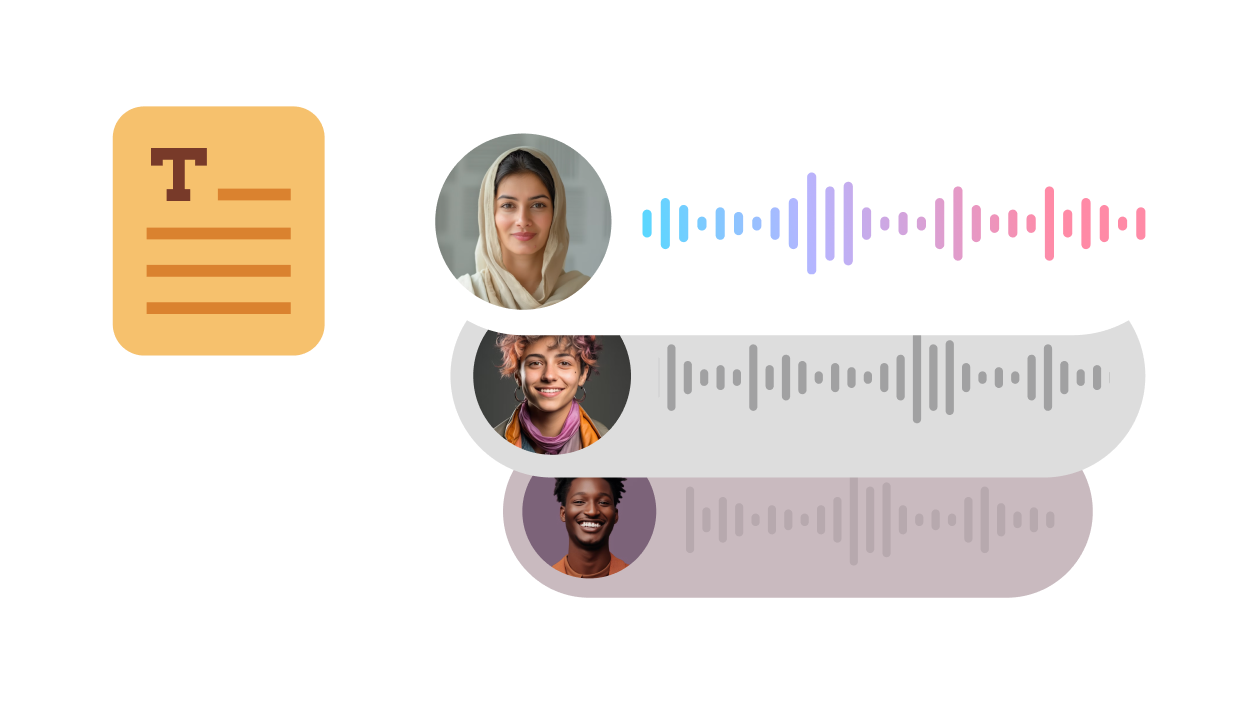
Nhập âm thanh

3 cách để điều khiển đồng bộ khẩu hình

Bắt đầu từ âm thanh bạn đã có — hoặc chỉ cần vài dòng chữ.

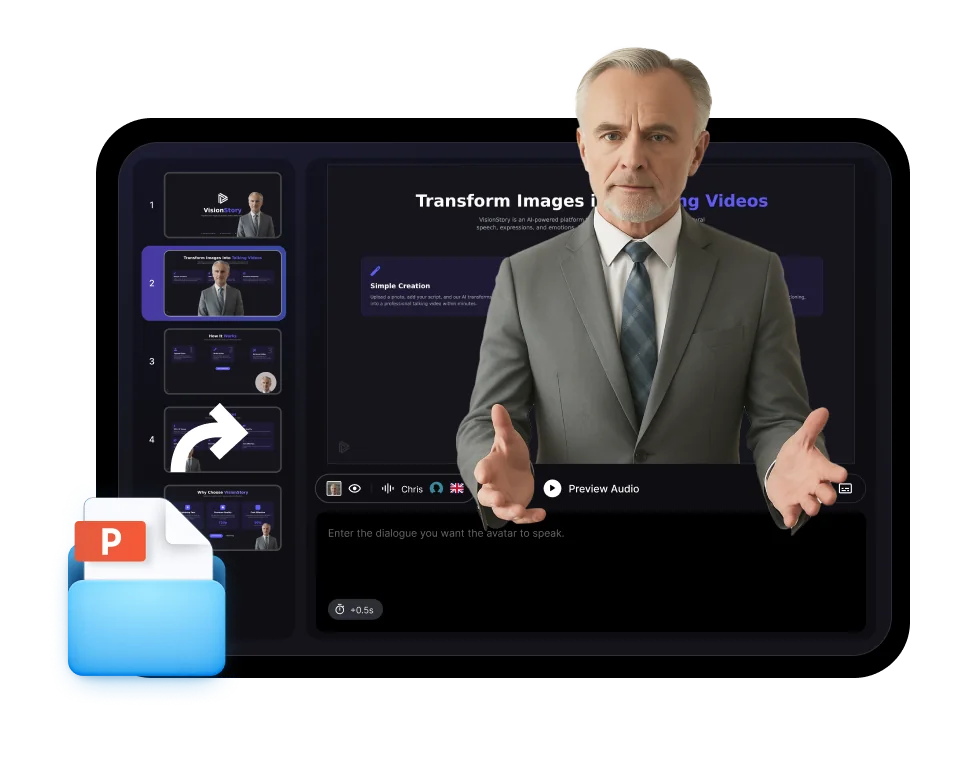
Kịch bản

Nhập lời thoại

Viết những gì nhân vật cần nói, chọn một trong 1,000+ Giọng nói AI ở 88 ngôn ngữ, và miệng sẽ bám theo lời thoại được tạo ra.

Nhập

Tải lên âm thanh của bạn

Đưa vào voiceover, đoạn podcast, câu trả lời phỏng vấn hoặc bài hát và đồng bộ gương mặt theo đúng bản ghi đó.

Ghi Âm

Tự nói

Thu giọng của bạn ngay trên trình duyệt và biến nó thành video đồng bộ khẩu hình mà không cần rời khỏi trang.

Một gương mặt, ba màn thể hiện

Cùng một tấm ảnh được đồng bộ khẩu hình theo 3 track âm thanh khác nhau. Cách thể hiện sẽ thay đổi cả đoạn clip — nhịp nói, biểu cảm và năng lượng bám theo nội dung nhân vật đang nói.

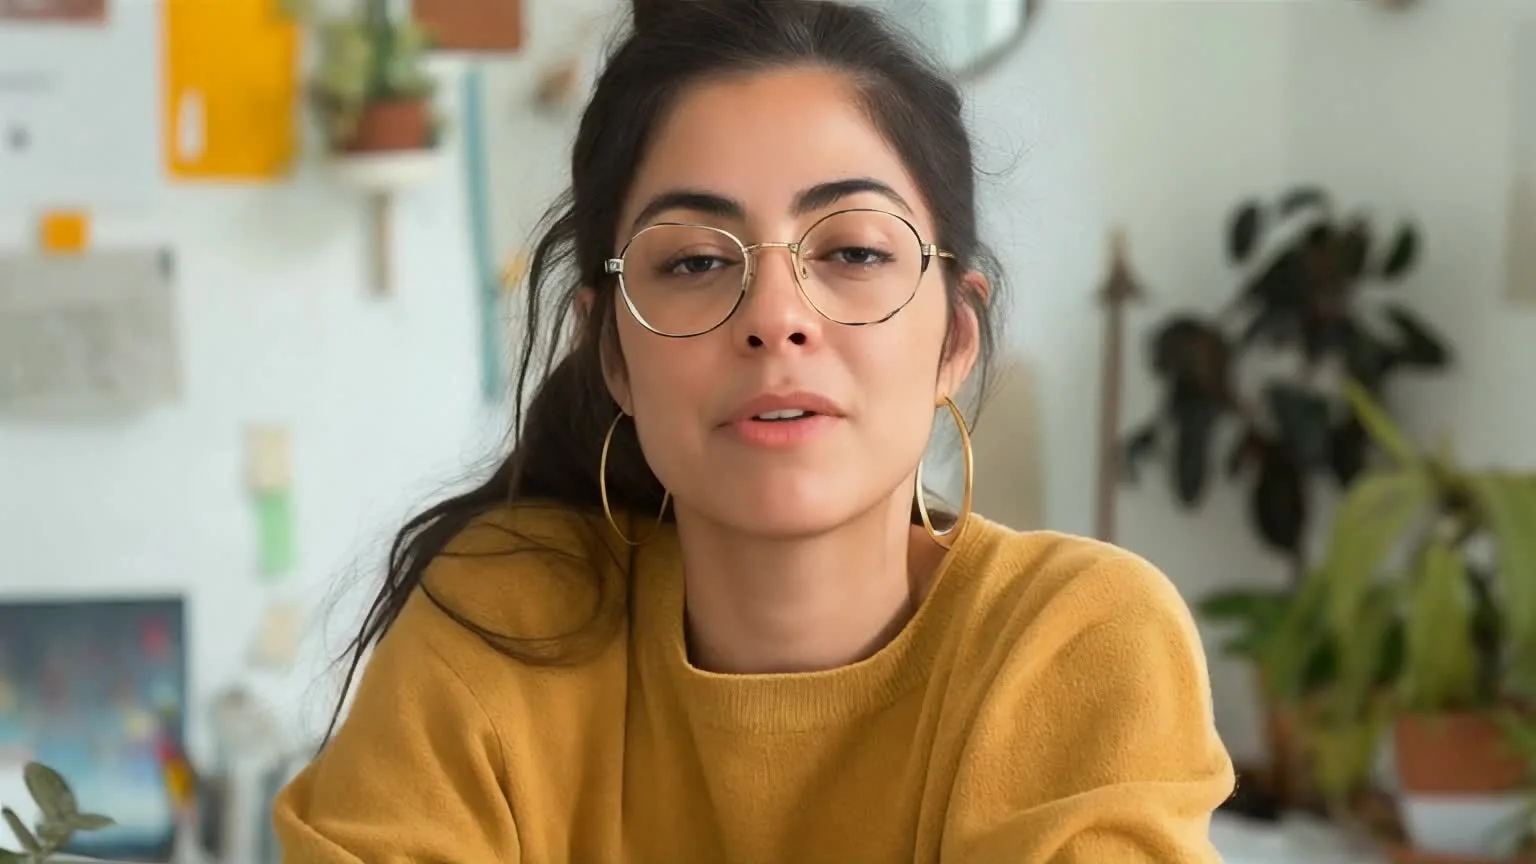
Đồng bộ khẩu hình AI cho ảnh chân dung với giọng thuyết minh điềm tĩnh

Thuyết minh điềm tĩnh

Nhịp nói đều và ánh mắt ổn định cho video giải thích, cập nhật và bài học.

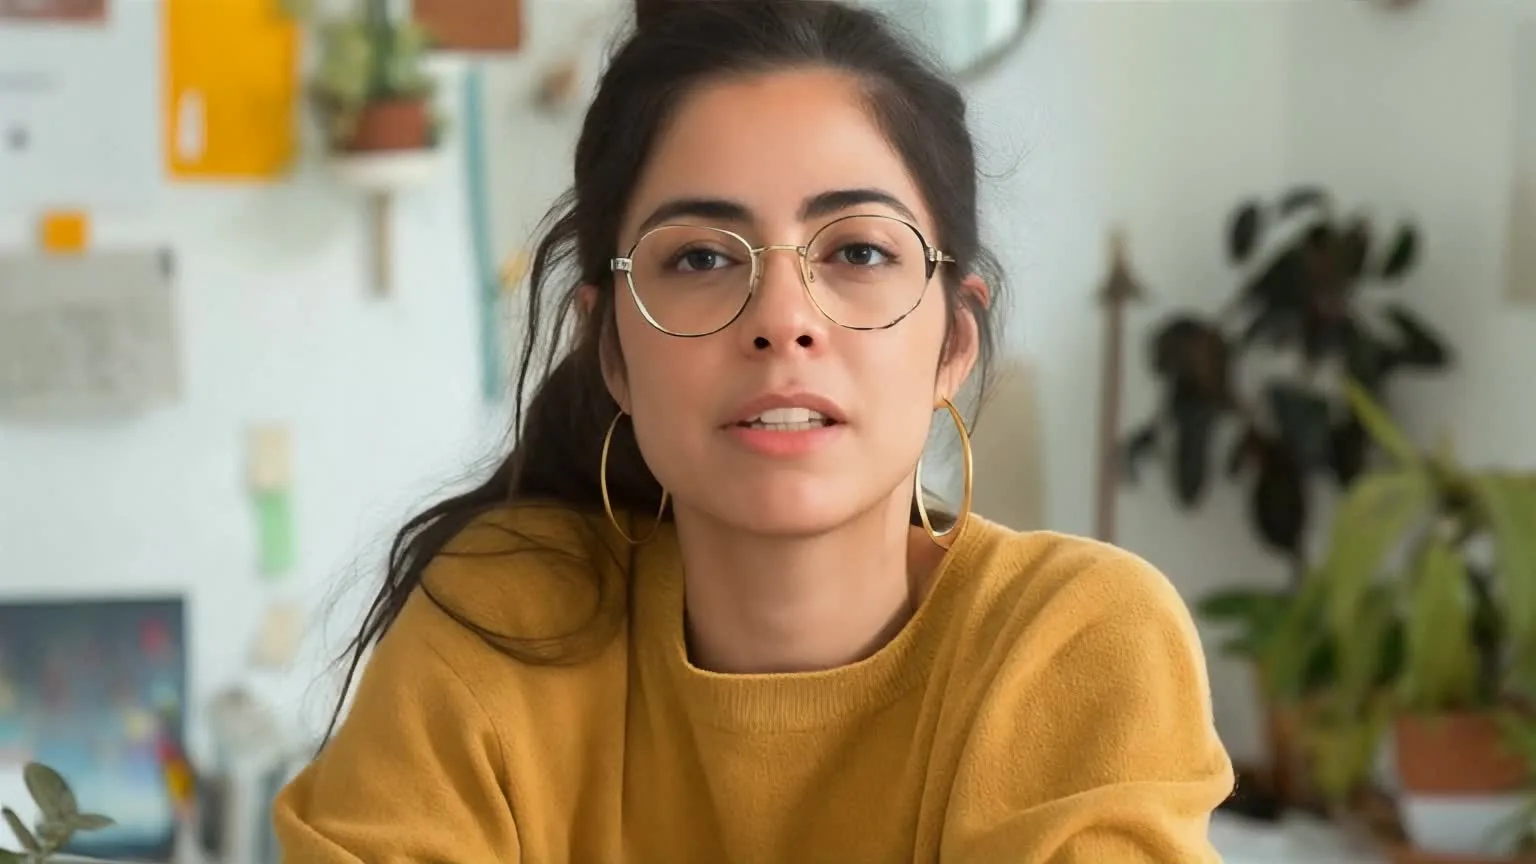
Đồng bộ khẩu hình AI cho cùng ảnh chân dung với cách thể hiện đầy hứng khởi

Cách thể hiện đầy hứng khởi

Biểu cảm tươi sáng hơn cho lời chào, nội dung promo và hook trên mạng xã hội.

Đồng bộ khẩu hình AI cho cùng ảnh chân dung với cách thể hiện gay gắt

Cách thể hiện gay gắt

Biểu cảm sắc nét hơn cho video tiểu phẩm, reaction và cảnh nhân vật.

Cách hoạt động

Đồng bộ khẩu hình video chỉ với 3 bước

Không cần quay, không cần keyframe hay chỉnh sửa timeline — chỉ cần một gương mặt và một âm thanh.

01

Chọn gương mặt

Tải lên ảnh chính diện rõ nét, chọn avatar có sẵn, hoặc tạo nhân vật mới từ prompt văn bản.

02

Thêm âm thanh

Nhập kịch bản và chọn Giọng nói, tải lên tệp âm thanh, hoặc tự thu giọng của bạn.

03

Tạo và tải xuống

Chọn 720P, 1080P hoặc 2K, tạo video và tải xuống kết quả đã đồng bộ khẩu hình.

Vì sao chọn VisionStory

Đồng bộ khẩu hình trông như một màn thể hiện

Khẩu hình chính xác chỉ là điểm khởi đầu. Biểu cảm, chớp mắt và chuyển động đầu khiến kết quả trông như đang nói thật, chứ không phải hoạt hình.

01

Khẩu hình khớp với âm thanh

Miệng bám theo từng âm tiết của âm thanh, nên môi khớp đúng lời nói thay vì chỉ mở/đóng theo độ lớn âm lượng.

02

Gương mặt không chỉ là người thật

Đồng bộ khẩu hình cho ảnh chân dung, nhân vật minh họa, mascot thương hiệu, động vật và hình tượng do AI tạo — miễn là có gương mặt rõ nét.

03

Bản ghi của bạn, giữ nguyên như cũ

Khi bạn nhập tệp âm thanh hoặc thu âm, VisionStory sẽ giữ nguyên giọng của bạn và đồng bộ gương mặt theo đúng nhịp thời gian đó. Muốn đổi giọng? Tính năng Thay đổi giọng nói sẽ chuyển đổi bản ghi nhưng vẫn giữ nguyên màn thể hiện.

04

Làm sạch âm thanh nguồn

Bật Khử tạp âm cho các bản ghi đã nhập có tiếng ù trong phòng hoặc tiếng ồn nền, để cả giọng nói lẫn khẩu hình đều rõ ràng.

05

88 ngôn ngữ, 1,000+ Giọng nói

Chưa có bản ghi? Nhập kịch bản bằng bất kỳ ngôn ngữ nào trong 88 ngôn ngữ và chọn từ hơn 1,000 Giọng nói AI.

06

Biểu cảm và chuyển động đầu

Chớp mắt, biểu cảm khuôn mặt và chuyển động đầu tự nhiên đi kèm theo đồng bộ, giúp một tấm ảnh tĩnh trở thành người nói thuyết phục.

07

Xuất tối đa 2K

Dựng ở 720P, 1080P hoặc 2K cho bài đăng mạng xã hội, bài thuyết trình, video sản phẩm và quảng cáo.

08

Dọc, vuông hoặc màn hình rộng

Đóng khung video theo 9:16, 1:1 hoặc 16:9 để vừa với Shorts, Reels, TikTok, feed hoặc YouTube mà không cần cắt lại.

Câu hỏi thường gặp về AI Lip Sync

  • AI lip sync đồng bộ chuyển động miệng của nhân vật theo một track âm thanh. Trong VisionStory, bạn cung cấp một khuôn mặt — ảnh, minh họa hoặc avatar có sẵn — và âm thanh từ kịch bản, tệp tải lên hoặc bản ghi. Sau đó VisionStory tạo ra một video trong đó môi, biểu cảm và chuyển động đầu bám theo âm thanh.