
Mọi video AI đều bắt đầu bằng một kịch bản, nhưng chính giọng nói mới quyết định kịch bản đó chạm đến người xem như thế nào. Giọng nói định hình giọng địa phương, độ tuổi, chất âm, năng lượng và cá tính của người dẫn — còn tốc độ, khoảng nghỉ cùng các chỉ dẫn thể hiện sẽ quyết định thành phẩm nghe giống một con người hay giống một cỗ máy đang đọc trang giấy.
Nói ngắn gọn: hãy chọn giọng nói AI bằng cách khớp ngôn ngữ và giọng địa phương với khán giả của bạn, dùng các thẻ hồ sơ để lập danh sách rút gọn, nghe thử từng ứng viên bằng chính kịch bản của bạn, rồi tinh chỉnh cách thể hiện bằng tốc độ và khoảng nghỉ trước khi tạo video. Phần còn lại của hướng dẫn này sẽ đi qua quy trình đó từng bước trong VisionStory, nơi thư viện giọng nói AI có hơn 1.000 giọng nói thuộc 88 ngôn ngữ.
Hướng dẫn này bao gồm: Voice Library công khai và các tùy chỉnh cách thể hiện xoay quanh nó. Tạo giọng nói từ bản ghi âm của chính bạn là một quy trình riêng — xem cách nhân bản giọng nói của bạn bằng AI.
Bước 1: Mở Voice Library và đọc dòng thông tin giọng nói
Mở Video AI, chọn avatar bạn muốn dùng và nhấp vào giọng nói hiện tại bên dưới ô Script. Voice Library sẽ mở ra phía trên trình chỉnh sửa.
Mỗi dòng đều mang bốn tín hiệu giúp bạn đoán trước giọng đọc sẽ nghe ra sao trước khi nhấn phát:
- Thẻ ngôn ngữ — ngôn ngữ mà giọng nói đó sử dụng.
- Lá cờ — giọng địa phương, không phải ngôn ngữ thứ hai. Các giọng tiếng Anh có thể mang cờ Mỹ, Anh, Canada và nhiều nước khác.
- Giới tính và độ tuổi — danh tính cảm nhận được của người nói.
- Đặc điểm và mục đích sử dụng — các mô tả như rõ ràng, ấm áp, trò chuyện, thuyết minh, giáo dục hay mạng xã hội.
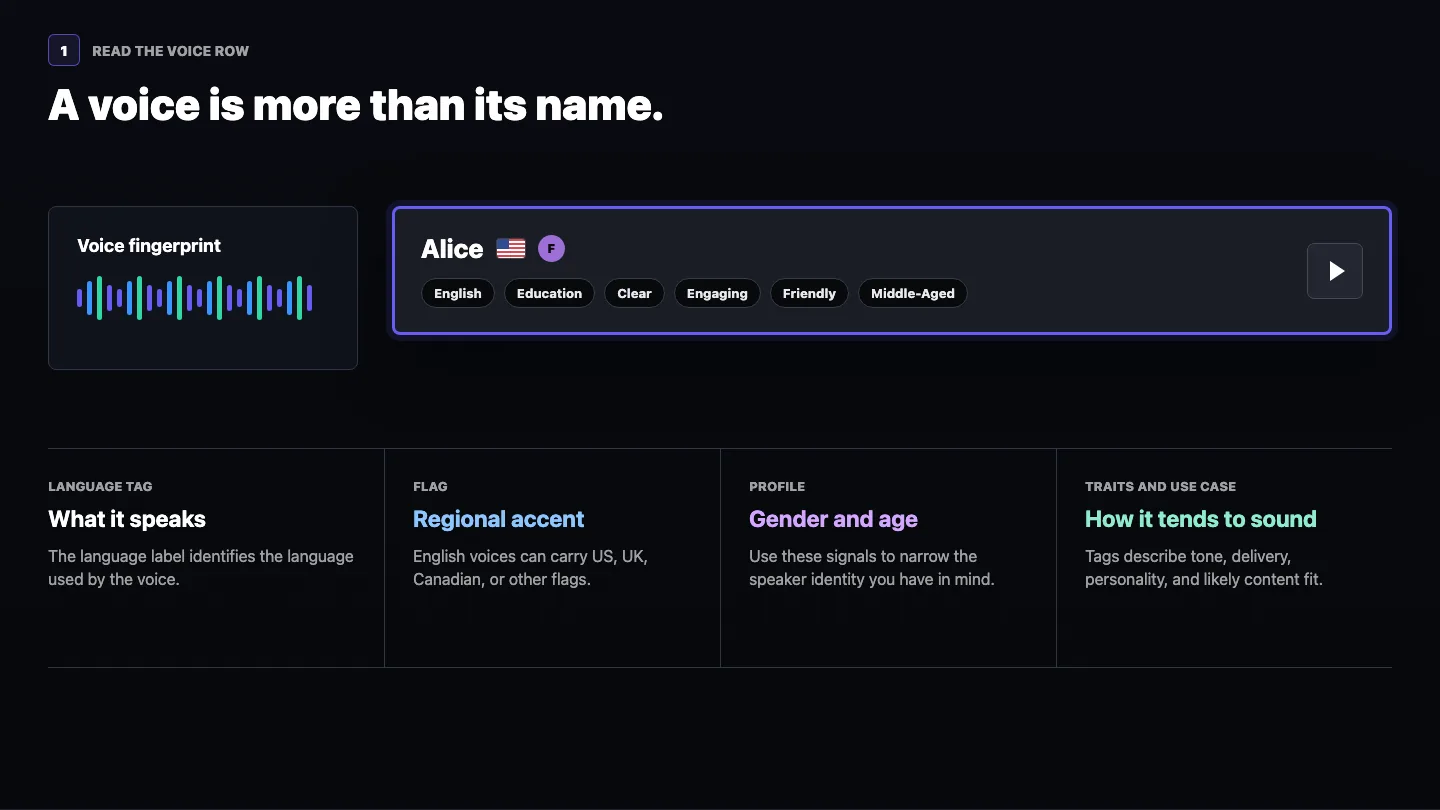
Hãy dùng các nhãn để lập danh sách rút gọn, chứ đừng dùng chúng để ra quyết định cuối cùng. Hai giọng nói có nhãn gần như giống hệt nhau vẫn có thể khác biệt rất nhiều về nhịp điệu, chất âm và năng lượng.
Bước 2: Lọc, tìm kiếm và nghe thử danh sách rút gọn
Hãy bắt đầu đủ rộng để nghe ra những khác biệt thực sự, rồi mới thu hẹp dần. Dùng các bộ lọc Language, Gender, Age, Use Case và Provider khi bạn còn đang khám phá. Nếu đã biết tên giọng nói cần tìm, hãy gõ thẳng vào ô tìm kiếm.
Provider, bộ lọc cuối cùng trên hàng, là công nghệ tạo giọng nói đứng sau mỗi giọng. VisionStory vận hành nhiều công nghệ khác nhau, và mỗi công nghệ lại mạnh ở những điểm khác nhau. Ở lượt lọc đầu tiên, hãy để All — bạn cần giọng tốt nhất cho kịch bản này, bất kể nó được tạo bởi công nghệ nào. Chỉ dùng bộ lọc này khi bạn đã biết rõ mình cần gì, chẳng hạn như giọng đọc Cantonese hoặc một giọng phải "gánh" nhiều ngôn ngữ. Bước 3 sẽ nói rõ nên chọn công nghệ nào cho các trường hợp đó.
- Lập danh sách rút gọn. Lọc hoặc tìm kiếm cho đến khi bạn chỉ còn vài ứng viên thay vì cả một danh mục đầy đủ.
- Nghe hết danh sách rút gọn. Nhấp nút phát ở bên phải mỗi dòng giọng nói để nghe mẫu.
- Tạm dừng và so sánh. Nhấp lại chính nút đó để dừng trước khi chuyển sang giọng tiếp theo.
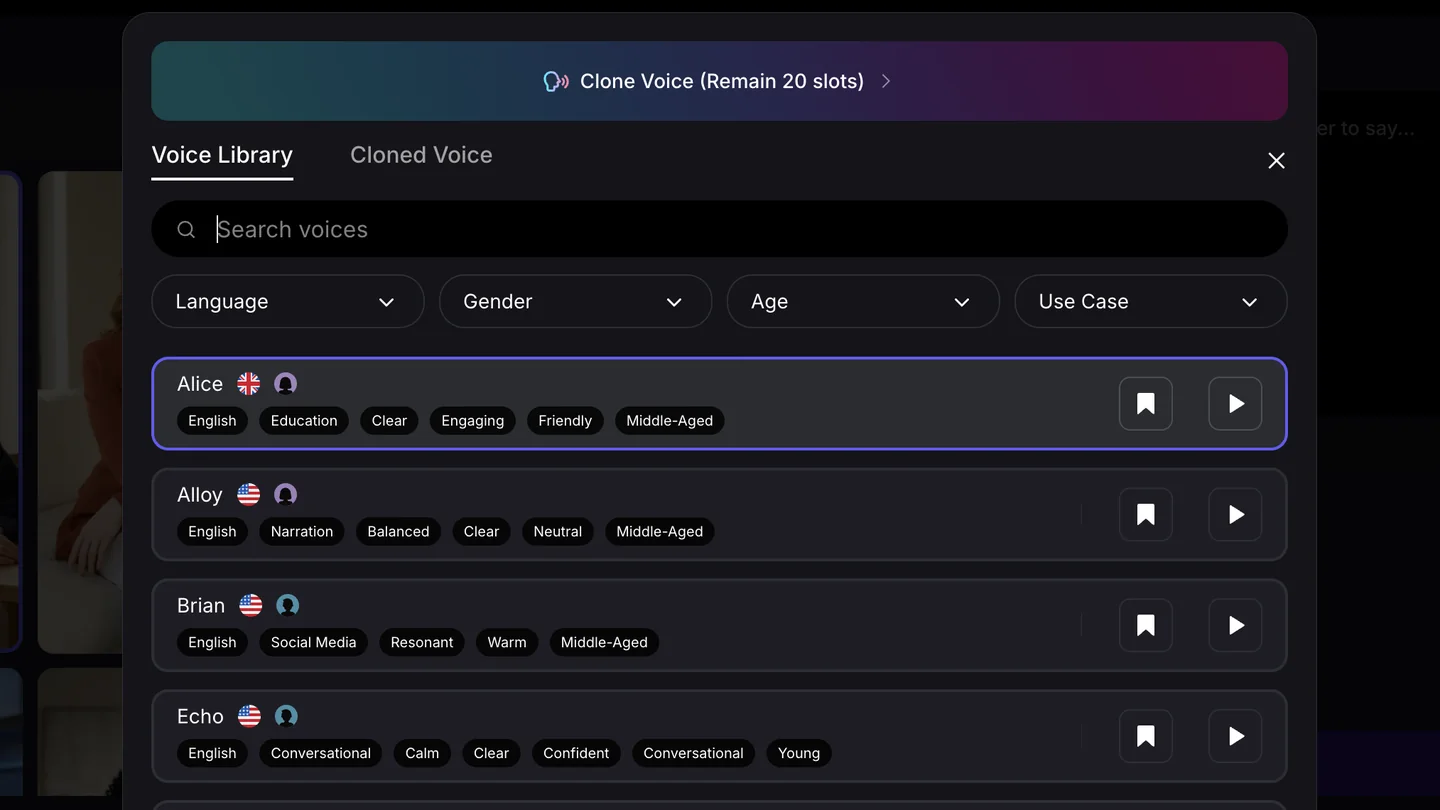
Hãy lắng nghe đúng những gì video của bạn thực sự cần: giọng địa phương, độ rõ ràng, năng lượng, sự ấm áp, tính uy tín và tốc độ giọng nói đi qua một câu. Một giọng nghe rất hay khi đứng riêng vẫn có thể không phù hợp với kịch bản hướng dẫn, bán hàng, tin tức hay kịch bản xây dựng nhân vật.
Bước 3: Chọn giọng nói phù hợp với nội dung và khán giả của bạn
Hầu hết các bản lồng tiếng AI gây thất vọng không phải vì chất lượng, mà vì không phù hợp. Trước khi chốt, hãy xác định rõ giọng nói này cần làm được gì cho đúng video này.
| Nếu bạn đang làm | Nên tìm | Nên tránh |
|---|---|---|
| Video hướng dẫn, video giải thích, khóa học | Phát âm rõ ràng, nhịp nói ổn định, ấm áp trung tính | Giọng quảng cáo nhiều năng lượng, đọc lướt qua các thuật ngữ kỹ thuật |
| Quảng cáo, video khuyến mãi, clip mạng xã hội ngắn | Năng lượng, dứt khoát, chất giọng tự tin và trẻ trung | Lối dẫn chậm rãi, đều đều làm mất điểm nhấn mở đầu |
| Tin tức, nội dung doanh nghiệp, cập nhật sản phẩm | Uy tín, nhịp nói đều, ít màu sắc giọng đặc trưng | Giọng suồng sã hoặc mang nặng tính nhân vật |
| Kể chuyện, phỏng vấn, podcast | Cá tính và biên độ biểu cảm rộng | Giọng phát thanh viên đều đều, không có biến hóa |
| Các phiên bản bản địa hóa của cùng một video | Giọng địa phương bản xứ cho từng thị trường | Một giọng tiếng Anh đọc nội dung đã dịch |
| Một video, nhiều phiên bản ngôn ngữ, cùng một người dẫn | Một giọng đa ngôn ngữ, để mọi phiên bản đều giữ được cùng một “nhận diện giọng nói” | Mỗi ngôn ngữ một giọng khác nhau, khiến lần nào cũng nghe như một người khác |
Giọng địa phương là thiết lập bị chọn sai nhiều nhất. Nếu khán giả của bạn ở London mà người dẫn lại mang cờ Mỹ, người nghe sẽ nhận ra ngay — kể cả khi từng chữ đều chính xác. Hãy chọn lá cờ theo khán giả, chứ không chỉ theo ngôn ngữ.
Hai dòng cuối cùng kéo về hai hướng trái ngược nhau, và cả hai đều đúng — bạn đang chọn giữa độ tin cậy “chuẩn địa phương” và một người dẫn nhất quán. Hãy chọn giọng bản xứ cho từng thị trường khi mỗi phiên bản cần cảm giác thật địa phương; và chọn một giọng đa ngôn ngữ khi các video rõ ràng là cùng một người đang nói với những nhóm khán giả khác nhau.
Tiếng Trung là nơi giọng địa phương quan trọng nhất, vì “tiếng Trung” là 3 nhóm khán giả khác nhau. Mandarin cho đại lục. Taiwanese Mandarin cho Đài Loan — chữ viết thì giống nhau, nhưng ngữ điệu và cách dùng từ sẽ “lộ” ngay một bản đọc kiểu đại lục. Và Cantonese cho Hong Kong và Quảng Đông, đây là một ngôn ngữ nói riêng chứ không phải giọng địa phương, nên dùng giọng Mandarin sẽ không phù hợp. Hãy đặt bộ lọc Language theo đúng thứ tiếng mà người xem của bạn thực sự nói, rồi nghe thử: một người xem ở Taipei sẽ nghe giọng Mandarin đại lục giống như một người ở London nghe giọng Mỹ.
Chọn theo công nghệ giọng nói
Bộ lọc Provider ở Bước 2 sẽ nhóm thư viện theo công nghệ tạo ra từng giọng. Bạn sẽ không cần dùng nó thường xuyên, nhưng khi rơi vào một trong những trường hợp sau, nó sẽ giúp bạn đỡ phải cuộn rất nhiều.
- ElevenLabs — thư viện lớn nhất và dải cảm xúc rộng nhất. Hãy bắt đầu ở đây cho thuyết minh tiếng Anh, giọng nhân vật, và mọi kịch bản cần “diễn” thay vì chỉ đọc thông báo.
- Gemini — các giọng đa ngôn ngữ. Một giọng giữ được “nhận diện” xuyên suốt nhiều ngôn ngữ, nên đây là nơi nên tìm khi cùng một video phát hành nhiều ngôn ngữ và bạn muốn cùng một người dẫn ở tất cả phiên bản. Các giọng này sẽ xuất hiện dù bạn lọc Language nào.
- MiniMax — Cantonese tự nhiên nhất. Hãy dùng cho khán giả Hong Kong và Quảng Đông.
- Seed — tiếng Trung ở mức bản xứ, bao gồm cả Taiwanese Mandarin, cùng với các giọng tiếng Nhật, Hàn, Tây Ban Nha, Bồ Đào Nha và Indonesia ở mức bản xứ. Hãy thử khi bản đọc “trôi chảy nhưng vẫn có cảm giác ngoại quốc” là chưa đủ cho thị trường.
Nếu video của bạn không thuộc những trường hợp đó, hãy để Provider ở All và để phần nghe thử quyết định. Độ phù hợp quan trọng hơn rất nhiều so với việc giọng được tạo bởi công nghệ nào.
Bước 4: Đặt tốc độ nói, rồi thêm khoảng nghỉ
Nhấp vào một dòng giọng nói để áp dụng giọng đó cho thiết lập hiện tại. Sau đó mở menu tốc độ bên cạnh giọng nói đã chọn và chọn Slow, Normal hoặc Fast.
- Slow hợp với những phần giải thích cần suy ngẫm và mọi nội dung mà việc hiểu quan trọng hơn cảm giác gấp gáp.
- Normal là mức nền an toàn cho hầu hết video hướng dẫn, bài thuyết trình và video avatar biết nói.
- Fast tạo thêm năng lượng cho quảng cáo ngắn và clip mạng xã hội, nhưng kịch bản dày đặc thông tin sẽ khó theo dõi hơn.
Tốc độ quyết định nhịp của toàn bộ phần thể hiện. Để kiểm soát nhịp ngay trong một câu, hãy đặt con trỏ vào chỗ cần ngắt nhịp rồi nhấp vào nút Pause. Mỗi lần nhấp sẽ thêm 0,5 giây; nhấp thêm lần nữa để có khoảng nghỉ dài hơn.
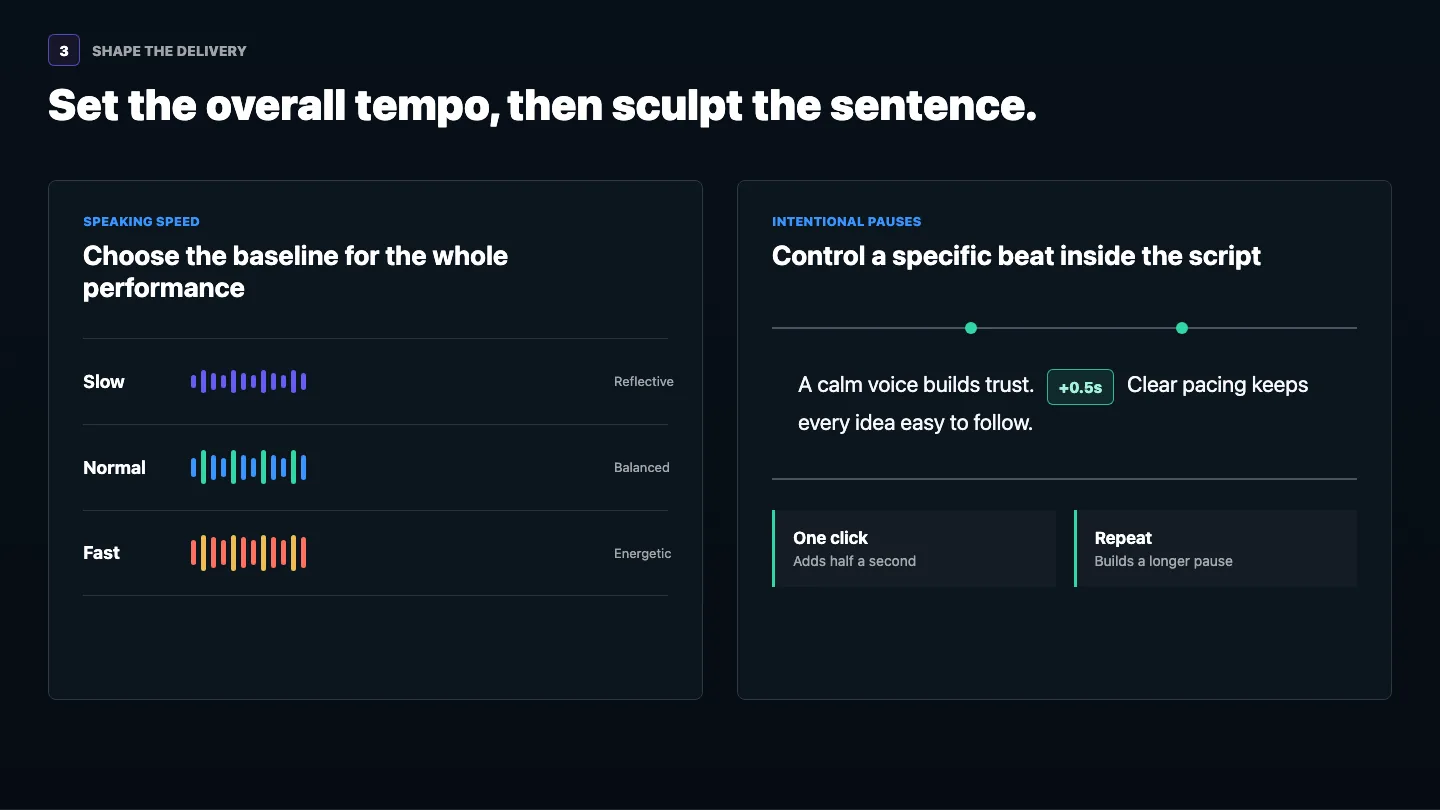
Bí quyết: hãy thêm khoảng nghỉ ở những chỗ mà một người dẫn thật sẽ lấy hơi, chuyển ý hoặc để một luận điểm ngấm vào người nghe. Quá nhiều khoảng nghỉ sẽ làm phần thể hiện trở nên vụn vặt, vì vậy sau khi chỉnh sửa hãy nghe thử cả câu, chứ không chỉ đoạn bạn vừa thay đổi.
Bước 5: Chỉ đạo cách thể hiện bằng Voice Enhance
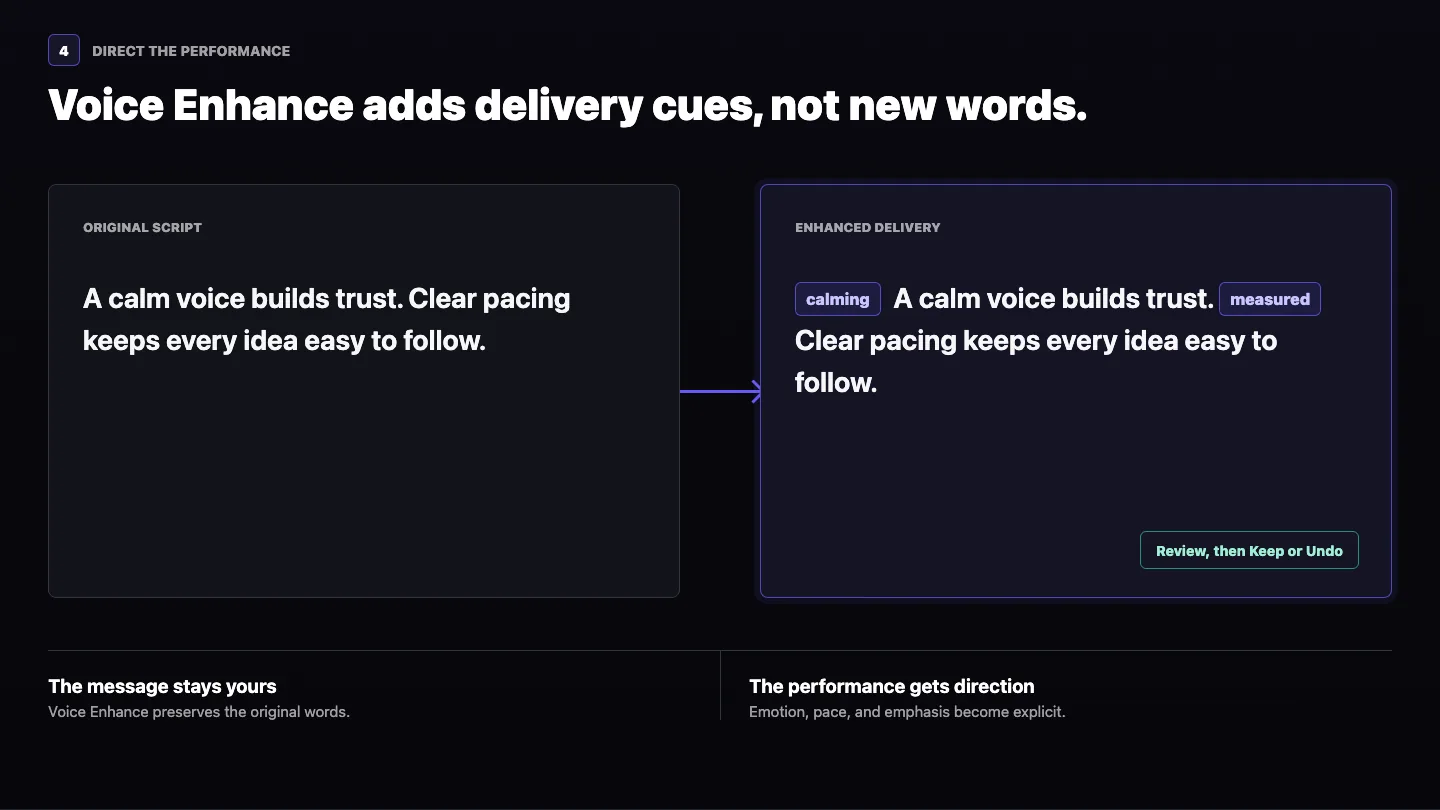
Hãy nhấp Voice Enhance khi câu chữ đã ổn nhưng cách thể hiện mong muốn vẫn chưa rõ ràng. VisionStory bổ sung các chỉ dẫn thể hiện về cảm xúc, nhịp nói và nhấn nhá, đồng thời vẫn giữ nguyên câu chữ gốc của bạn.
Hãy xem lại kịch bản đã được tăng cường trước khi tiếp tục. Chọn Keep khi các chỉ dẫn đúng với ý bạn, hoặc Undo để quay về bản gốc. Tính năng này phát huy giá trị khi một kịch bản cần định hướng cảm xúc rõ ràng nhưng không nên viết lại câu chữ.
Bước 6: Nghe thử kịch bản thật của bạn trước khi tạo video
Nhấp Preview Audio sau khi đã chốt xong giọng nói, tốc độ, khoảng nghỉ và các chỉ dẫn tăng cường. Hãy nghe hết cả đoạn thay vì chỉ đánh giá qua vài từ đầu tiên, đồng thời kiểm tra cách phát âm, giọng địa phương, nhịp điệu, phần kết câu, khoảng nghỉ và mức độ phù hợp về cảm xúc.
Khi vẫn đang so sánh các ứng viên, hãy bắt đầu bằng một câu ngắn mang tính đại diện. Khi danh sách rút gọn chỉ còn hai hoặc ba giọng, hãy nghe thử một đoạn có chứa những tên riêng, con số, thuật ngữ kỹ thuật hoặc những nhịp cảm xúc quan trọng nhất trong video hoàn chỉnh — đó chính là chỗ các giọng nói bộc lộ khác biệt.
Hạn mức nghe thử: tính năng nghe thử âm thanh đi kèm một hạn mức ký tự miễn phí, được làm mới theo chu kỳ trượt 24 giờ. Sau khi dùng hết hạn mức đó, mỗi lần tạo bản nghe thử tốn 1 Credit cho mỗi 500 ký tự. Xem cách Credit của VisionStory hoạt động để có bức tranh đầy đủ.
Bước 7: Tạo video một lần để avatar ghi nhớ giọng nói
Việc chọn một giọng nói sẽ thay đổi thiết lập hiện tại trong trình chỉnh sửa, nhưng chỉ chọn thôi thì giọng nói đó chưa được lưu vào avatar. Hãy tạo một video bằng giọng nói bạn vừa chọn. Khi đó VisionStory sẽ ghi nhớ cặp avatar – giọng nói này và khôi phục nó trong lần tiếp theo bạn dùng chính avatar đó.
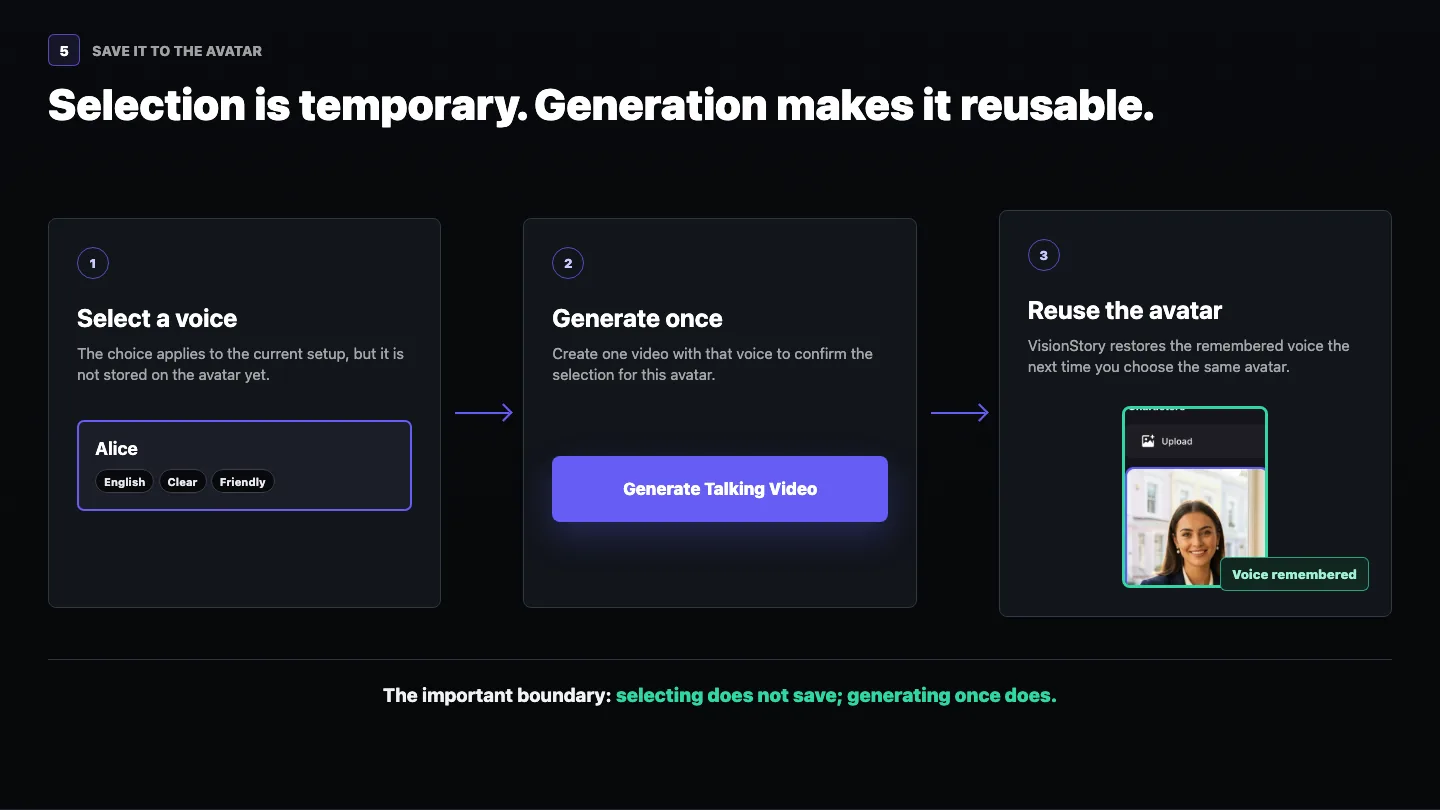
Đó là lý do lựa chọn này đáng để cân nhắc kỹ. Một khi avatar và giọng nói đã được ghép đôi, mọi video sau này đều bắt đầu từ một người dẫn nhất quán thay vì phải quyết định lại từ đầu.
Vì sao giọng nói AI nghe như máy — và cách khắc phục
Khi một bản lồng tiếng được tạo ra nghe có vẻ nhân tạo, nguyên nhân thường nằm ở một trong năm lỗi có thể sửa được, chứ không phải ở bản thân mô hình giọng nói.
- Chọn sai giọng cho kịch bản. Một giọng thuyết minh đọc lời quảng cáo sẽ nghe rất phẳng. Hãy lọc lại danh sách rút gọn theo mục đích sử dụng trước khi đổ lỗi cho chất lượng.
- Không có khoảng nghỉ. Người thật thì phải thở. Một khối văn bản liền mạch không có nhịp nghỉ sẽ nghe như máy đọc, vì vậy hãy thêm các khoảng nghỉ nửa giây ở những chỗ chuyển ý.
- Đặt tốc độ một lần rồi quên luôn. Fast khiến những câu dày đặc thông tin trở nên nhòe nhoẹt; Slow khiến một đoạn quảng cáo ngắn bị lê thê. Hãy khớp nhịp độ với loại nội dung.
- Dấu câu mơ hồ. Những câu dài không ngắt, thiếu dấu phẩy và từ viết tắt chưa được viết đầy đủ đều đẩy giọng đọc về phía đơn điệu. Hãy dọn dẹp kịch bản trước.
- Không có chỉ dẫn cảm xúc. Nếu ý đồ không nằm trong văn bản thì giọng nói không thể tự suy ra — và đó chính là công dụng của Voice Enhance.
Khắc phục năm điều đó và hầu hết những phàn nàn về giọng nói AI nghe như máy sẽ biến mất mà không cần đổi giọng.
Nếu nhà cung cấp ngừng cung cấp giọng nói bạn đang dùng
VisionStory lấy giọng nói từ nhiều nhà cung cấp khác nhau, và một nhà cung cấp có thể gỡ một giọng nói khỏi kho của họ. Khi điều đó xảy ra, giọng nói đó không thể được khôi phục vào Voice Library công khai.
Nếu giọng nói bạn vẫn tin dùng đã biến mất, hãy tìm một đoạn âm thanh sạch từ video trước đó chỉ có duy nhất giọng nói ấy, rồi dùng nó làm âm thanh nguồn trong Voice Clone. Bản nhân bản có thể tạo ra một giọng thay thế khá giống, tuy nhiên đừng kỳ vọng nghe giống hệt.
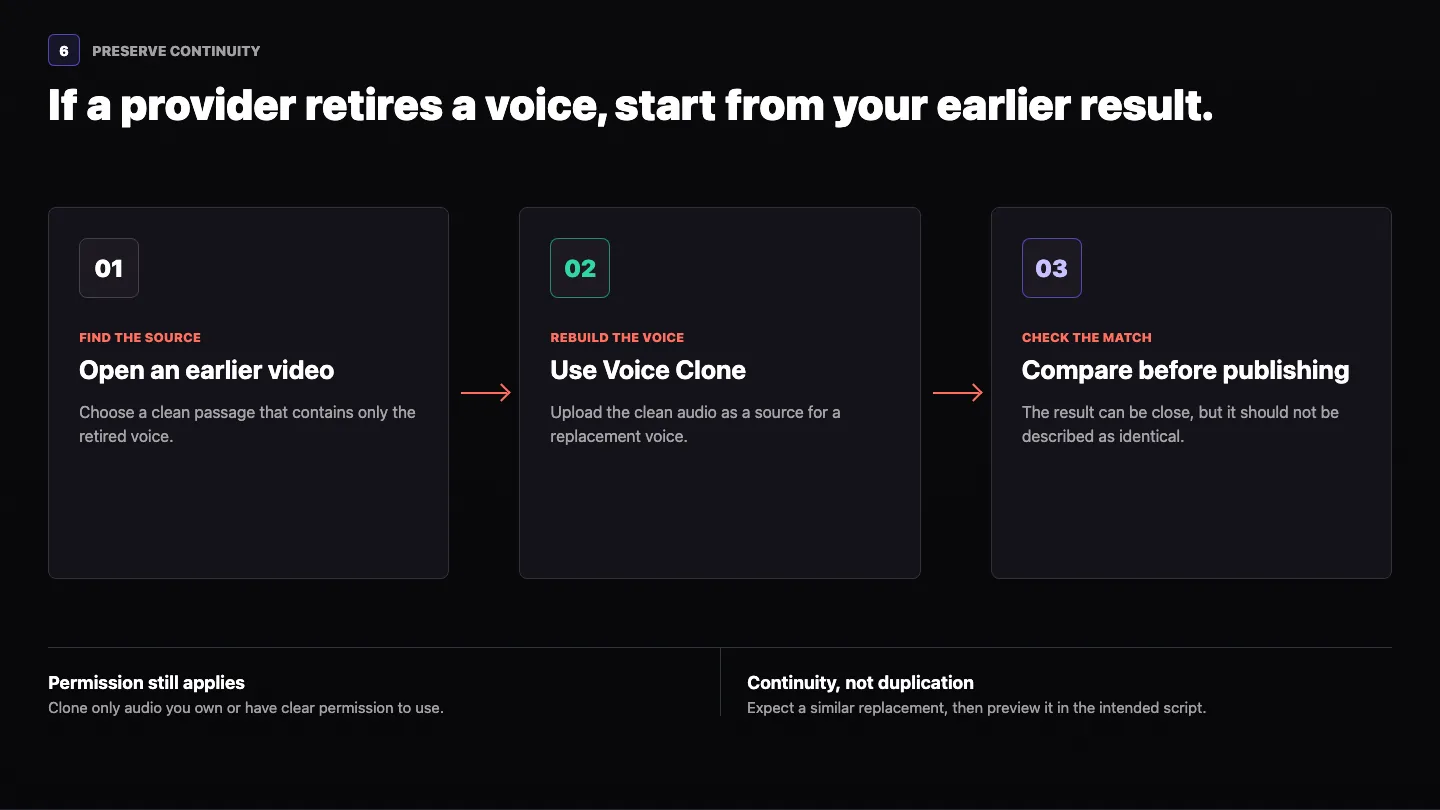
Cần có sự cho phép: chỉ nhân bản âm thanh mà bạn sở hữu hoặc được phép sử dụng rõ ràng, và hãy nghe thử giọng thay thế với kịch bản bạn định dùng trước khi xuất bản.
Danh sách kiểm tra giọng nói AI trước khi bạn tạo video
- Chọn giọng địa phương phù hợp với khán giả, không chỉ chọn ngôn ngữ.
- Dùng các thẻ hồ sơ để lọc ra danh sách rút gọn, rồi để đôi tai bạn quyết định.
- Nghe thử các tên riêng, con số và thuật ngữ khó lấy từ kịch bản thật của bạn.
- Đặt tốc độ tổng thể trước khi thêm khoảng nghỉ ở từng vị trí.
- Chỉ dùng Voice Enhance khi cách thể hiện cần chỉ dẫn rõ ràng hơn.
- Nghe trọn vẹn bản nghe thử, đừng chỉ nghe câu đầu tiên.
- Tạo video một lần khi bạn muốn avatar ghi nhớ giọng nói đó.
- Ghi tên giọng nói đã chọn vào ghi chú thương hiệu hoặc chiến dịch của bạn.
Khi đã chốt được giọng nói, phần còn lại sẽ rất nhanh. Hãy đưa chính thiết lập đó đến một video hoàn chỉnh với cách tạo avatar AI biết nói, hoặc mở Chuyển Văn Bản Thành Giọng Nói khi bạn chỉ cần phần âm thanh.
