AI 對嘴同步影片生成器
揀一張面,加上聲音,即刻得到每個字都對得上口型嘅影片。你可以輸入講稿、上載自己音訊,或喺瀏覽器直接錄音——VisionStory 會把嘴形、表情同頭部動作同步到你聽到嘅內容。
開始對嘴同步揀一張面,加上聲音,即刻得到每個字都對得上口型嘅影片。你可以輸入講稿、上載自己音訊,或喺瀏覽器直接錄音——VisionStory 會把嘴形、表情同頭部動作同步到你聽到嘅內容。
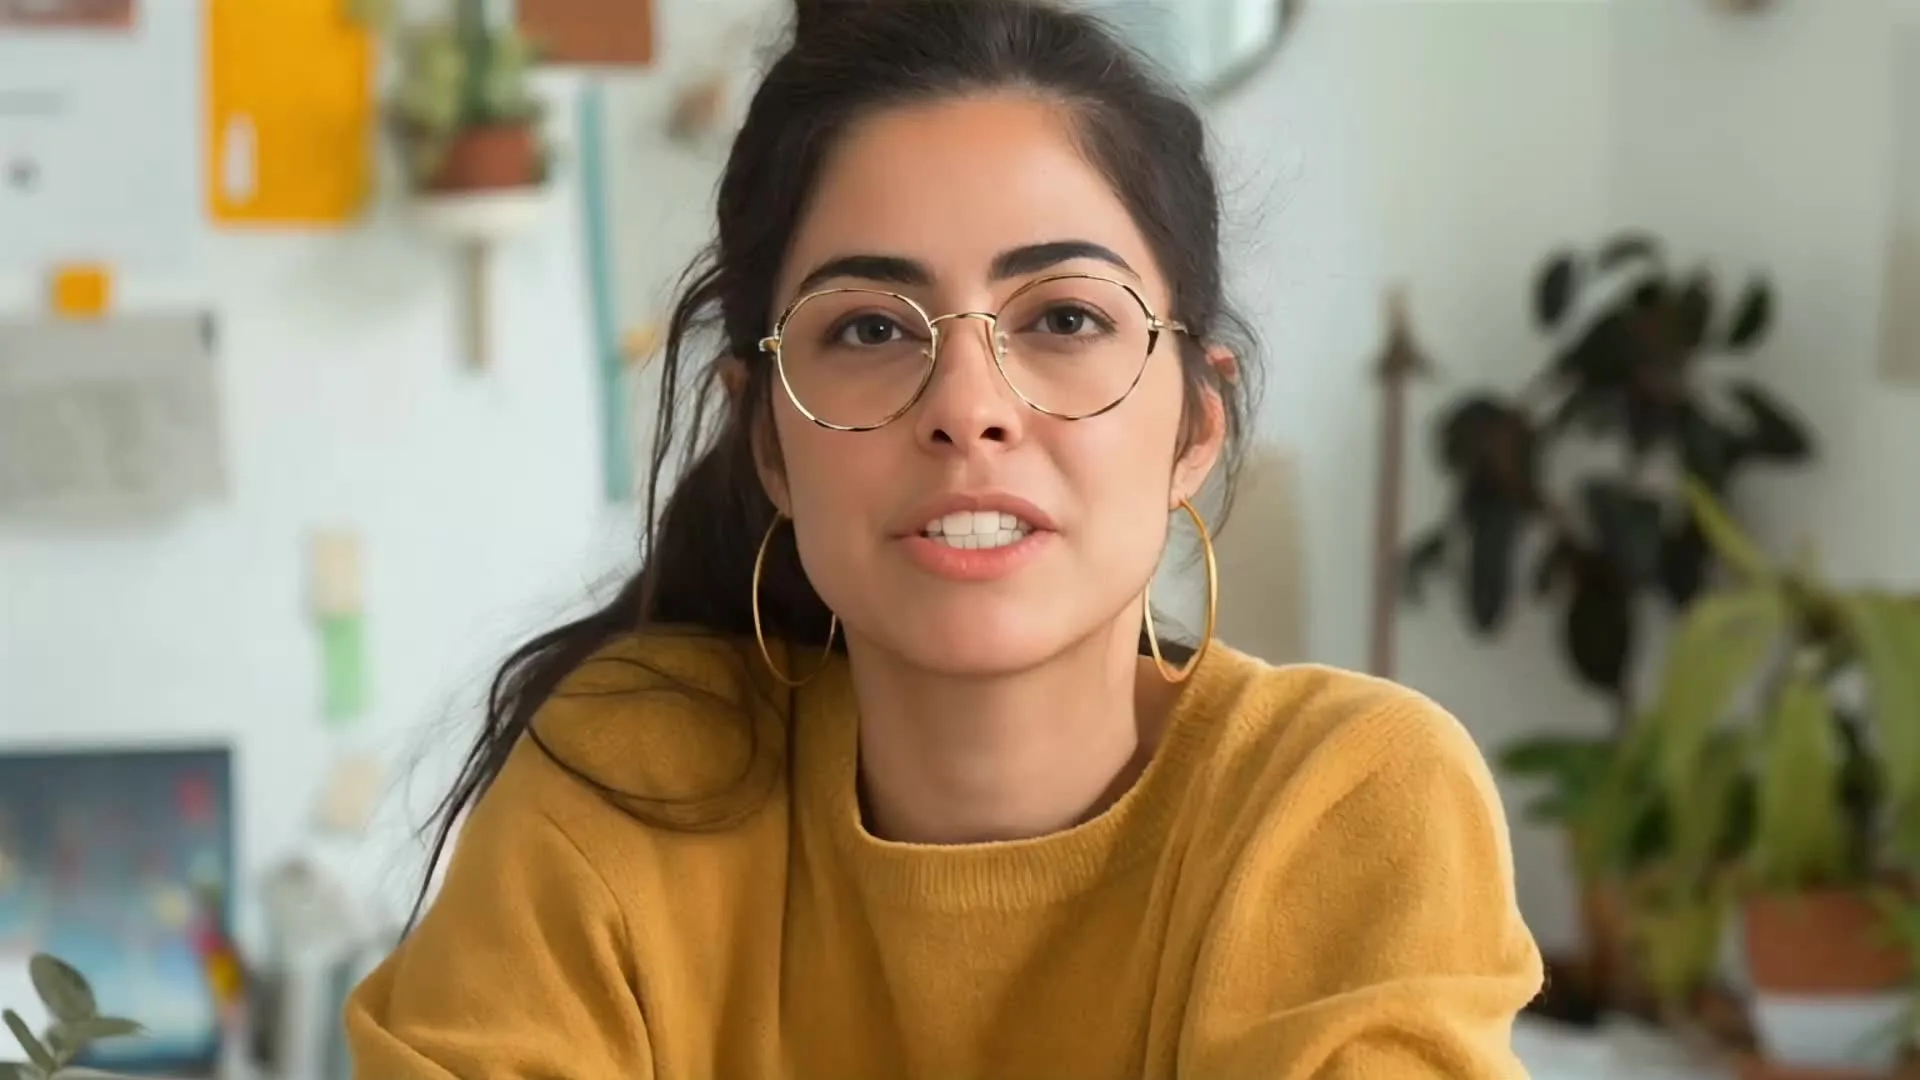
開始對嘴同步開聲聽下。同一張上面嘅人像會講出 15 秒課程簡介——嘴形、停頓同表情都會跟住聲音走。
輸入音訊
由你已有嘅音訊開始——或者只用幾行文字由零開始。
寫低角色要講咩,再喺 88 種語言嘅 1,000+ AI 音色中揀一把,嘴形就會跟住生成出嚟嘅語音同步。
匯入旁白、Podcast 片段、訪問回答或歌曲,並將面部同步到嗰段錄音嘅每一個細節。
喺瀏覽器直接錄低你把聲,唔使離開個頁面都可以變成對嘴同步影片。
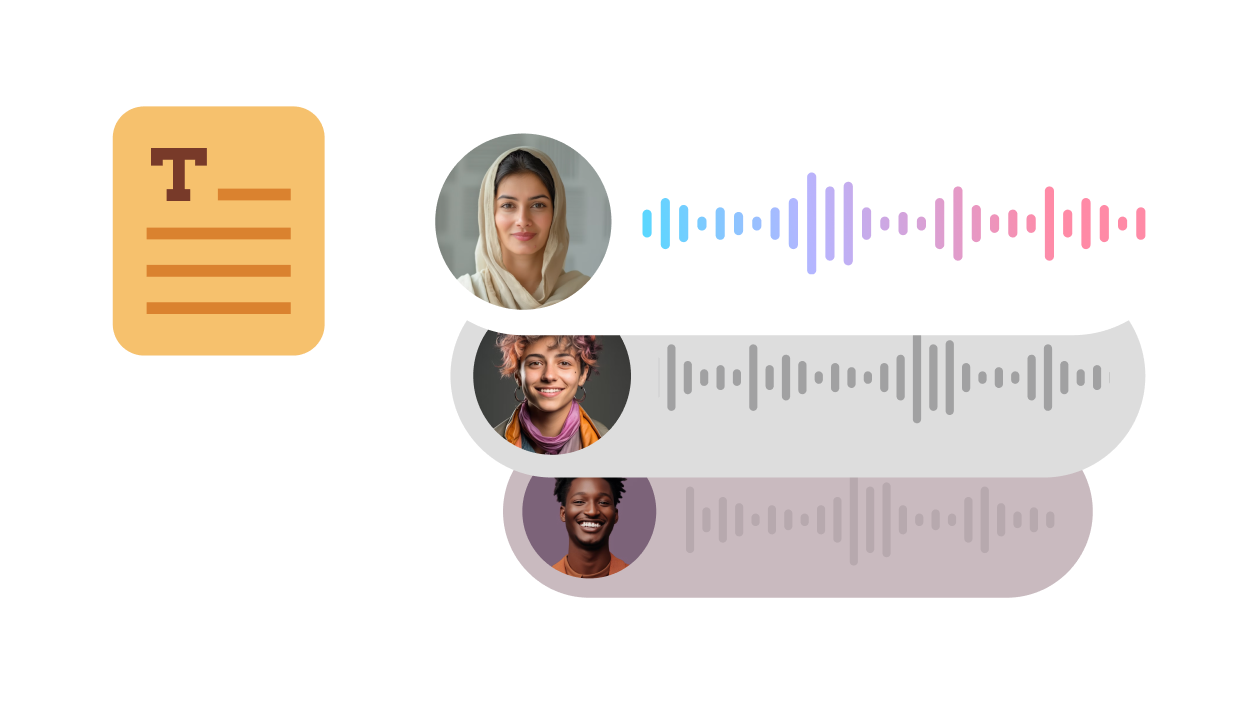
同一張相片同步到 3 段唔同音軌。講法一變,成段片感覺都唔同——語速節奏、表情同能量都會跟住角色講嘅內容走。
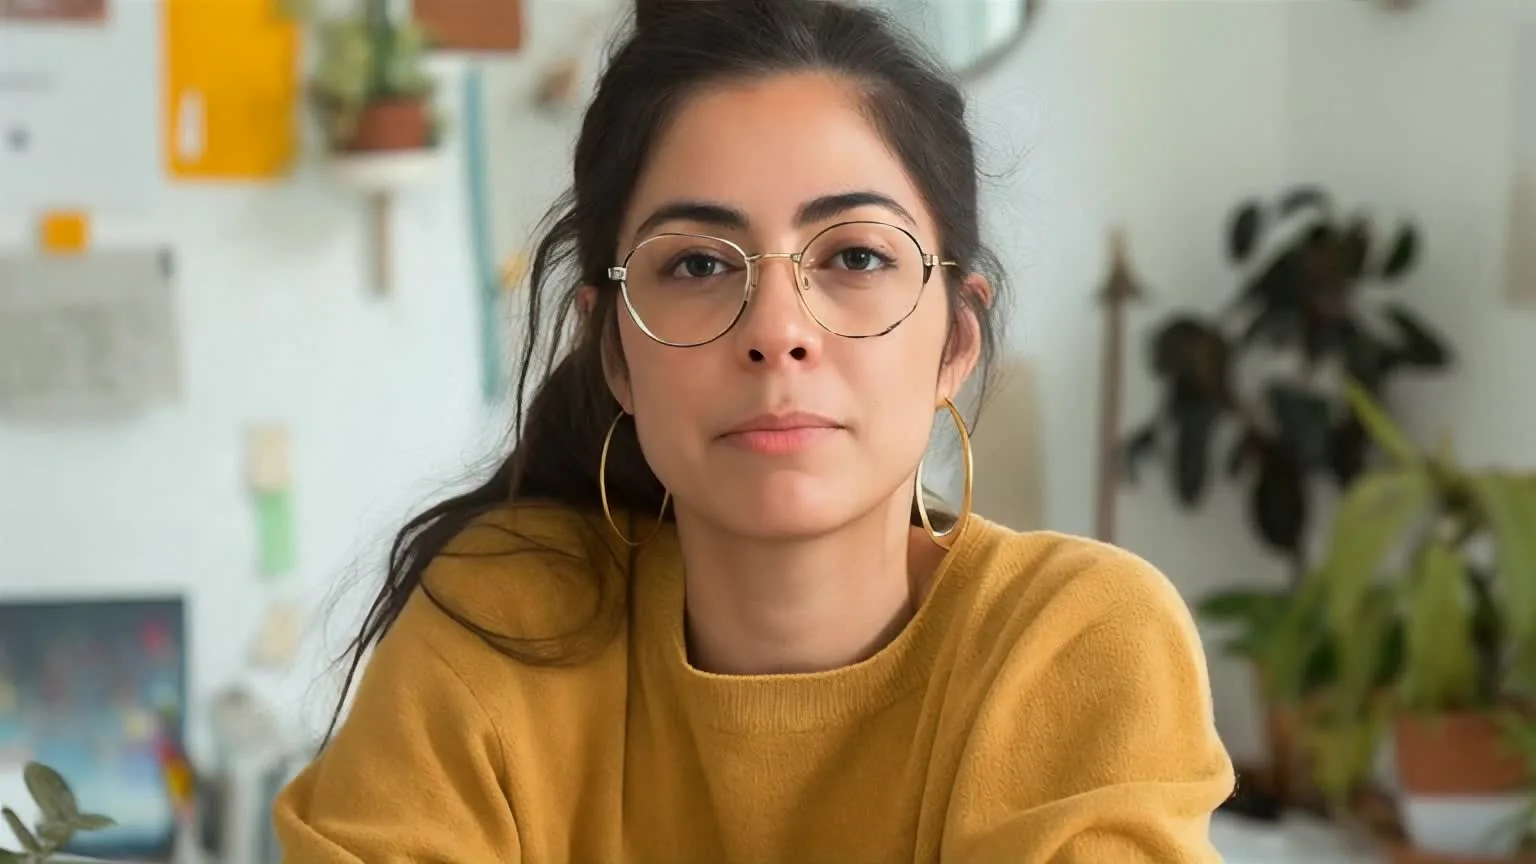
節奏平均、眼神穩定,適合解說、更新同教學內容。
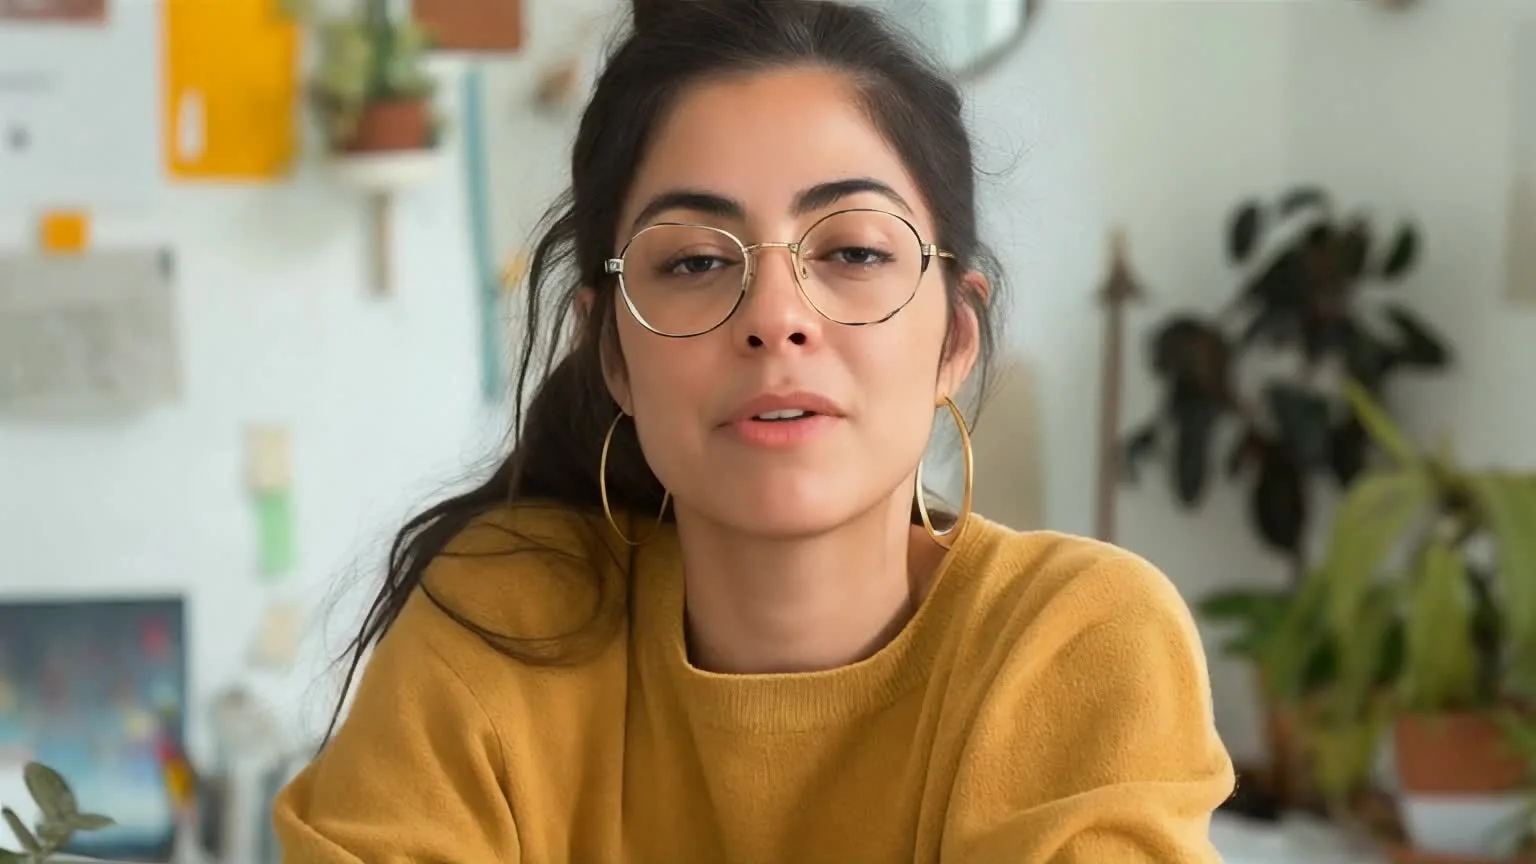
表情更有精神,適合問候、推廣同社交平台開場吸睛。
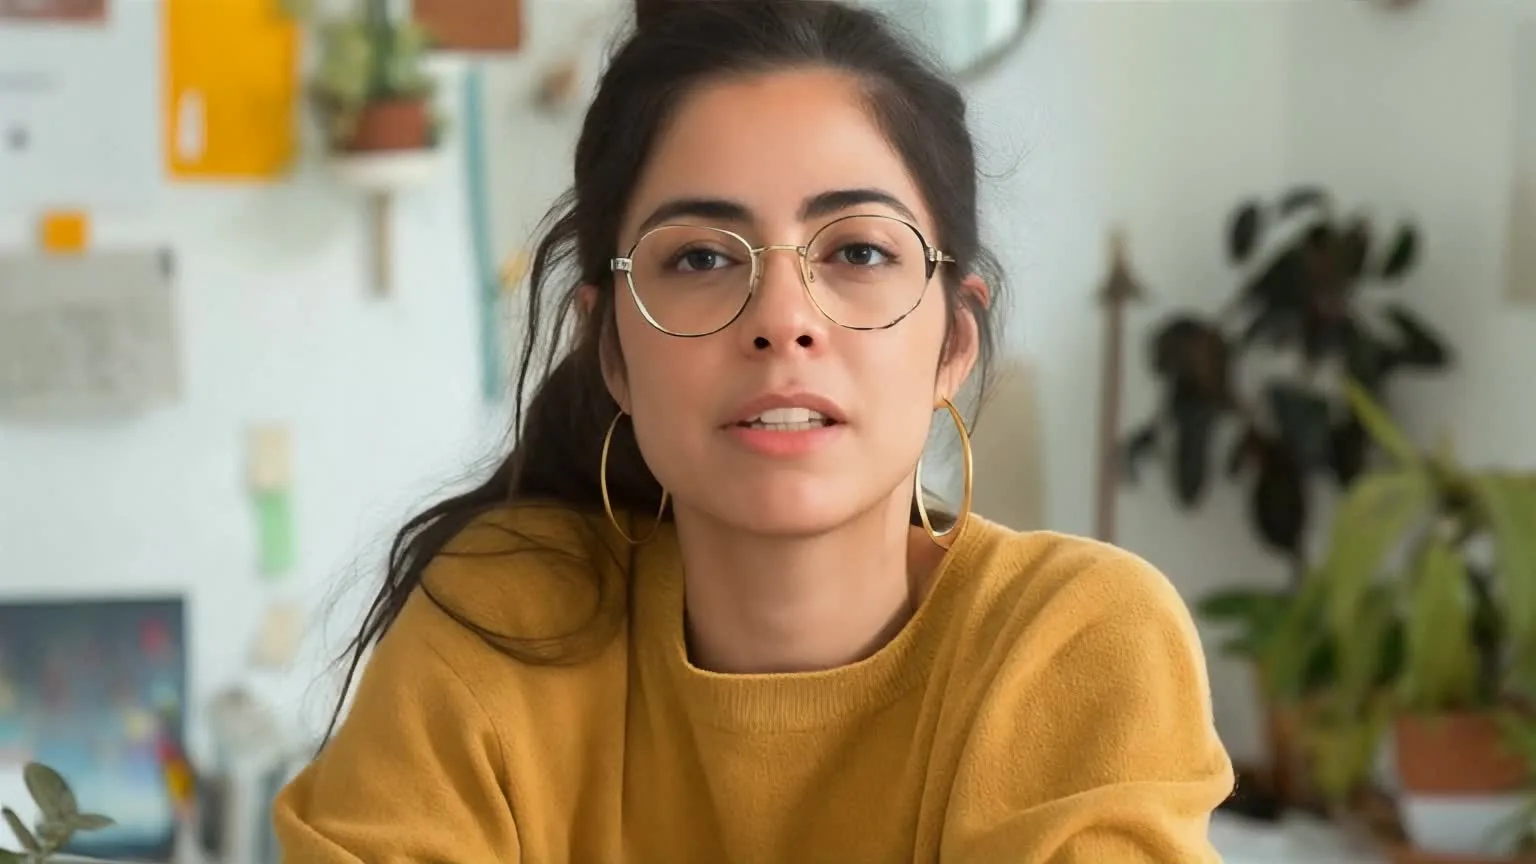
表情更尖銳有火,適合短劇段子、反應片同角色場景。
點樣運作
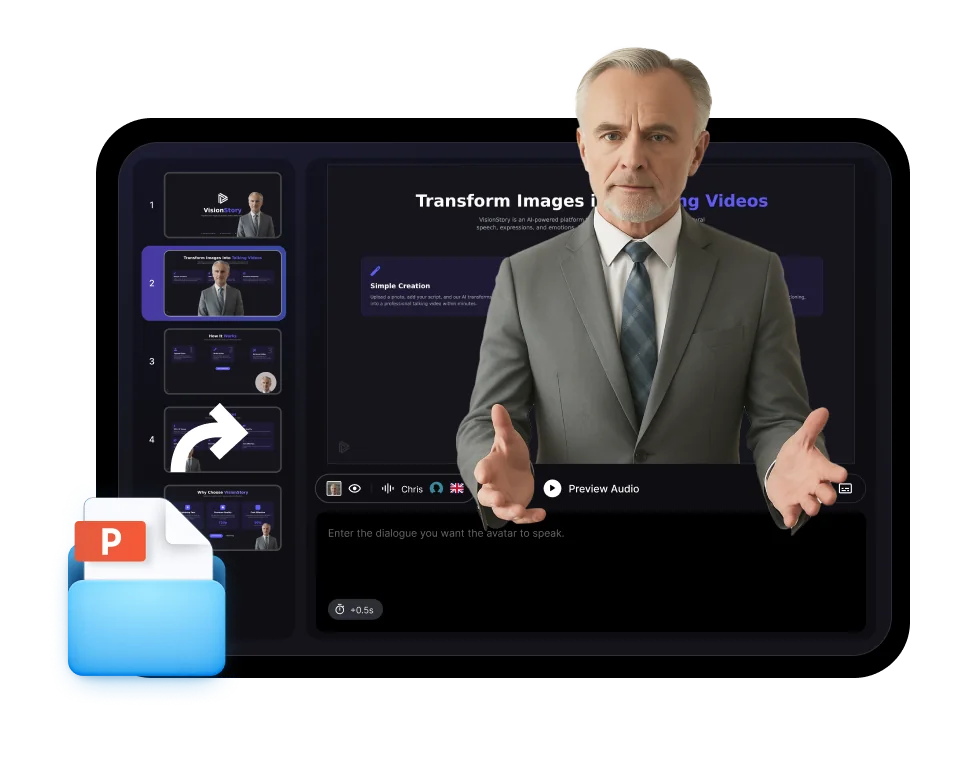
唔使拍攝、唔使關鍵幀、唔使剪時間線——只要一張面加一段聲。
上載清晰正面相片、揀現成虛擬人像,或用文字提示生成全新角色。
輸入講稿並揀一把音色、上載音訊檔,或錄低你自己把聲。
選擇 720P、1080P 或 2K,生成影片,然後下載對嘴同步成品。
點解揀 VisionStory
精準嘴形只係起點;表情、眨眼同頭部動作,先令結果更似「真係講緊」,而唔係動畫咁。
嘴形會跟住音訊每個音節走,口型會落喺字上,而唔係只係隨音量開開合合。
人像、插畫角色、品牌吉祥物、動物、AI 生成角色——只要面部清晰,就可以做對嘴同步。
當你匯入或錄製音訊時,VisionStory 會保留你把聲,並將面部同步到原本時間節奏。想轉另一把音色?用「選擇音色」就可以喺保留演繹嘅情況下轉換錄音。
匯入錄音如果有房間嗡聲或背景噪音,可以開啟「去除雜音」,令聲音同口型都更清晰。
未有錄音?用 88 種語言輸入講稿,再從超過 1,000 款 AI 音色中揀選即可。
同步時會自帶眨眼、面部表情同自然頭部動作,令一張靜態相片都變成可信嘅講者。
可輸出 720P、1080P 或 2K,適用於社交貼文、簡報、產品影片同廣告。
將影片設定為 9:16、1:1 或 16:9 畫面比例,無需重新裁剪,即可適配 Shorts、Reels、TikTok、動態牆或 YouTube。
AI 對嘴會將角色嘅口型動作與音軌同步。喺 VisionStory,你只要提供一張面孔——相片、插畫或現成虛擬人像——再提供音訊(可由講稿生成、上載或錄音)。VisionStory 就會生成一條影片,令嘴唇、表情同頭部動作跟住聲音走。