聲音分身
上傳或錄製音檔樣本、為音色命名,接著前往 VisionStory 複製音色,用於音訊與影片。

新增音色樣本
請使用單一說話者、背景雜音極少的乾淨錄音。
將音訊或影片檔拖放到這裡
MP3、WAV、M4A、MP4、MOV、AVI 或 WebM · 最大 10 MB
上傳或錄製音檔樣本、為音色命名,接著前往 VisionStory 複製音色,用於音訊與影片。
請使用單一說話者、背景雜音極少的乾淨錄音。
將音訊或影片檔拖放到這裡
MP3、WAV、M4A、MP4、MOV、AVI 或 WebM · 最大 10 MB
即使講稿、語言與影片格式不斷變化,分身音色也能讓系列內容的聲音一致、辨識度不跑掉。
創辦人出鏡影片
不用每段都親自錄音,也能規模化產出創辦人近況更新。
在地化培訓
內容拓展到新地區時,也能維持同一個好辨識的聲音。
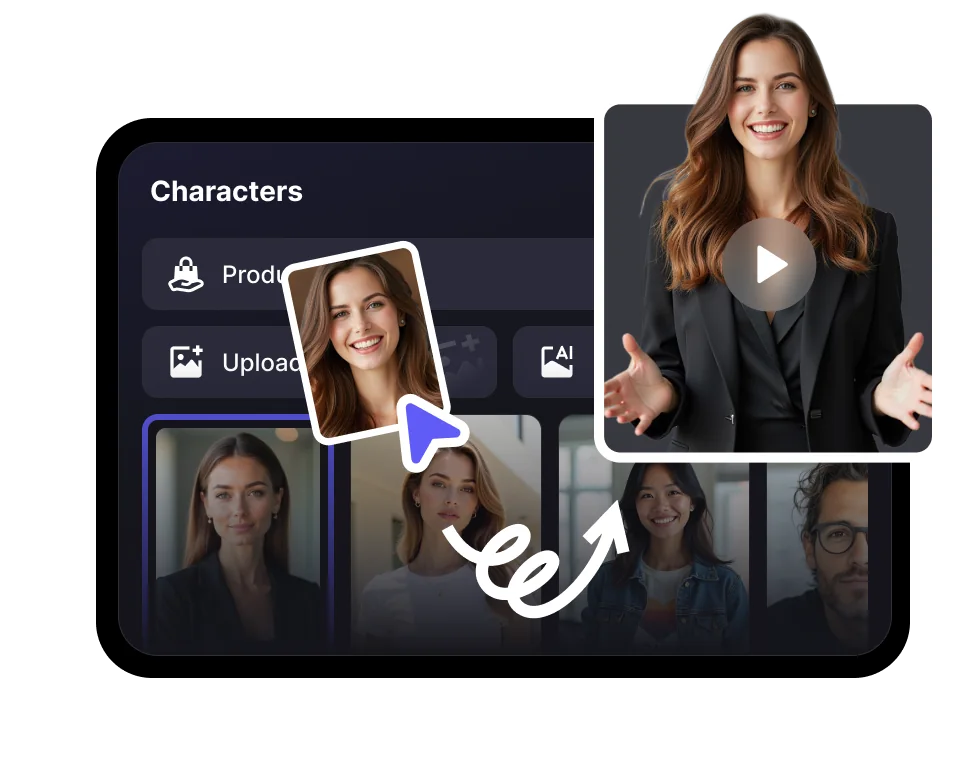
虛擬人像活動
把一致的音色搭配 AI 講者,重複投放多次活動也能維持同樣風格。
先播放原始錄音,再播放對應的 AI 分身音色。每組對照都使用同一位講者的音色。
用來捕捉語氣與節奏的短參考錄音。
把同一套聲音識別套用到生成語音的結果。
第二段參考錄音,節奏感不同。
維持說話者特徵一致的生成輸出。
負責任的複製
僅複製你有權使用的音色,並確保輸出內容符合事先約定的用途與受眾。
你可以複製自己的音色、已簽約的講者音色,或你已取得使用許可的品牌音色。
未經明確同意,請勿複製公眾人物或一般個人的音色。
將分身音色用於已約定的情境,例如培訓、廣告、解說影片或在地化。
複製流程
音色複製是一套可重複使用的資產流程:先錄製乾淨樣本、建立聲音識別、套用到講稿,最後在發佈前完成審核。
錄製清晰語音、降低背景雜音,並保持自然節奏。
建立能捕捉語氣、口音與語速節奏的模型。
將分身音色用於虛擬人像影片、訓練模組與品牌旁白。
發佈前確認發音、語氣,以及授權同意等要求。
音色複製會建立一個 AI 音色,能在朗讀新講稿時保留參考音色的語氣與說話者特徵。