
每段 AI 影片都由一份講稿開始,但真正決定講稿呈現效果嘅,係音色。佢定下主講者嘅口音、年齡、聲線質感、活力同個性 — 而語速、停頓同演繹提示,則決定成品聽起來似真人,定係似機器喺度讀稿。
簡單嚟講:揀選 AI 音色時,先按受眾配對語言同地區口音,再用資料標籤篩出候選名單,然後用自己嘅講稿逐一試聽,最後喺生成前用語速同停頓塑造演繹方式。本指南接下來會喺 VisionStory 入面逐步示範成個流程;VisionStory 嘅 AI 音色庫收錄超過 1,000 個音色,涵蓋 88 種語言。
本指南涵蓋嘅內容:公開嘅音色庫,以及圍繞佢嘅演繹控制項。用自己錄音建立音色屬於另一套流程 — 請參閱如何用 AI 複製你嘅音色。
步驟 1:開啟音色庫,讀懂音色列嘅資訊
開啟 AI 影片,選擇想用嘅虛擬人像,然後撳一下講稿框下方顯示嘅目前音色。音色庫就會喺編輯器上方打開。
每一列都提供 4 項資訊,等你喺撳播放之前,已經可以大致預測聲音效果:
- 語言標籤 — 該音色所講嘅語言。
- 國旗 — 代表地區口音,唔係第二語言。英語音色可以帶有美國、英國、加拿大等唔同國旗。
- 性別與年齡 — 聽眾感受到嘅講者身分。
- 特質與使用情境 — 例如清晰、溫暖、對話感、旁白、教育或社交媒體等描述。
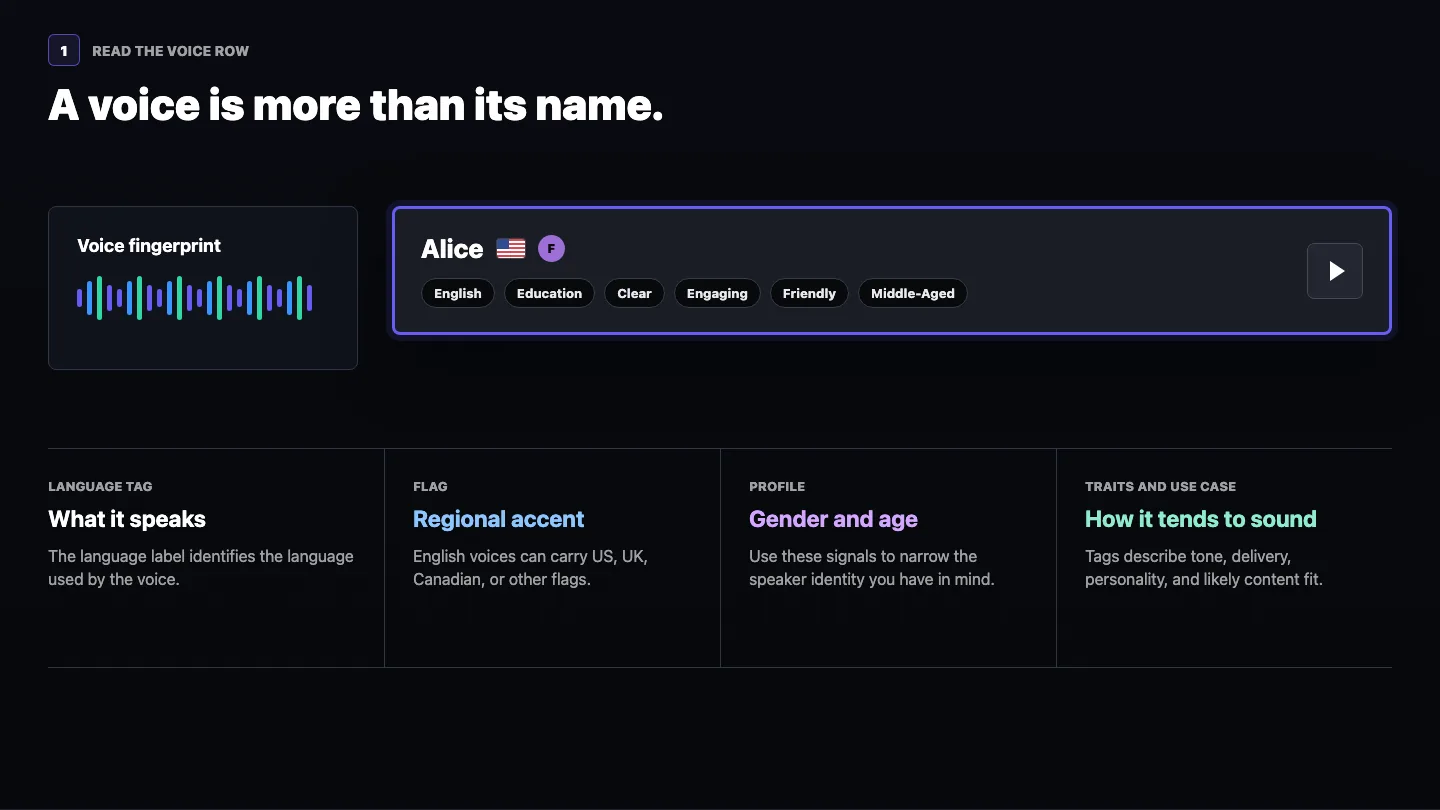
標籤只用嚟篩候選名單,而唔係用嚟落最終決定。兩個標籤幾乎相同嘅音色,喺節奏、聲線質感同活力上仍可能差好遠。
步驟 2:篩選、搜尋並試聽候選名單
一開始範圍要夠闊,先聽得出真正差別,再逐步收窄。探索階段可以善用語言、性別、年齡、使用情境同供應商篩選器;如果你已經知道音色名稱,直接喺搜尋欄輸入就得。
供應商(同一排篩選器入面最後一個)代表生成該音色嘅語音引擎。VisionStory 會用幾種唔同引擎,而每種都有自己最強嘅地方。第一次篩選建議先保持喺 All — 你想要嘅係最啱呢份講稿嘅音色,至於係邊個引擎產生其實唔重要。除非你一早已經知道自己需要咩,例如要揀粵語朗讀,或者要同一把音色同時駕馭幾種語言,先好用呢個篩選器。呢類情況應該揀邊個引擎,步驟 3 會講。
- 建立候選名單。持續篩選或搜尋,直到只剩下幾個候選音色,而唔係成個目錄。
- 逐一試聽候選名單。撳一下音色列右邊嘅播放按鈕,聽試聽樣本。
- 暫停再比較。再撳一次同一個按鈕停止播放,然後先播下一個。
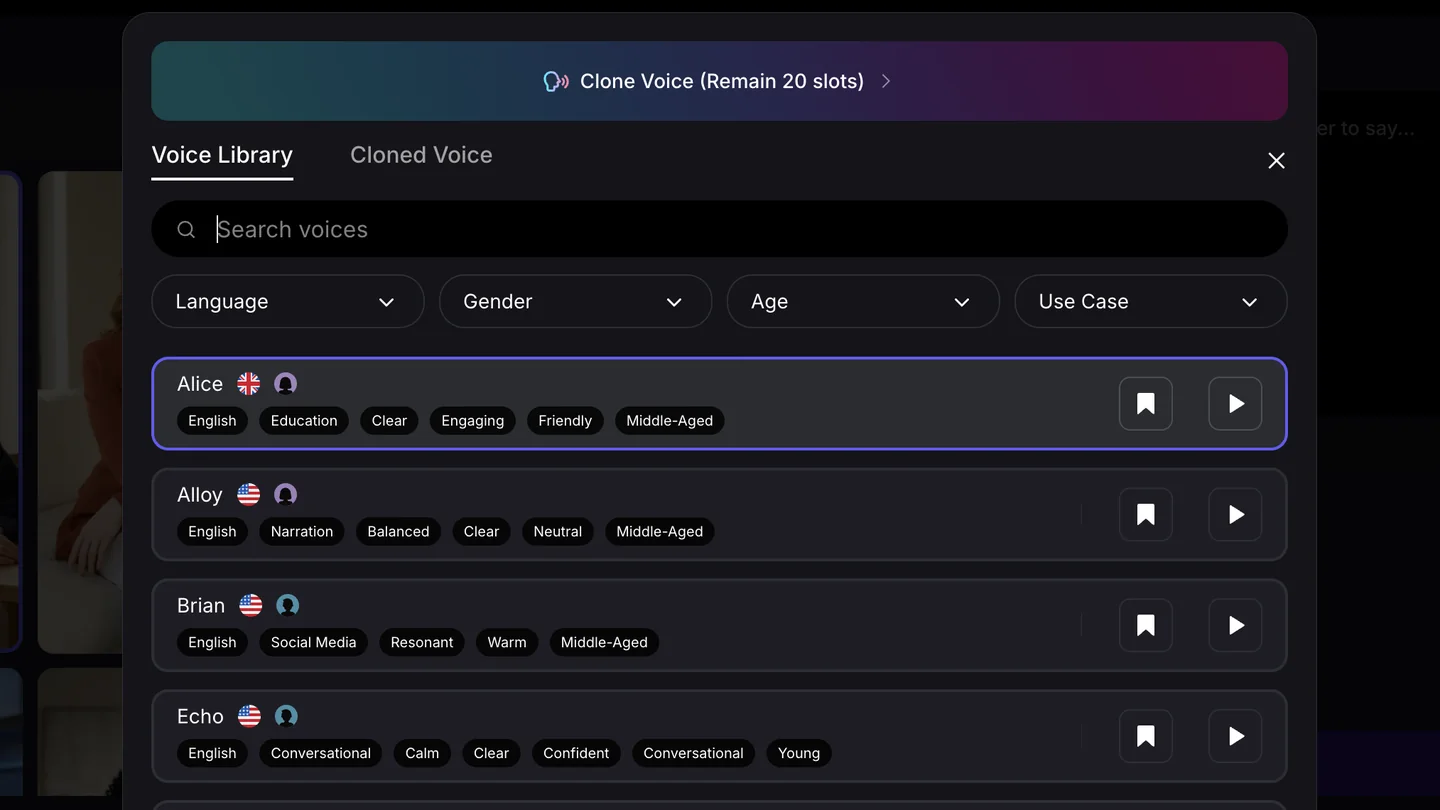
試聽時要留意影片實際需要乜嘢:地區口音、清晰度、活力、親和感、權威感,同埋音色講完一句嘢嘅速度。單獨聽起來好出色嘅音色,用喺教學、銷售、新聞或角色演繹類講稿上,仍然可能唔啱。
步驟 3:令音色配合你嘅內容同受眾
大部分令人失望嘅 AI 配音,問題唔係質素,而係「夾唔夾」。落實選擇之前,先諗清楚呢把音色喺呢條影片入面要做到乜。
| 如果你要製作 | 建議選擇 | 應該避免 |
|---|---|---|
| 教學、解說、課程 | 咬字清晰、語速平穩、中性而帶暖意 | 高能量嘅宣傳式朗讀,會將專業術語讀得太急 |
| 廣告、宣傳片、社交平台短片 | 有活力、有衝擊力,自信而偏年輕嘅音色 | 緩慢、四平八穩嘅旁白,會令開場鈎子失效 |
| 新聞、企業、產品更新 | 具權威感、節奏均勻、聲音修飾少 | 過於隨意或角色感太強嘅音色 |
| 故事敘述、訪談、播客 | 有個性、表現力幅度大 | 平鋪直敘、毫無起伏嘅播報式朗讀 |
| 同一條影片嘅本地化版本 | 為每個市場選用當地母語口音 | 用同一把英文音色讀所有翻譯後嘅講稿 |
| 同一條影片,多個語言版本,但主講者要一致 | 揀一把多語言音色,令每個版本都保留同一個聲音身分 | 每種語言都用唔同音色,聽落就似每次都換咗第二個人 |
口音係最多人設定錯嘅一項。如果你嘅受眾喺倫敦,而你嘅主講音色掛住美國國旗,觀眾一聽就會察覺 — 就算每一個字都讀得準確。選國旗要睇受眾,而唔係淨係睇語言。
表格最後兩行其實係兩個相反方向,但兩個都啱 — 你要喺「夠本地可信」同「主講者一致」之間取捨。如果每個版本都應該有地道感,就每個市場揀母語口音;如果明顯係同一個人向唔同受眾講同一件事,就揀一把多語言音色。
中文係最需要講究口音嘅語言,因為「中文」其實係 3 個唔同受眾:內地用普通話;台灣用台灣普通話 — 書面語相通,但語調同用字會令「內地口音」即刻露餡;而香港同廣東用粵語,佢係另一種口語語言而唔係口音,所以普通話音色係唔得嘅。先喺語言篩選器揀觀眾真係講嘅語言,再去試聽:台北觀眾聽到內地普通話,就好似倫敦觀眾聽到美國口音咁明顯。
按語音引擎揀選
步驟 2 嘅供應商篩選器,會按生成每把音色嘅引擎將音色庫分組。你未必經常需要用,但如果你屬於以下其中一種情況,就可以慳好多時間唔使不停捲。
- ElevenLabs — 音色庫最大、情緒表現幅度最闊。英文旁白、角色演繹,同埋任何需要「演」而唔係只係「讀」嘅講稿,都可以由呢度開始。
- Gemini — 多語言音色。一把音色可以跨語言維持同一個聲音身分,所以當同一條影片要出幾種語言版本、又想全部都係同一位主講者,就喺呢度搵。無論你用邊個語言去篩選,呢類音色都會出現。
- MiniMax — 最自然嘅粵語。針對香港同廣東受眾就用佢。
- Seed — 母語級中文(包括台灣普通話),亦有母語級日語、韓語、西班牙語、葡萄牙語同印尼語音色。當市場唔接受「流利但帶外國味」嘅朗讀,就試下佢。
如果以上都唔係你條片嘅情況,供應商保持喺 All,交畀試聽決定就得。夾唔夾遠比用邊個引擎生成更重要。
步驟 4:設定語速,再加入停頓
撳某一行音色,即可套用到目前設定。然後打開已選音色旁邊嘅語速選單,揀慢、正常或快。
- 慢適合需要沉澱思考嘅解說,以及任何理解比急迫感更重要嘅內容。
- 正常係大部分教學、簡報同說話虛擬人像影片嘅穩妥基準。
- 快可以為短宣傳片同社交短片增添活力,但內容密集嘅講稿會變得難跟。
語速決定成段演繹嘅節奏。想控制句子入面嘅停頓位置,就將游標放喺節拍應該出現嘅位置,再撳停頓控制項。每撳一次會加 0.5 秒;想要更長停頓就再撳一次。
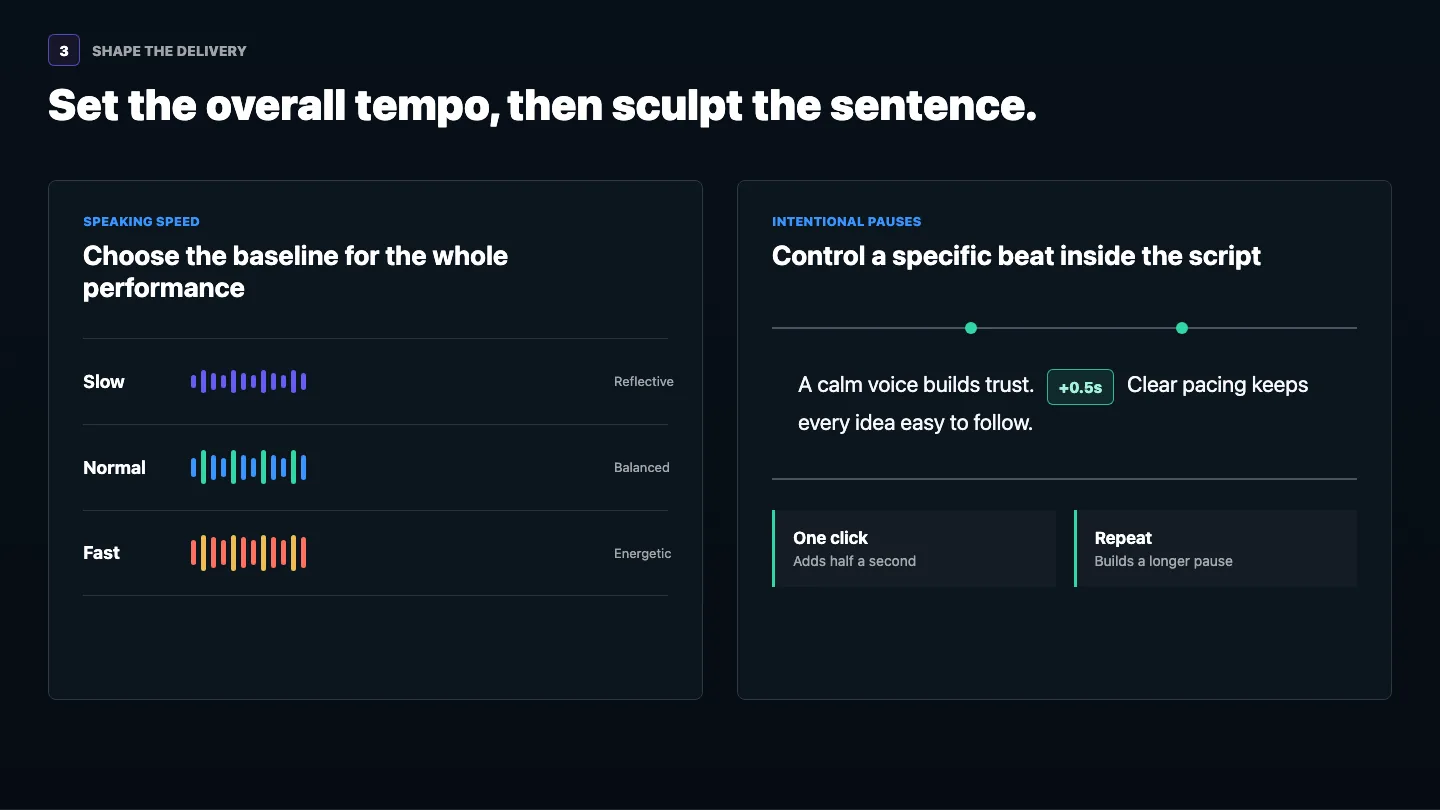
實用技巧:喺真人主講會換氣、轉換想法,或者令一句主張落地嘅位置加入停頓。停頓太多會令演繹變得零碎,所以編輯後要預覽成句,而唔係淨係聽你改咗嗰一段。
步驟 5:用音色增強調校演繹方式
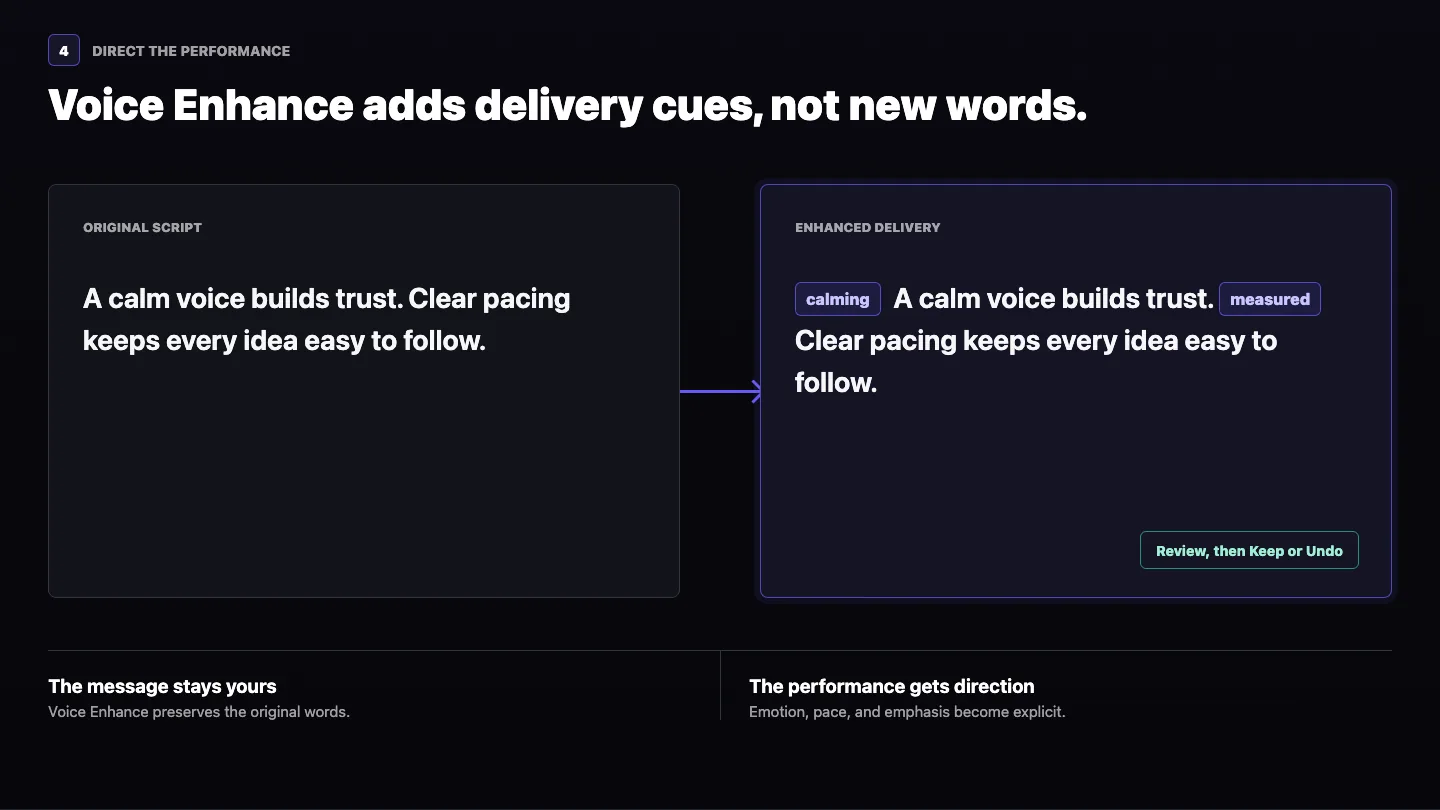
當文字本身已經啱,但想要嘅演繹效果仍未夠清楚時,就撳音色增強。VisionStory 會喺保留你原本用字嘅前提下,加入情緒、節奏同重音嘅演繹提示。
繼續之前,先檢視增強後嘅講稿。如果提示符合你意圖,就揀保留;想返去原稿就揀還原。當講稿需要好清晰嘅情緒方向、但又唔應該改動用字時,呢個功能就最有用。
步驟 6:生成前先用真實講稿預覽
音色、語速、停頓同各項增強提示都設定好之後,撳預覽音訊。成段聽完先判斷,唔好只憑開頭幾個字落結論,並逐一檢查發音、口音、節奏、句尾語調、停頓同情緒係咪貼合。
仲喺度比較多個候選音色時,先用一句有代表性嘅短句試聽。當候選名單收窄到 2-3 個之後,再試聽一段包含成片最關鍵嘅人名、數字、專業術語或情緒轉折嘅文字 — 差異通常就喺呢啲位拉開。
預覽額度:音訊預覽附有免費字元額度,以滾動嘅 24 小時週期重設。額度用完後,預覽生成費用為每 500 個字元 1 點數。完整說明請參閱VisionStory 點數運作方式。
步驟 7:先生成一次,令虛擬人像記住音色
選擇音色會改動目前編輯器設定,但淨係選擇並唔會將該音色儲存到虛擬人像。請用你揀好嘅音色生成 1 條影片,VisionStory 之後就會記住呢個配對,下次再用同一個虛擬人像時自動還原。
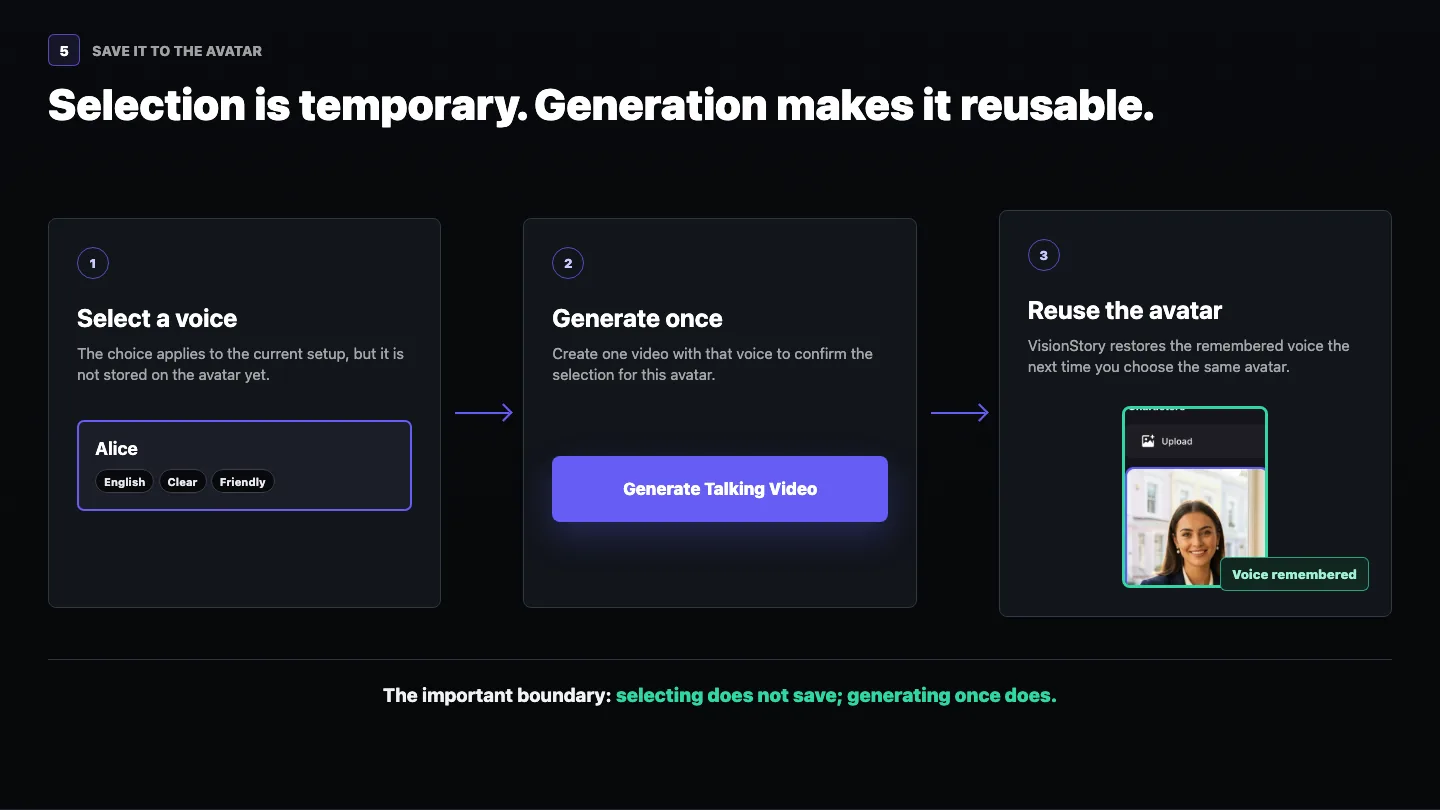
正因如此,呢個選擇值得花心思。一旦虛擬人像同音色完成配對,之後每條影片都會由同一位一致嘅主講者開始,而唔係每次都要重新決定。
點解 AI 音色聽落好機械 — 同埋點樣修正
當生成嘅配音聽落好合成,多數都係以下 5 個可修正原因之一,而唔係音色模型本身。
- 音色同講稿唔匹配。用旁白音色讀廣告文案自然會顯得平淡。怪罪質素之前,先按使用情境重新篩候選名單。
- 冇停頓。真人講嘢會呼吸。一大段文字完全冇節拍就會似機器,所以要喺意思分界位加半秒停頓。
- 語速設定一次就忘記。太快會令密集句子變得糊;太慢會令短宣傳片拖。節奏要配合內容類型。
- 標點含糊。句子連寫不斷、漏咗逗號、縮寫冇展開,都會令演繹更接近單調。先整理講稿。
- 冇情緒方向。如果文字入面冇清楚意圖,音色就推斷唔到 — 呢正正係音色增強嘅用途。
修好呢 5 點,大部分關於 AI 音色機械感嘅抱怨都會消失,甚至完全唔使換音色。
如果供應商下架咗你用緊嘅音色
VisionStory 嘅音色來自多家供應商,而供應商有可能喺自己目錄入面移除某個音色。一旦發生,該音色就無法加返入公開音色庫。
如果你一直用緊嘅音色唔見咗,可以喺舊影片入面搵一段淨係得嗰把音色、乾淨嘅片段,然後用嚟做 音色複製 嘅來源音訊。複製出來可以好接近原音,但唔應該期望聽落完全一樣。
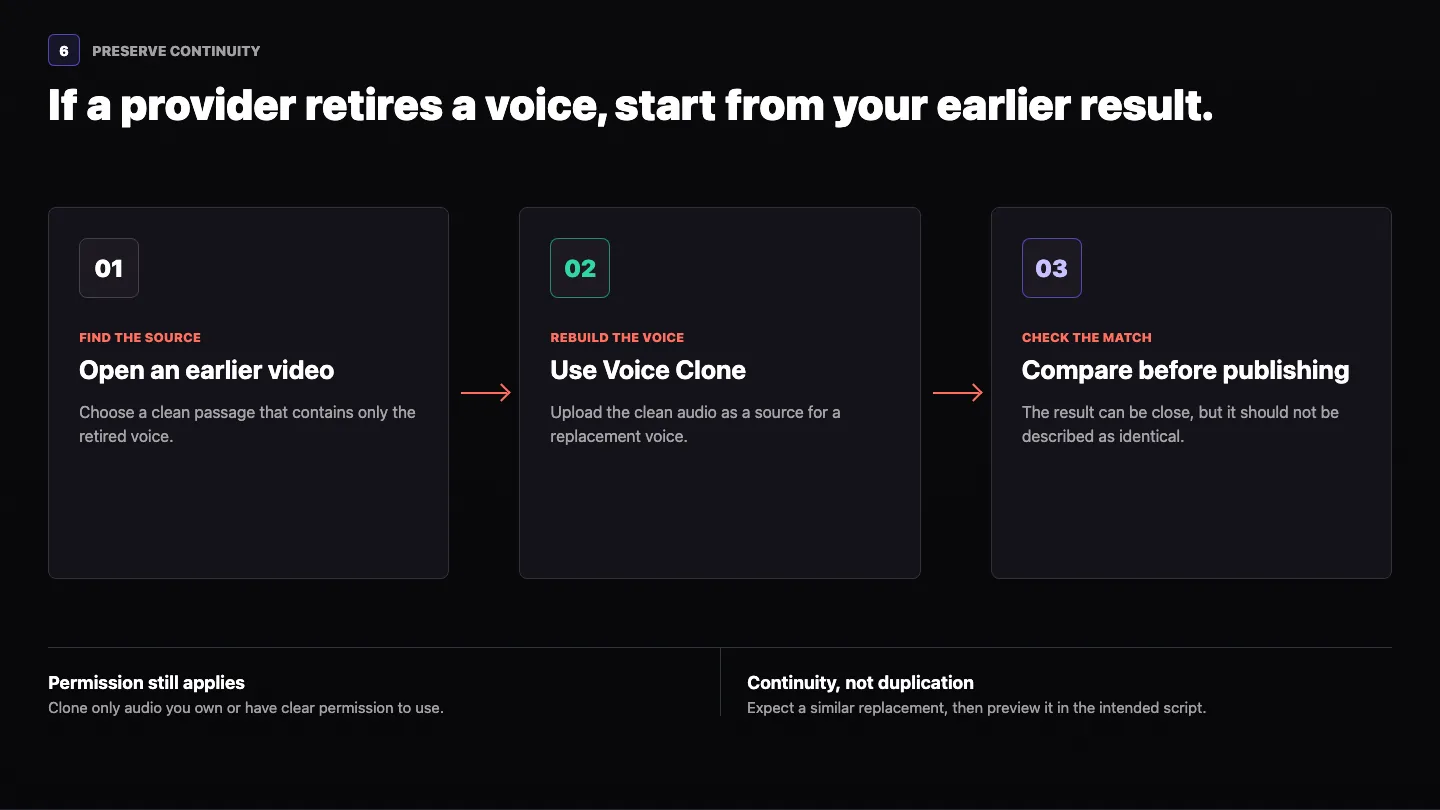
必須取得授權:只可複製你擁有或已獲明確授權使用嘅音訊,並喺發佈前用你打算使用嘅講稿試聽替代音色。
生成前嘅 AI 音色檢查清單
- 按受眾揀地區口音,而唔係淨係揀語言。
- 先用資料標籤篩候選名單,再交畀耳仔做最後決定。
- 用真實講稿入面嘅人名、數字同難讀術語試聽。
- 先設定整體語速,再加局部停頓。
- 只喺演繹需要更清晰方向時先用音色增強。
- 要聽完整段預覽,唔好只聽第一句。
- 想虛擬人像記住音色,就先生成一次。
- 將揀定嘅音色名稱記低喺品牌或宣傳活動筆記。
音色一鎖定,之後就好快。想用同一組設定做到成片,可以參考如何製作 AI 說話虛擬人像;如果只需要音訊,就開啟文字轉語音。
