AIリップシンク動画生成器
顔を選んで音を入れるだけで、言葉のひとつひとつに唇が合う動画が完成。スクリプト入力、音声のアップロード、またはブラウザで録音 — VisionStoryが口の動き・表情・頭の動きを、聞こえる音に合わせて同期します。
リップシンクを始める顔を選んで音を入れるだけで、言葉のひとつひとつに唇が合う動画が完成。スクリプト入力、音声のアップロード、またはブラウザで録音 — VisionStoryが口の動き・表情・頭の動きを、聞こえる音に合わせて同期します。
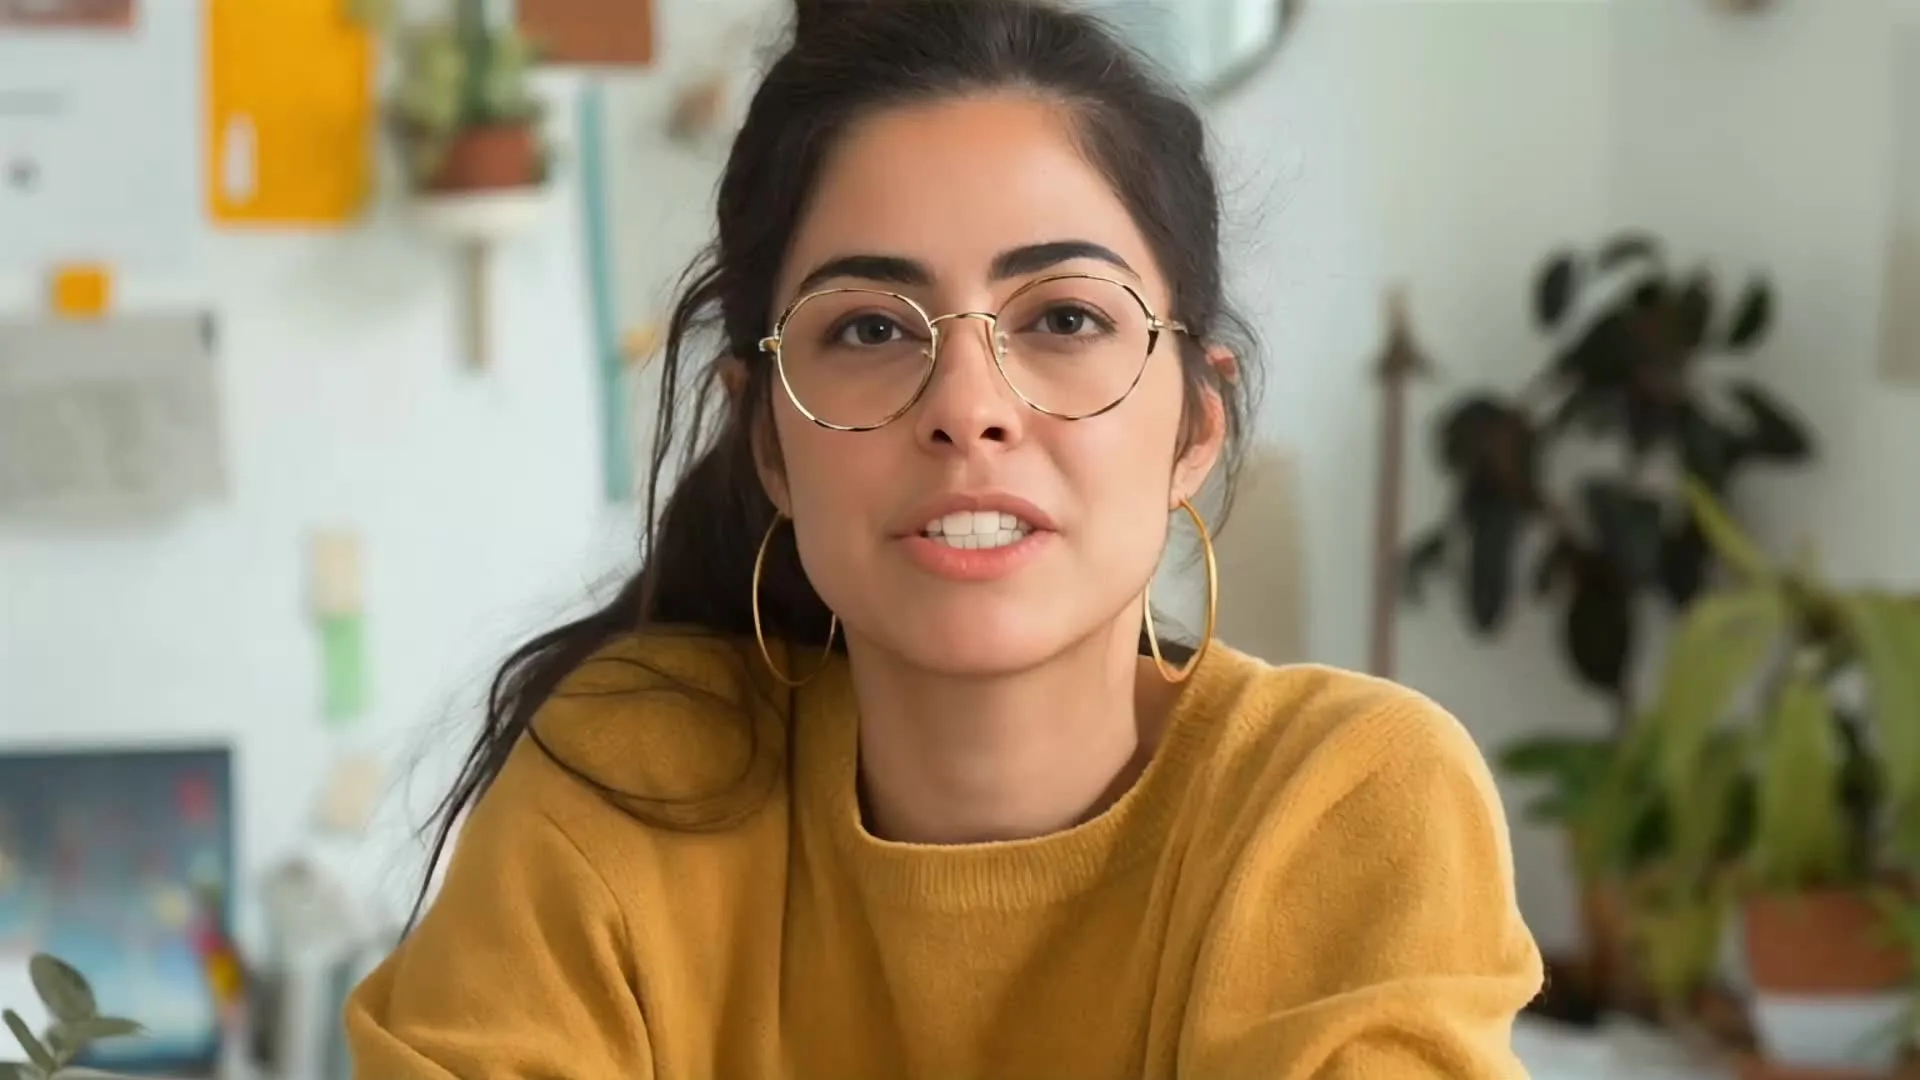
リップシンクを始める音声をオンにしてください。上の同じポートレートが15秒のコース導入を話します — 口の形、間(ポーズ)、表情が音声に追従します。
音声入力
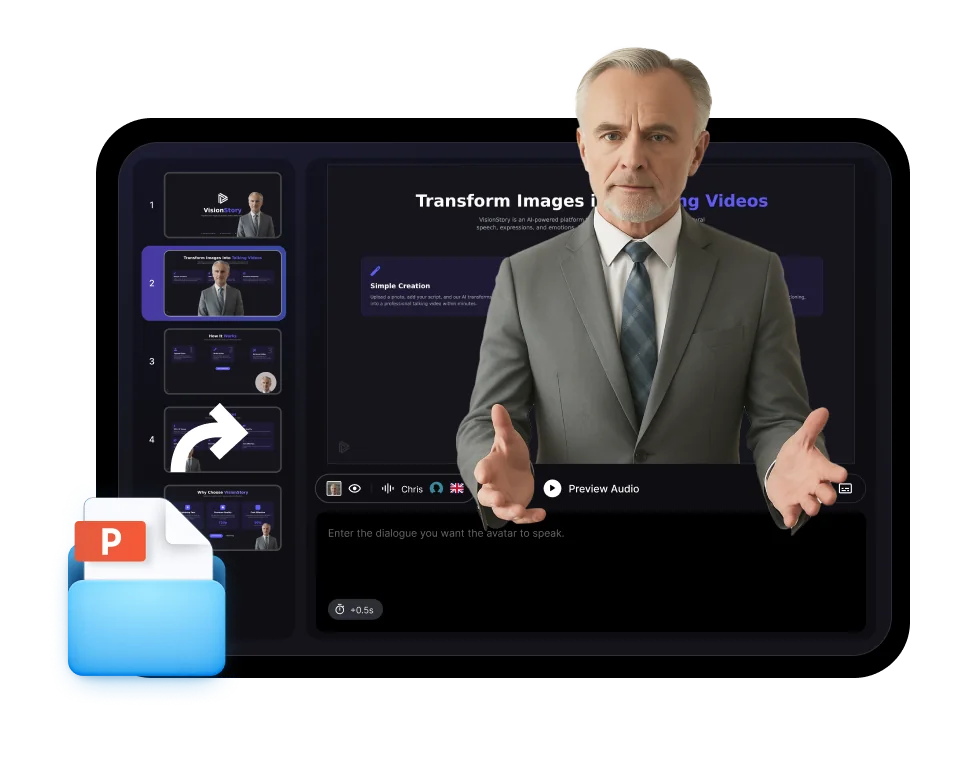
手元の音声からでも、数行のテキストだけからでも始められます。
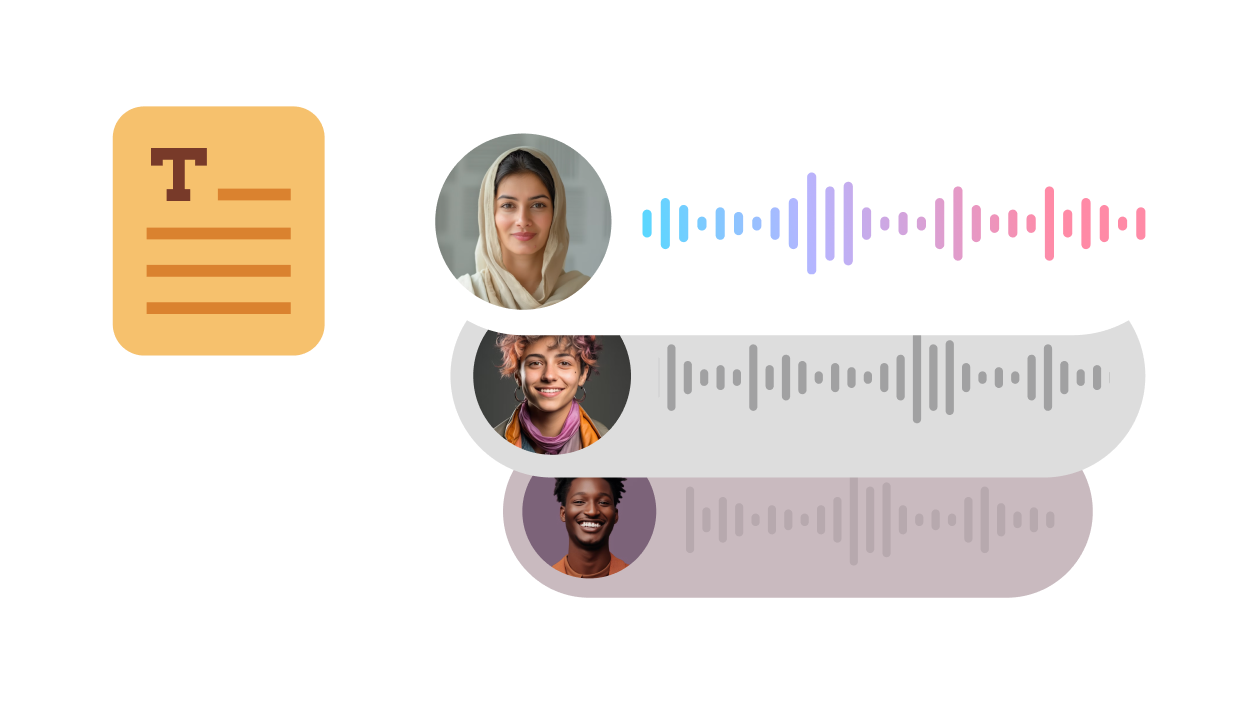
キャラクターに話させたい内容を書き、88言語の1,000+のAI音声から選ぶだけ。生成された音声に合わせて口の動きが追従します。
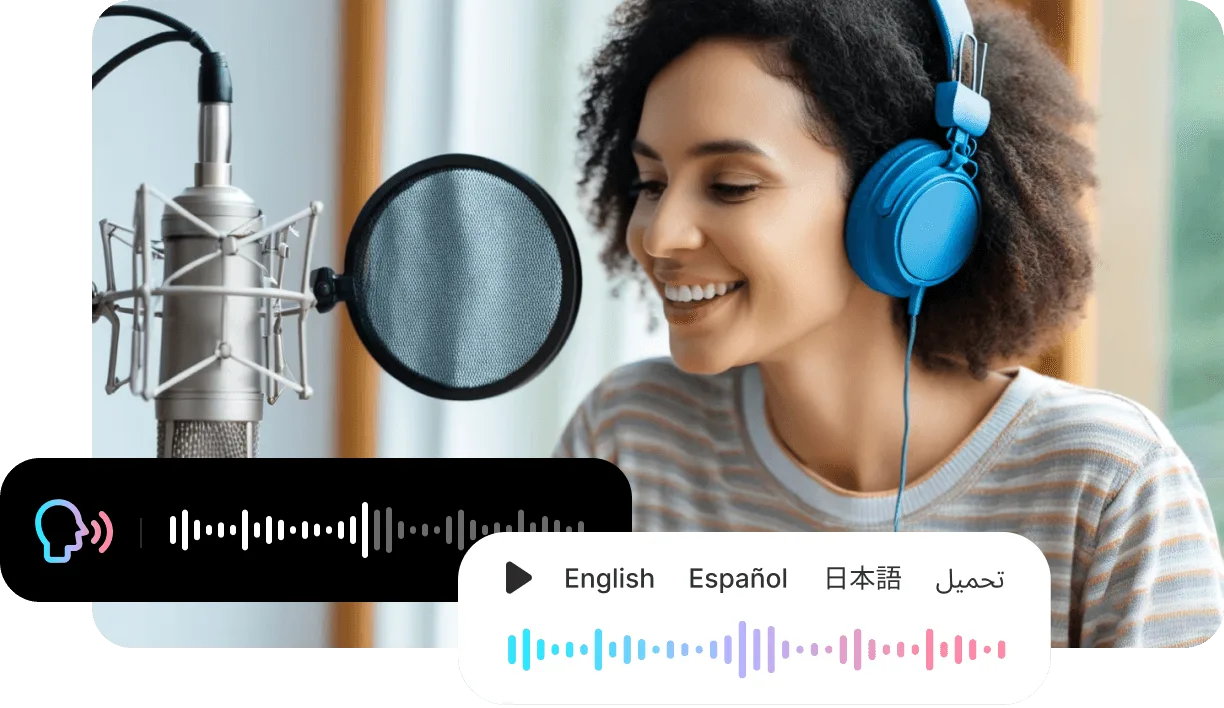
ナレーション、ポッドキャストの切り抜き、インタビューの回答、または曲を持ち込んで、その録音そのものに顔を同期します。
ブラウザで声を録音して、そのままページを離れずにリップシンク動画にできます。
同じ写真を3種類の音声トラックにリップシンク。話し方ひとつでクリップ全体が変わります — テンポ、表情、熱量が、キャラクターの話す内容に合わせて動きます。
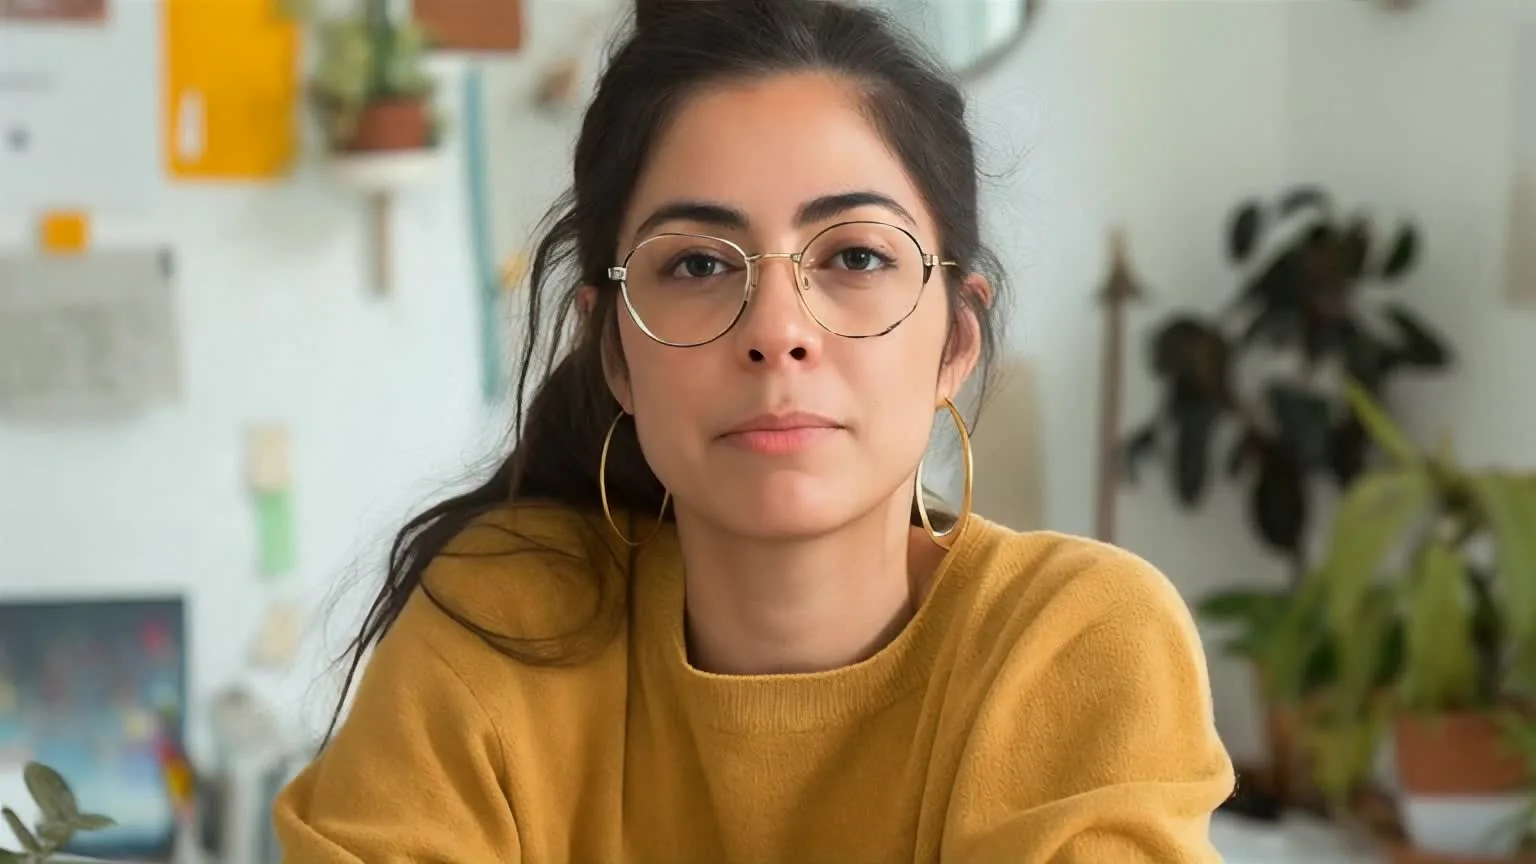
解説、アップデート、レッスンに最適。一定のテンポと安定したアイコンタクト。
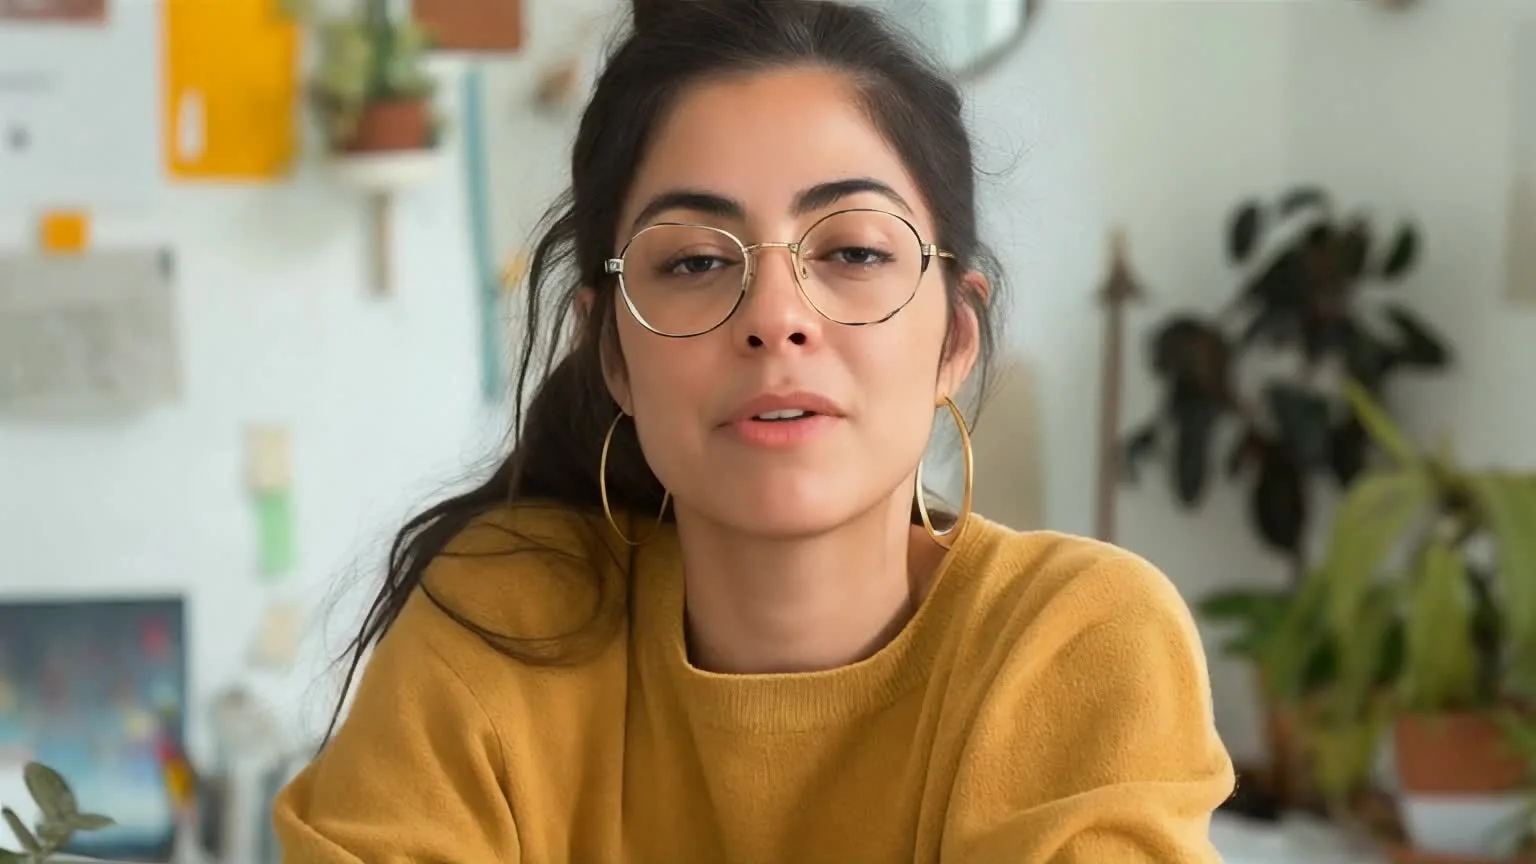
挨拶、プロモ、SNSのフックに。表情もより明るく。
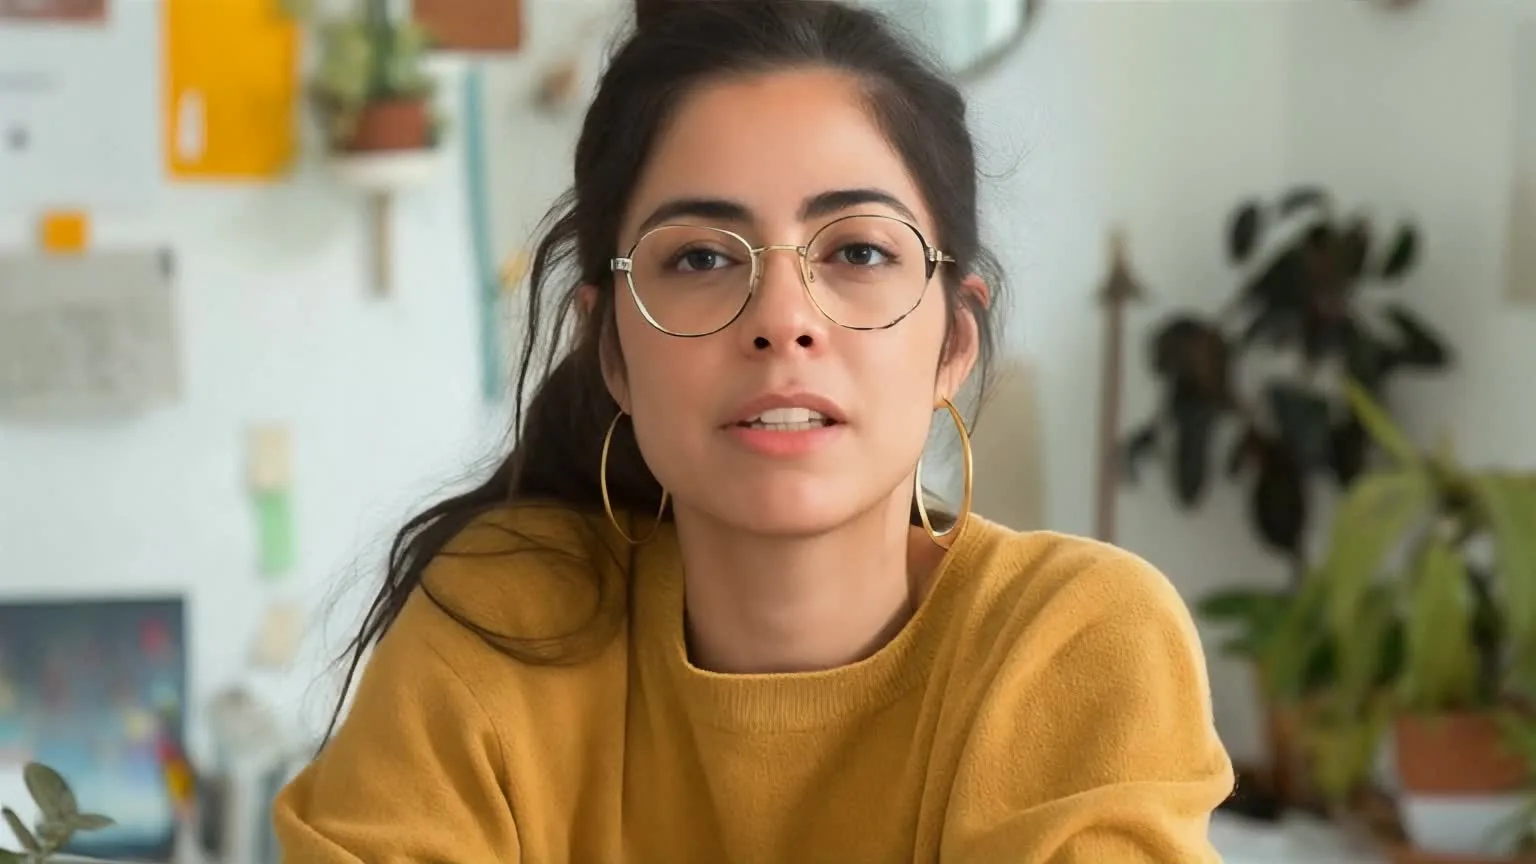
コント、リアクション、キャラクターシーンに。よりキレのある表情に。
使い方
撮影も、キーフレームも、タイムライン編集も不要 — 顔と音だけでOK。
正面を向いた鮮明な写真をアップロードするか、すぐ使えるアバターを選ぶか、テキストプロンプトから新しいキャラクターを生成します。
スクリプトを入力して音声を選ぶ、音声ファイルをアップロードする、または自分の声を録音します。
720P、1080P、または2Kを選び、動画を生成して、リップシンク結果をダウンロードします。
VisionStoryが選ばれる理由
正確な口の形はスタート地点。表情、まばたき、頭の動きまで加わるから、「アニメっぽい」ではなく「話している」感じになります。
音声の各音節に合わせて口が動くため、音量に合わせて開閉するだけではなく、言葉にしっかり「乗る」リップシンクになります。
ポートレート、イラストキャラクター、ブランドマスコット、動物、AI生成の人物まで。顔がはっきりしていれば何でもリップシンクできます。
音声をインポート/録音した場合、VisionStoryはあなたの声を保ったまま、そのタイミングに合わせて顔を同期します。別の声にしたい場合は、[声を変更]でパフォーマンスを保ちながら録音を変換できます。
インポートした録音に室内のうなりや環境ノイズがある場合は、[ノイズを除去]をオンに。音声も口の動きも、よりクリアに伝わります。
まだ録音がなくても大丈夫。88言語でスクリプトを入力し、1,000以上のAI音声から選べます。
まばたき、表情、自然な頭の動きまで同期するので、静止画が本当に話しているような人物に変わります。
SNS投稿、プレゼン、製品動画、広告向けに、720P、1080P、または2Kでレンダリングできます。
9:16、1:1、16:9でフレーミングして、Shorts、Reels、TikTok、フィード、YouTubeに再トリミングなしでぴったり合わせられます。
AIリップシンクは、キャラクターの口の動きを音声トラックに合わせる機能です。VisionStoryでは、顔(写真、イラスト、または既成のアバター)と、スクリプト入力/音声のアップロード/録音のいずれかで用意した音声を指定します。するとVisionStoryが、唇・表情・頭の動きが音に合わせて動く動画を生成します。